

Einbettungen
Leistungsstarke multimodale, mehrsprachige Langkontext-Einbettungen für Such-, RAG- und Agentenanwendungen.
Einbettungs-API
Probieren Sie unsere Embedding-Modelle aus und verbessern Sie Ihre Such- und RAG-Systeme. Starten Sie mit einer kostenlosen Testphase!
curl "https://api.jina.ai/v1/embeddings" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $JINA_API_KEY" \
  -d @- <<EOFEOF
{
  "model": null,
  "normalized": true,
  "embedding_type": "float",
  "input": [
    text_fieldsclose"Organic skincare for sensitive skin with aloe vera and chamomile: Imagine the soothing embrace of na…ing, healthy complexion.",
    text_fieldsclose"Bio-Hautpflege für empfindliche Haut mit Aloe Vera und Kamille: Erleben Sie die wohltuende Wirkung u…einen strahlenden Teint.",
    text_fieldsclose"Cuidado de la piel orgánico para piel sensible con aloe vera y manzanilla: Descubre el poder de la n…el radiante y saludable.",
    text_fieldsclose"针对敏感肌专门设计的天然有机护肤产品:体验由芦荟和洋甘菊提取物带来的自然呵护。我们的护肤产品特别为敏感肌设计,温和滋润,保护您的肌肤不受刺激。让您的肌肤告别不适,迎来健康光彩。",
    text_fieldsclose"新しいメイクのトレンドは鮮やかな色と革新的な技術に焦点を当てています: 今シーズンのメイクアップトレンドは、大胆な色彩と革新的な技術に注目しています。ネオンアイライナーからホログラフィックハイライターまで、クリエイティビティを解き放ち、毎回ユニークなルックを演出しましょう。"
    + Eingabe hinzufügen
  ]
}
EOFEOFv5-omni: Ein Embedding für alles
Text, Bild, Audio, Video – ein gemeinsamer Embedding-Raum, zwei Größen. v5-omni-small (1,6 Mrd.) ist das leistungsstärkste Open-Weight-Omni-Modell mit weniger als 2 Mrd. Parametern. v5-omni-nano (0,9 Mrd.) liefert wettbewerbsfähiges Retrieval mit unter 1 Mrd. Parametern. Beide sind byte-für-byte-kompatibel mit v5-text – eine Neuindizierung ist nicht erforderlich.
v5-Text: Neue kleine mehrsprachige SOTA-Einbettungen
jina-embeddings-v5-text bietet Einbettungsqualität der fünften Generation in zwei effizienten Größen – einem kleinen Modell mit 677 Millionen und einem Nano-Modell mit 239 Millionen – mit aufgabenspezifischen LoRA-Adaptern, Matryoshka-Dimensionen, 32K Kontext und GGUF/MLX-Quantisierung für den Einsatz am Edge und setzt damit neue Maßstäbe für MMTEB, MTEB English und Retrieval-Aufgaben.
Zwei Kaufmöglichkeiten
Abonnieren Sie unsere API oder kaufen Sie über Cloud-Anbieter.
radio_button_unchecked
cloud
Mit 3 Cloud-Service-Anbietern
Verwendet Ihr Unternehmen AWS oder Azure? Sie können unsere Modelle direkt auf der Cloud-Plattform Ihres Unternehmens einsetzen und die Abrechnung über das CSP-Konto abwickeln.
radio_button_checked

Mit Jina Search Foundation API
Der einfachste Weg, auf alle unsere Produkte zuzugreifen. Laden Sie Tokens unterwegs auf.
Laden Sie diesen API-Schlüssel mit weiteren Token auf
Bitte geben Sie zum Aufladen den richtigen API-Schlüssel ein
Verstehen Sie die Ratenbegrenzung
Ratenbegrenzungen sind die maximale Anzahl von Anfragen, die pro Minute pro IP-Adresse/API-Schlüssel (RPM) an eine API gestellt werden können. Nachfolgend erfahren Sie mehr über die Ratenbegrenzungen für jedes Produkt und jede Stufe.
keyboard_arrow_down

On-Premises-Bereitstellung
Stellen Sie Jina Embeddings-Modelle in AWS SageMaker und Microsoft Azure und bald auch in Google Cloud Services bereit, oder wenden Sie sich an unser Vertriebsteam, um angepasste Kubernetes-Bereitstellungen für Ihre Virtual Private Cloud und Ihre lokalen Server zu erhalten.
 AWS SageMaker
 Einbettungen
 Reranker
 Microsoft AzureEinbettungenReranker
 Google CloudEinbettungen

API-Integrationen
Unsere Einbettungs-API ist nativ in verschiedene renommierte Datenbanken, Vektorspeicher, RAG- und LLMOps-Frameworks integriert. Kopieren Sie zunächst einfach Ihren API-Schlüssel und fügen Sie ihn in eine der aufgeführten Integrationen ein, um einen schnellen und reibungslosen Start zu ermöglichen.
Vector Store
LLMOps
RAG
Observability

MongoDB

DataStax

Qdrant

Pinecone

Chroma

Weaviate
Milvus

Epsilla

MyScale

LlamaIndex

Haystack

Langchain

Dify

SuperDuperDB
%20rotate(-89.93)'/%3e%3crect%20class='cls-1'%20x='30.52'%20y='10.19'%20width='3'%20height='47.42'%20transform='translate(-13.3%2044.91)%20rotate(-60.3)'/%3e%3ccircle%20id='_椭圆形'%20class='cls-1'%20cx='28.91'%20cy='31.28'%20r='5'/%3e%3cpolygon%20class='cls-1'%20points='42.43%2030.75%2035.08%2029.1%2036.37%2021.5%2039.33%2022.01%2038.51%2026.8%2043.09%2027.82%2042.43%2030.75'/%3e%3cpolygon%20class='cls-1'%20points='16.75%2045.55%209.43%2043.77%2010.86%2036.19%2013.8%2036.75%2012.9%2041.53%2017.46%2042.63%2016.75%2045.55'/%3e%3cpolygon%20class='cls-1'%20points='11.02%2028.19%209.54%2020.8%2017.01%2018.89%2017.75%2021.8%2013.04%2023%2013.96%2027.6%2011.02%2028.19'/%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
DashVector
Portkey

Baseten

TiDB
LanceDB

Carbon
Unsere Veröffentlichungen
Erfahren Sie, wie unsere bahnbrechenden Suchmodelle von Grund auf trainiert wurden, und werfen Sie einen Blick auf unsere neuesten Veröffentlichungen. Treffen Sie unser Team auf der EMNLP, SIGIR, ICLR, NeurIPS und ICML!
 arXiv
September 02, 2026
 arXiv
Juli 20, 2026
SIGIR 2026
Mai 11, 2026
SIGIR 2026
Februar 17, 2026

ICLR 2026
Januar 22, 2026
 arXiv
Dezember 29, 2025
ICLR 2026
Dezember 04, 2025
AAAI 2026
Oktober 01, 2025
NeurIPS 2025
August 31, 2025
EMNLP 2025
Juni 24, 2025
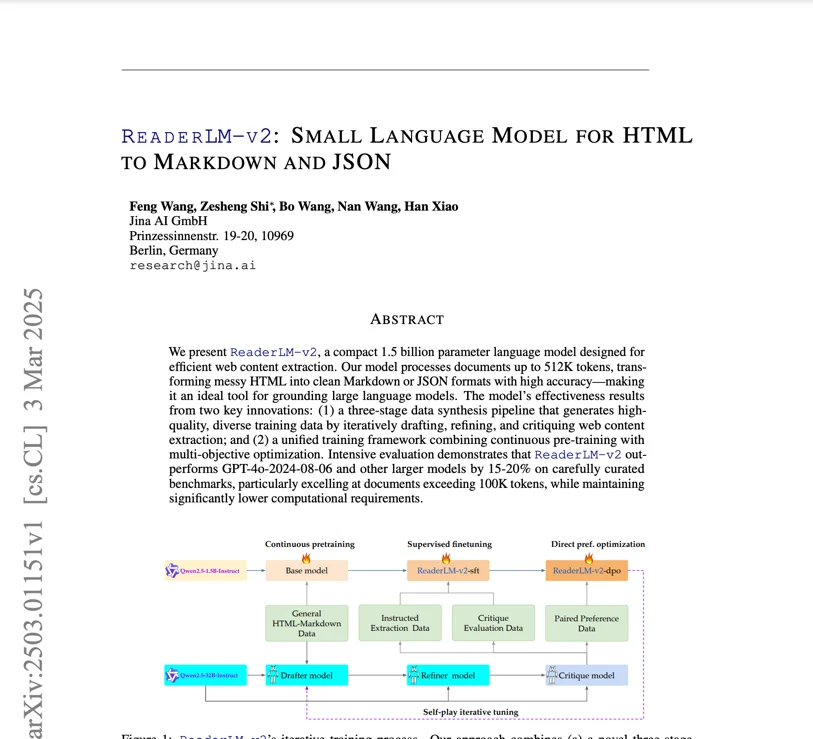
ICLR 2025
März 04, 2025
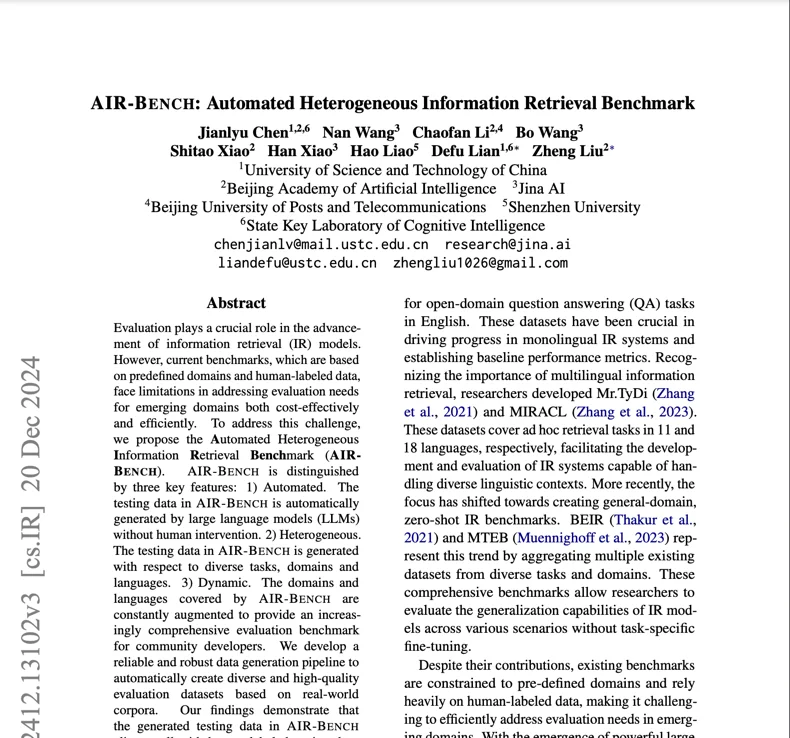
ACL 2025
Dezember 17, 2024
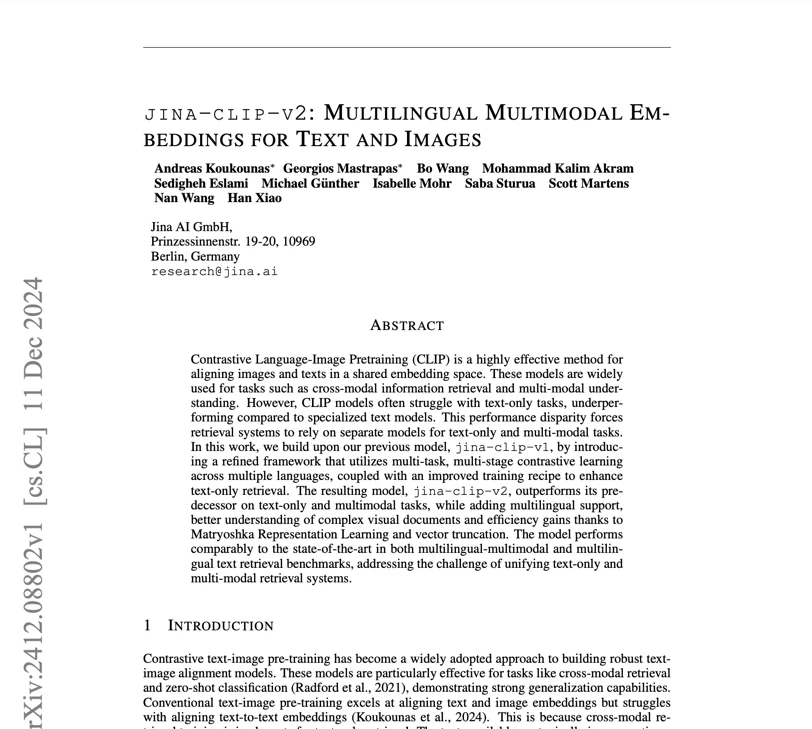
ICLR 2025
Dezember 12, 2024
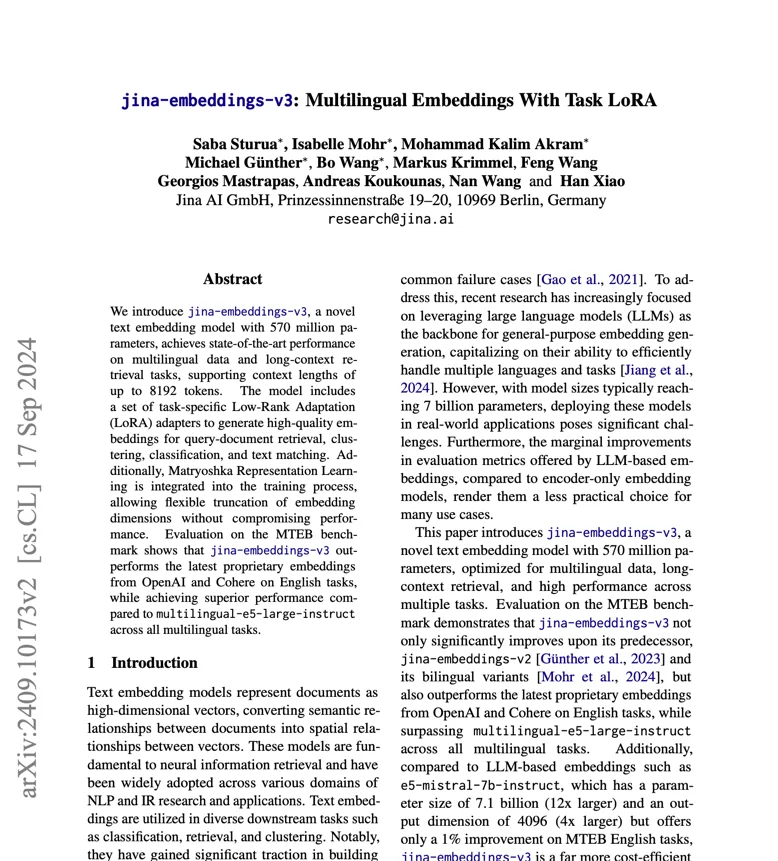
ECIR 2025
September 18, 2024
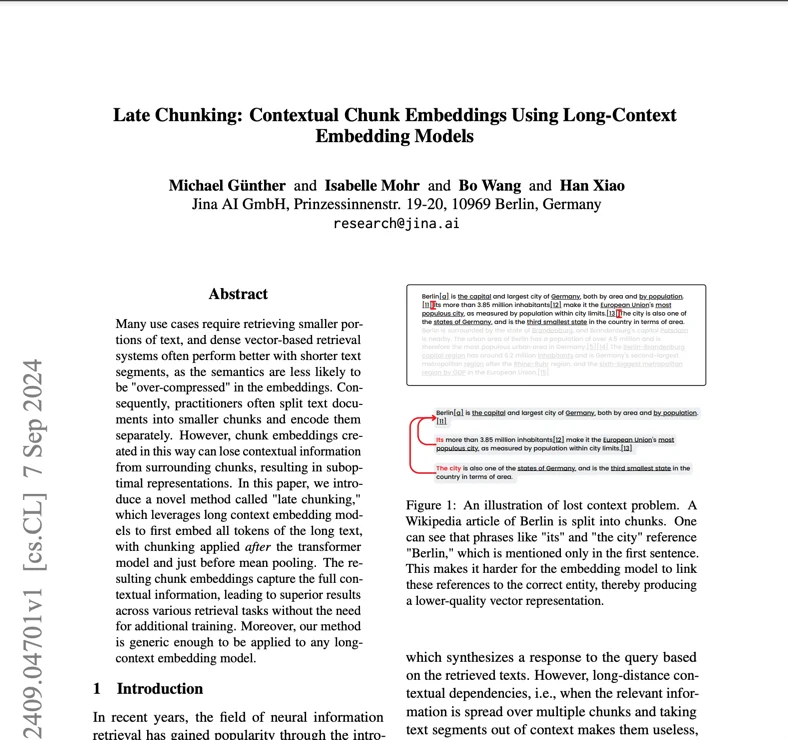
SIGIR 2025
September 07, 2024
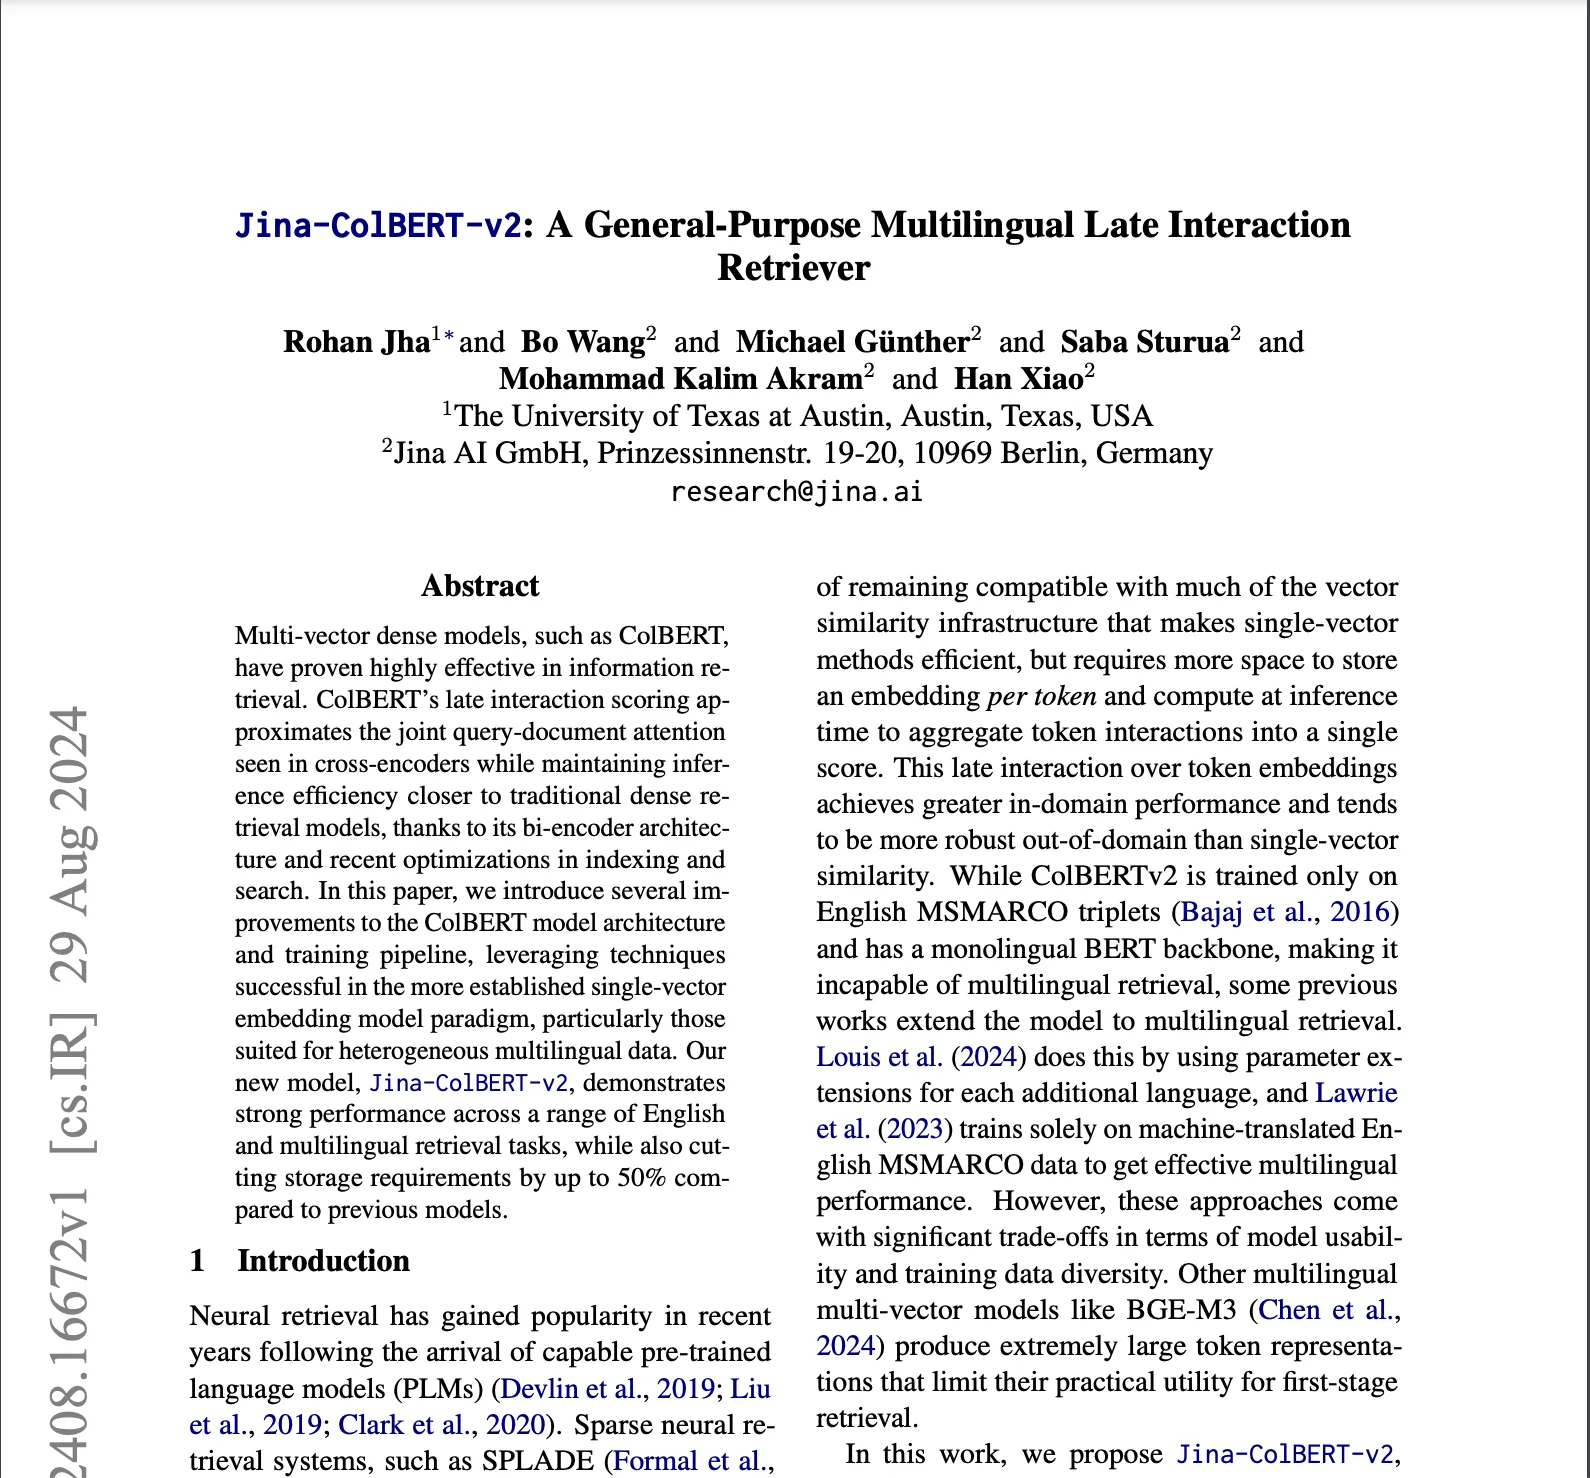
EMNLP 2024
August 30, 2024
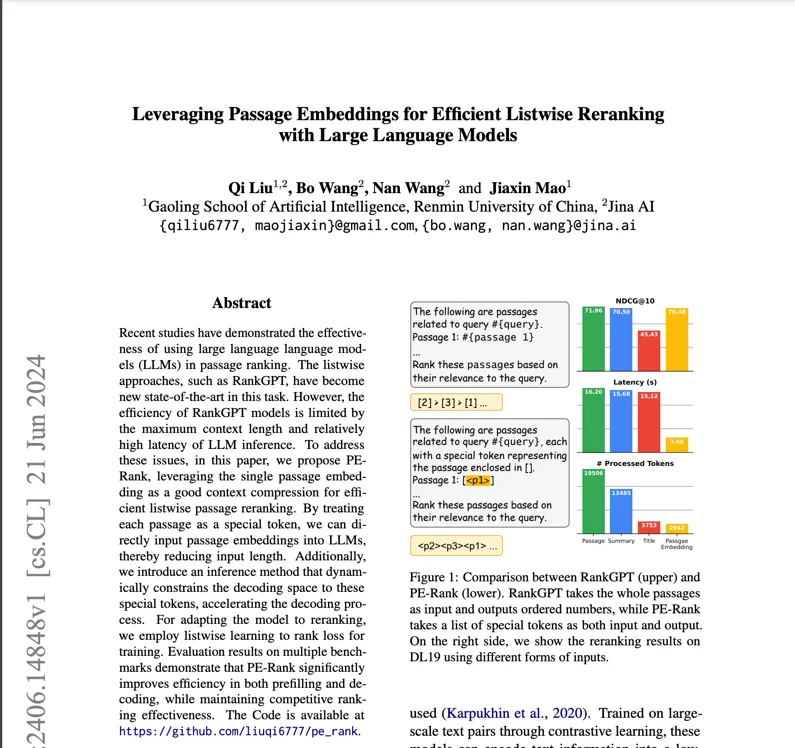
WWW 2025
Juni 21, 2024
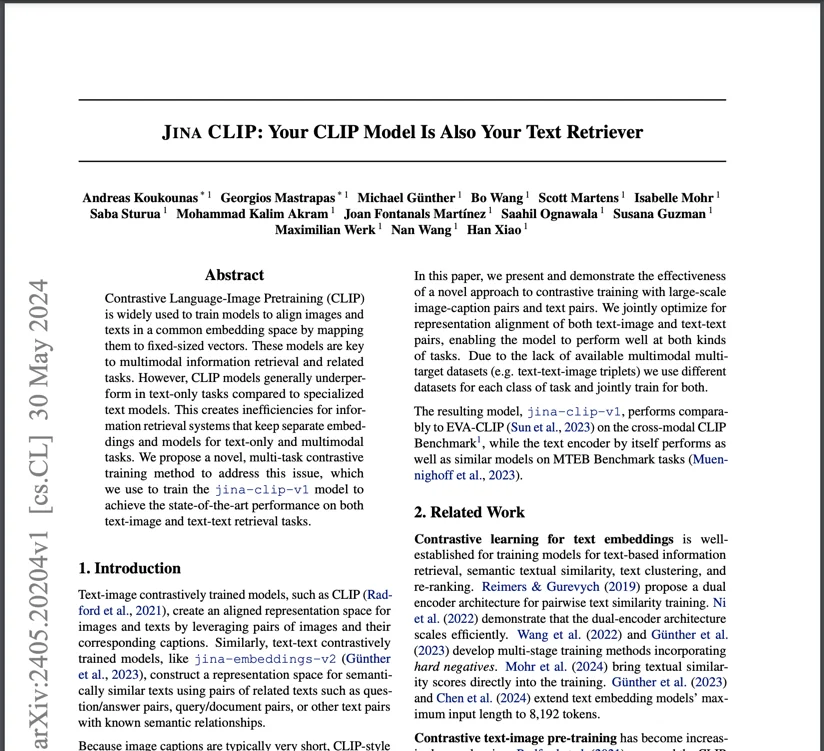
ICML 2024
Mai 30, 2024
 arXiv
Februar 26, 2024
 arXiv
Oktober 30, 2023

EMNLP 2023
Juli 20, 2023
21 Veröffentlichungen insgesamt.
Erfahren Sie mehr über Einbettungen
Wo soll man mit Einbettungen anfangen? Wir helfen Ihnen weiter. Erfahren Sie in unserem umfassenden Leitfaden alles über Einbettungen von Grund auf.


Vergleich von Reranker, Vector Search und BM25
Die folgende Tabelle bietet einen umfassenden Vergleich von Reranker, Vector/Embeddings Search und BM25 und hebt deren Stärken und Schwächen in verschiedenen Kategorien hervor.
| Reranker | Vektorsuche | BM25 | |
|---|---|---|---|
| Beste für | Verbesserte Suchpräzision und Relevanz | Erste, schnelle Filterung | Allgemeine Textsuche für weitreichende Abfragen |
| Granularität | Detailliert: Unterdokument und Abfragesegment | Breit: Ganze Dokumente | Mittelstufe: Verschiedene Textsegmente |
| Komplexität der Abfragezeit | Hoch | Mittel | Niedrig |
| Zeitkomplexität indizieren | Nicht benötigt | Hoch | Niedrig, nutzt vorgefertigten Index |
| Komplexität der Trainingszeit | Hoch | Hoch | Nicht benötigt |
| Suchqualität | Hervorragend für differenzierte Abfragen | Ausgewogen zwischen Effizienz und Genauigkeit | Konsistent und zuverlässig für eine breite Palette von Abfragen |
| Stärken | Sehr präzise mit tiefem Kontextverständnis | Schnell und effizient, mit mäßiger Genauigkeit | Hoch skalierbar, mit nachgewiesener Wirksamkeit |
| Testen Sie die Reranker-API kostenlos | Probieren Sie die Einbettungs-API kostenlos aus |
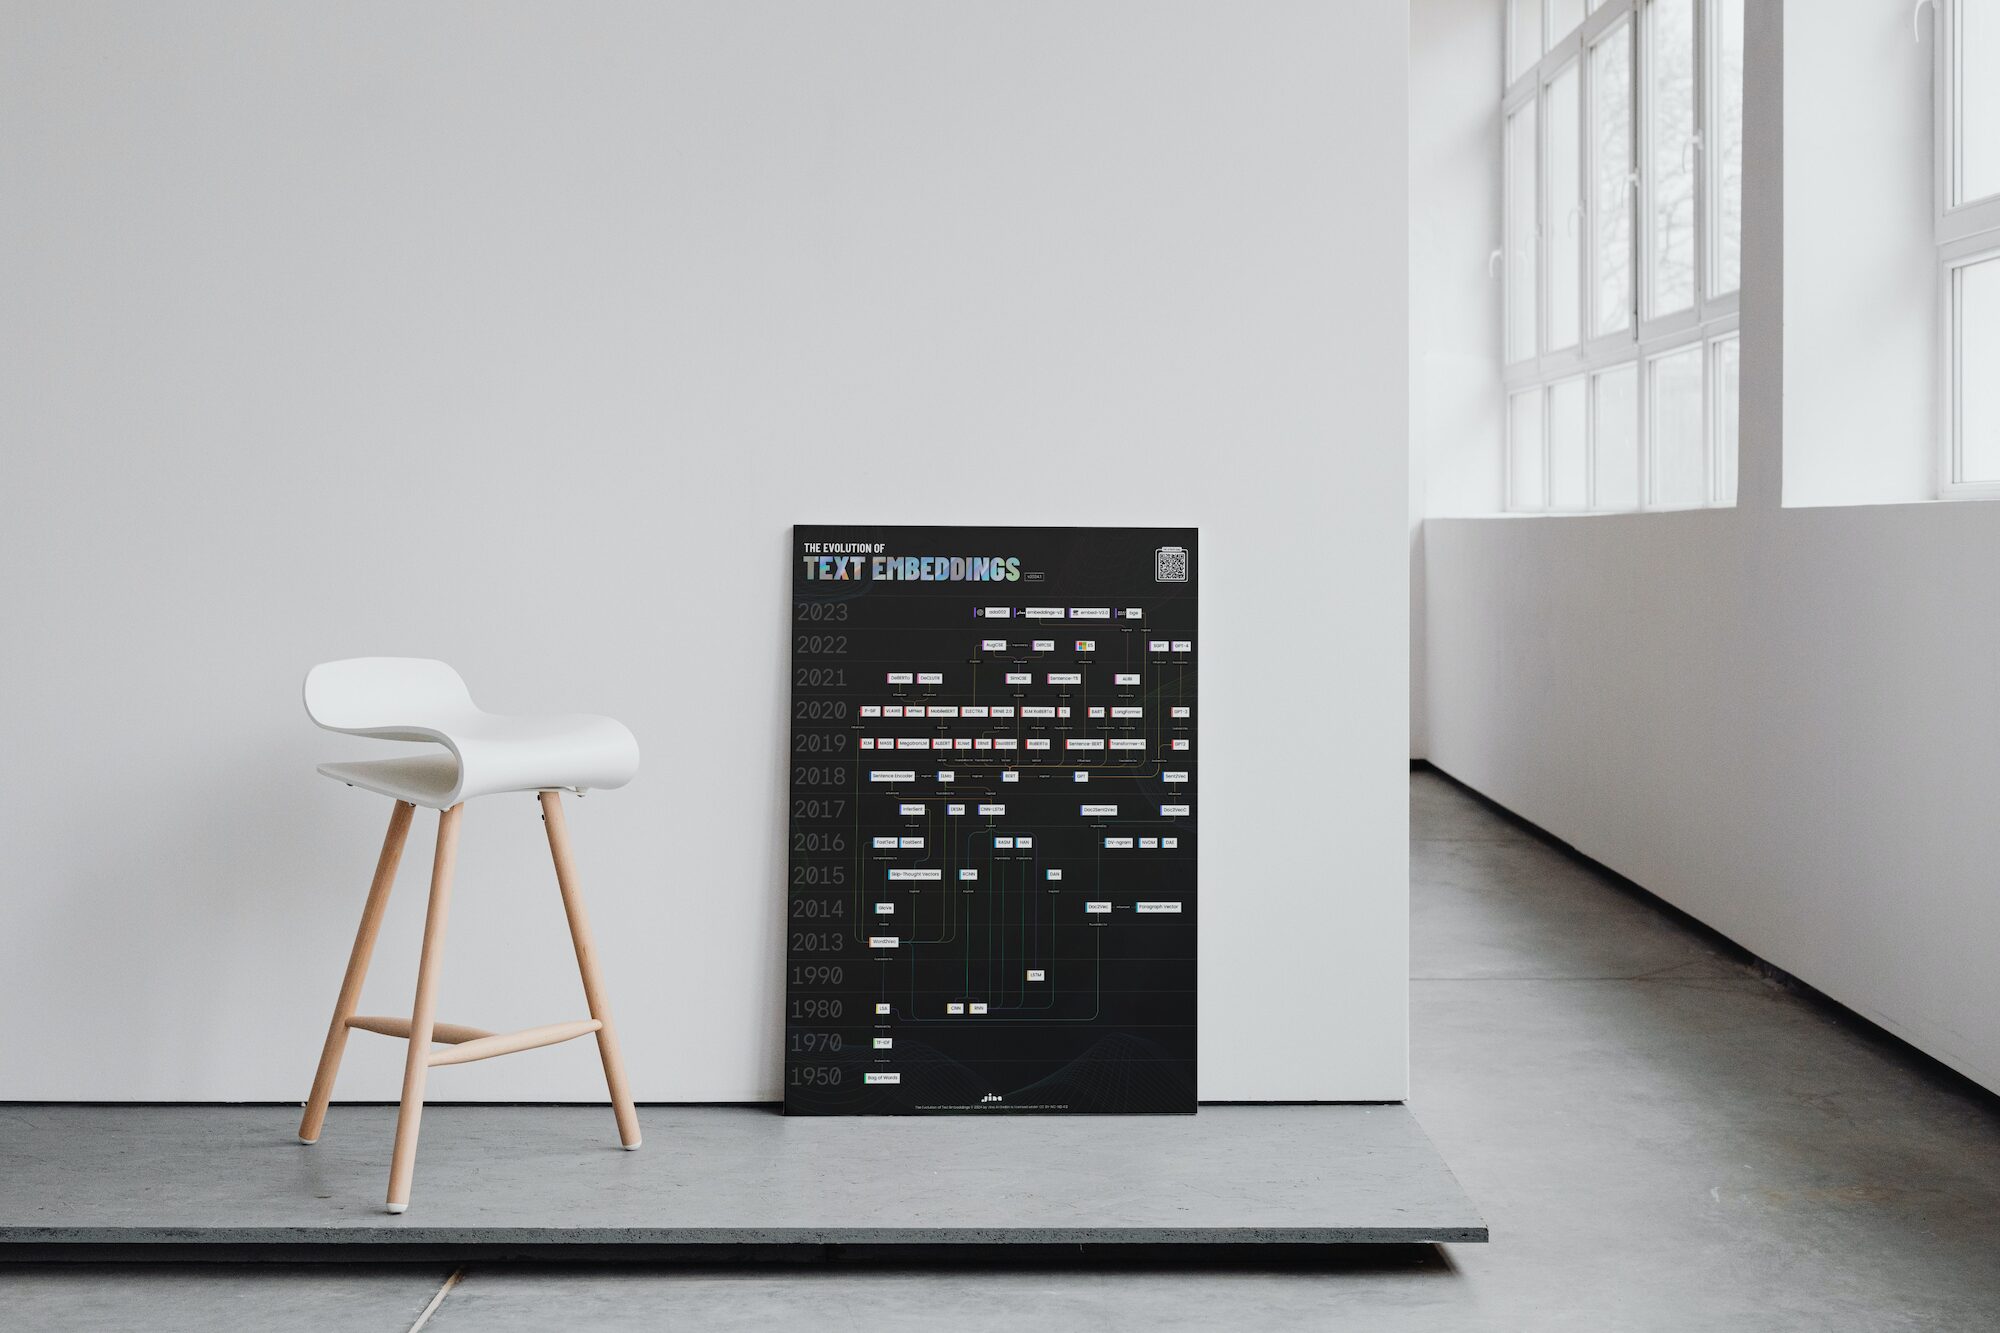
Die Evolution des Einbettungsplakats
Entdecken Sie das ideale Poster für Ihren Raum mit fesselnden Infografiken oder atemberaubenden Bildern, die die Entwicklung der Texteinbettungsmodelle seit 1950 nachzeichnen.
Wie wurden die Jina-Einbettungsmodelle trainiert?
keyboard_arrow_down
Welche multimodalen Einbettungsmodelle verwenden Sie?
keyboard_arrow_down
Welche Sprachen unterstützen Ihre Modelle?
keyboard_arrow_down
Was ist die maximale Kontextlänge für eine einzelne Eingabe?
keyboard_arrow_down
Wie viele Eingaben kann ich maximal in eine einzelne Anfrage einbeziehen?
keyboard_arrow_down
Wie kann ich Bilder, Audio-, Video- oder PDF-Dateien an die multimodalen Modelle senden?
keyboard_arrow_down
Wie schneiden Jina-Embeddings im Vergleich zu den neuesten OpenAI-, Cohere- und Voyage-Modellen ab?
keyboard_arrow_down
Wie nahtlos ist der Übergang von OpenAIs Text-Embedding-3-Large zu Ihrer Lösung?
keyboard_arrow_down
Wie werden Tokens für Bilder und andere Nicht-Text-Eingaben berechnet?
keyboard_arrow_down
Bieten Sie Modelle zum Einbetten von Bildern, Audio oder Video an?
keyboard_arrow_down
Können Jina-Embedding-Modelle anhand von privaten oder Firmendaten feinabgestimmt werden?
keyboard_arrow_down
Können die Modelle privat, auf meiner eigenen Infrastruktur oder in meinem eigenen Cloud-Konto gehostet werden?
keyboard_arrow_down
Was ist der Parameter „task“ und wann sollte ich ihn verwenden?
keyboard_arrow_down
Was versteht man unter „Late-Interaction Retrieval“ und welche Modelle unterstützen es?
keyboard_arrow_down
Was ist Late Chunking und wann sollte ich es anwenden?
keyboard_arrow_down
Warum erzwingt die API eine andere Kontextlänge als die vom Modell unterstützte?
keyboard_arrow_down
Warum ist jina-embeddings-v4 kostenlos und warum ist es langsam?
keyboard_arrow_down
Welche Ratenbegrenzungen gelten für die Embeddings API?
keyboard_arrow_down
Welches Einbettungsmodell sollte ich wählen?
keyboard_arrow_down
Welche Dateigrößenbeschränkungen gelten für Bilder und PDFs?
keyboard_arrow_down
Ratenbegrenzung
Ratenlimits werden auf zwei Arten erfasst: RPM (Anfragen pro Minute) und TPM (Token pro Minute). Die Limits werden pro IP/API-Schlüssel erzwungen und ausgelöst, wenn zuerst der RPM- oder TPM-Schwellenwert erreicht wird. Wenn Sie im Request-Header einen API-Schlüssel angeben, erfassen wir die Ratenlimits pro Schlüssel und nicht nach IP-Adresse.
| Produkt | API-Endpunkt | Beschreibungarrow_upward | ohne API-Schlüsselkey_off | mit kostenlosem API-Schlüsselkey | mit kostenpflichtigem API-Schlüsselkey | mit Premium-API-Schlüsselkey | Durchschnittliche Latenz | Zählung der Token-Nutzung | Zulässige Anfrage | |
|---|---|---|---|---|---|---|---|---|---|---|
| Reader-API | https://r.jina.ai | URL in LLM-freundlichen Text konvertieren | 20 RPM | 500 RPM | 500 RPM | trending_up5000 RPM | 7.9s | Anzahl der Token in der Ausgabeantwort zählen | GET/POST | |
| Reader-API | https://s.jina.ai | Das Web durchsuchen und die Ergebnisse in LLM-freundlichen Text konvertieren | block | 100 RPM | 100 RPM | trending_up1000 RPM | 2.5s | Jede Anfrage kostet eine feste Anzahl an Token, beginnend bei 10.000 Token | GET/POST | |
| Einbettungs-API | https://api.jina.ai/v1/embeddings | Text/Bilder in Vektoren mit fester Länge konvertieren | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart hängt von der Eingangsgröße ab help | Anzahl der Token in der Eingabeanforderung zählen | POST | |
| Reranker-API | https://api.jina.ai/v1/rerank | Dokumente nach Abfrage ordnen | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart hängt von der Eingangsgröße ab help | Anzahl der Token in der Eingabeanforderung zählen | POST |
CC BY-NC Lizenz Selbstcheck
play_arrow
Nutzen Sie unsere gehostete API oder unsere offiziellen Images auf Azure, AWS oder GCP?
play_arrow
Ja
play_arrow
NEIN
Häufige Fragen zu APIs
code
Kann ich denselben API-Schlüssel für alle Jina-APIs verwenden?
keyboard_arrow_down
code
Kann ich die Token-Nutzung meines API-Schlüssels überwachen?
keyboard_arrow_down
code
Was soll ich tun, wenn ich meinen API-Schlüssel vergesse?
keyboard_arrow_down
code
Laufen API-Schlüssel ab?
keyboard_arrow_down
code
Kann ich Token zwischen API-Schlüsseln übertragen?
keyboard_arrow_down
code
Kann ich meinen API-Schlüssel widerrufen?
keyboard_arrow_down
code
Warum ist die erste Anfrage für einige Modelle langsam?
keyboard_arrow_down
code
Werden meine API-Daten zum Trainieren Ihrer Modelle verwendet?
keyboard_arrow_down
code
Welche Ratenbegrenzungen gelten für Jina-APIs?
keyboard_arrow_down
code
Gibt es Beschränkungen hinsichtlich der Batchgröße für die APIs?
keyboard_arrow_down
code
Sind die Jina-APIs dasselbe wie die Jina-Modelle innerhalb von Elastic?
keyboard_arrow_down
Häufige Fragen zur Abrechnung
attach_money
Erfolgt die Abrechnung nach der Anzahl der Sätze bzw. Anfragen?
keyboard_arrow_down
attach_money
Gibt es eine kostenlose Testversion für neue Benutzer?
keyboard_arrow_down
attach_money
Werden für fehlgeschlagene Anfragen Token berechnet?
keyboard_arrow_down
attach_money
Welche Zahlungsmethoden werden akzeptiert?
keyboard_arrow_down
attach_money
Ist eine Rechnungsstellung für Token-Käufe verfügbar?
keyboard_arrow_down
attach_money
Wie kann ich eine kommerzielle Lizenz anstelle von API-Tokens erwerben?
keyboard_arrow_down
attach_money
Kann ich per Rechnung oder Bestellschein statt per Karte bezahlen?
keyboard_arrow_down
attach_money
Ich habe bezahlt, aber mein Kontostand oder mein Ratenlimit hat sich nicht geändert. Was sollte ich überprüfen?
keyboard_arrow_down
attach_money
Wie kann ich eine Zahlung stornieren, die automatische Aufladung stoppen oder eine gespeicherte Zahlungsmethode entfernen?
keyboard_arrow_down
