Reader
LM-v2
 Reader-API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-Gapped
Überblick
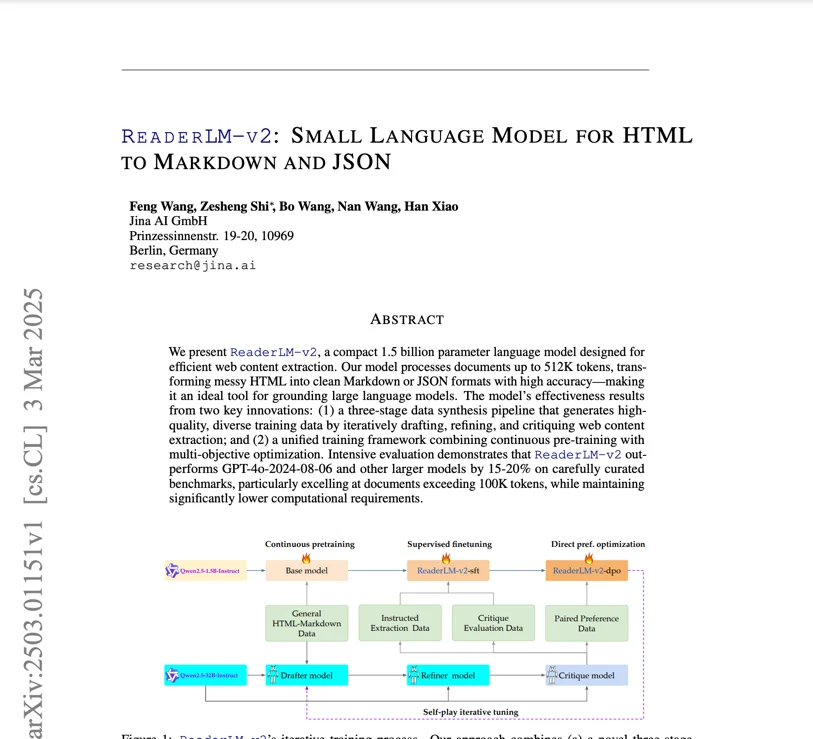
ReaderLM-v2 ist ein kleines Sprachmodell mit 1,54B Parametern, das unordentliches HTML mit hoher Genauigkeit in sauberes Markdown oder JSON umwandelt und Dokumente bis 512K Token verarbeitet. Es ist das ideale Werkzeug für das Grounding großer Sprachmodelle: Webinhalte in strukturierte Formate umwandeln, die LLMs effizient verarbeiten können. Das Modell übertrifft Qwen2.5-32B-Instruct und Gemini2-flash-expr bei HTML-zu-Markdown-Aufgaben und läuft dabei zu einem Bruchteil der Kosten.
Methoden
Die Wirksamkeit des Modells beruht auf zwei Schlüsselinnovationen. Erstens erzeugt eine dreistufige Datensynthese-Pipeline qualitativ hochwertige, vielfältige Trainingsdaten, indem sie die Extraktion von Webinhalten iterativ entwirft, verfeinert und kritisch hinterfragt – dieser synthetische Ansatz stellt sicher, dass das Modell eine breite Vielfalt an HTML-Strukturen sieht, ohne manuelle Annotation zu benötigen. Zweitens kombiniert ein einheitlicher Trainingsrahmen kontinuierliches Pretraining mit Multi-Objective-Optimierung, sodass das Modell sowohl HTML-zu-Markdown- als auch HTML-zu-JSON-Konvertierung gleichzeitig lernt. Die Decoder-Only-Architektur nach dem Prinzip „flach, aber breit“ (28 Schichten, 1536 Hidden-Dimensionen, 12 Query-Heads, 2 KV-Heads) ist für selektive Kopiervorgänge optimiert. Der 512K-Token-Kontext wird durch Zigzag-Ring-Attention ermöglicht. Training mit kontrastivem Loss reduziert Degenerationsprobleme erheblich.
Leistung
Auf HTML-zu-Markdown-Aufgaben erreicht das Modell einen ROUGE-L-Wert von 0,84, einen Jaro-Winkler-Wert von 0,82 und eine Levenshtein-Distanz von 0,22 – besser als Qwen2.5-32B-Instruct und Gemini2-flash-expr. Bei HTML-zu-JSON-Aufgaben bleibt die Performance wettbewerbsfähig, mit F1-Werten von 0,81 und einer Pass-Rate von 98 %. Das Modell verarbeitet 67 Token/s Eingabe und 36 Token/s Ausgabe auf einer T4-GPU. Degenerationsprobleme (Token-Loops, repetitive Ausgabe) werden durch Training mit kontrastivem Loss deutlich reduziert. Das 512K-Token-Kontextfenster macht Chunking bei den meisten realen Dokumenten überflüssig.
Empfehlungen
Das Modell ist über ein Google-Colab-Notebook zugänglich, das HTML-zu-Markdown-Konvertierung, JSON-Extraktion und Instruction-Following demonstriert. Für HTML-zu-Markdown-Aufgaben rohes HTML ohne Präfix-Anweisungen eingeben. Für JSON-Extraktion das Zielschema im Prompt angeben. Die create_prompt-Hilfsfunktion erleichtert die Prompt-Erstellung für beide Aufgaben. Das Modell läuft auf dem kostenlosen T4-GPU-Tarif von Colab (erfordert vllm und triton), hat aber ohne bfloat16- oder Flash-Attention-2-Unterstützung Einschränkungen; für Produktion wird RTX 3090/4090 empfohlen. Verfügbar über AWS SageMaker sowie die Marktplätze von Azure und GCP. Lizenziert unter CC BY-NC 4.0 für nichtkommerzielle Nutzung. Verwenden Sie das Modell als Preprocessing-Schritt in RAG-Pipelines, um Webinhalte vor dem Embedding mit jina-embeddings-v5-text-small in sauberes Markdown zu konvertieren.