Elastic
Jina AI
Modelle
API
keyboard_arrow_down
Reader
Konvertieren Sie jede URL in Markdown für besseres Grounding von LLMs.
Einbettungen
Multimodale, mehrsprachige Einbettungen.
Reranker
Reranker zur Maximierung der Suchrelevanz.
MCP
terminal
CLI
article
llms.txt
smart_toy
Agenten
data_object
Schema
menu_book
Dokumentation
Einloggen
login
warning
Dieses Modell wird durch neuere Modelle ersetzt.
Einbettungen
Apache 2.0 Lizenz
open_in_new Release-Post

jina-clip-v1

Multimodale Einbettungsmodelle für Bilder und englischen Text
Lizenz
Apache-2.0
Veröffentlichungsdatum
calendar_month
2024-06-05
Eingabe
image
Bild
abc
Text
arrow_forward
Ausgabe
more_horiz
Vektor
Modelldetails
Parameter: 223M
Länge des Eingabetokens: 8K
Eingabebildgröße: 224×224
Ausgabedimension: 768
Basismodell help_outline
open_in_new
EVA02-B-16
link
jina-embeddings-v2-base-en
Ausgebildete Sprachen help_outline
1 Sprachen
Ähnliche Modelle
link
jina-clip-v2
link
jina-embeddings-v3
link
jina-colbert-v2
Erhältlich über
Jina-API
AWS SageMaker
Microsoft Azure
Hugging Face
Air-Gapped
E/A-Diagramm 1

Text

jina-clip-v1

Vektor

E/A-Diagramm 2

Bild

jina-clip-v1

Vektor

Pareto-Front help_outline
workspace_premium
MTEB English
ViDoRe v1
MIEB
CLIP Benchmark
CLIP Benchmark · t2i-recall@5
chevron_leftchevron_right
300M1B3.0B10B20406080100bge-visualized-m3BiModernVBERTDSE-Phi3dse-qwen2-2b-mrl-v1e5-vjina-clip-v2jina-embeddings-v3jina-embeddings-v4llama-nemoretriever-col…MoCa-3Bnemotron-colembed-vl-8b…nllb-siglip-largeONE-PEACESauerkrautLM-ColLFM2-45…SauerkrautLM-ColMinistr…siglip-so400m-patch14-3…SigLIP2-L-512/16VLM2VecVultronRetrieverFlash-Q…jina-clip-v1Parameter (log)nDCG@5
Dieses Modell
Auf der Front
Jina AI
Andere
ViDoRe v1
17.72
Parameter
223M
Rang nach Score
32 / 33
Pareto-Front
Darauf
Werteverteilunghelp_outline
AUC 0.8440
Korpus
Übersetzungspaare
Dokumentensuche
Bild / Banner
0.6750.000.200.400.600.80
Verwandt20.2%
Hartes Negativ3.2%
Unverwandt1.2%
Empfohlene Schwellenwerte
FPR 0.1 · 0.478
FPR 0.01 · 0.675
FPR 0.001 · 0.785
FPR 0.0001 · 0.823
ausgewogen · 0.376
AUC
0.8440
Rauschgrenze
0.779
Recall-Kante
0.123
Gemessene Paare
119 / 11k
Vektorkomponentenhelp_outline
-0.18-0.010.15
σ 0.0361 · 183k Werte
Einbettungsgeometriehelp_outline
0768
Mittelwert je Dimension, für den Bereich überfahren
Rauschboden
0.283
Effektive Dim.
55 / 768
Wählen Sie Modelle zum Vergleichen aus
Publikationen (1)
ICML 2024
Mai 30, 2024
Jina CLIP: Your CLIP Model Is Also Your Text Retriever

Überblick

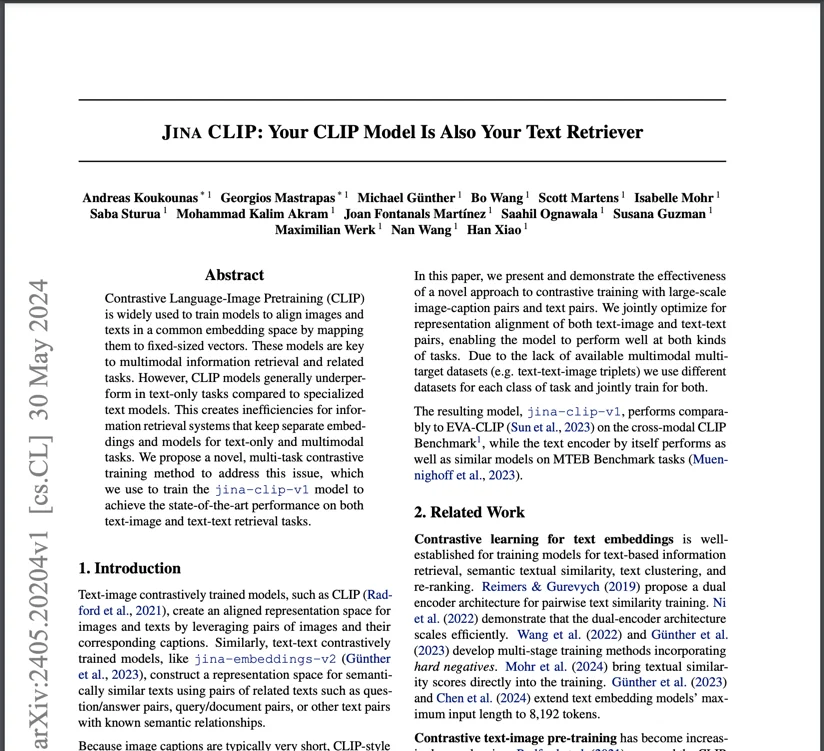
jina-clip-v1 ist ein multimodales Embedding-Modell mit 223M Parametern, das state-of-the-art-Performance bei Text-zu-Text- und Text-zu-Bild-Retrieval erreicht — das erste Modell der CLIP-Familie, dem das gelingt. Im Gegensatz zu Standard-CLIP-Modellen, die reines Text-Retrieval für die multimodale Ausrichtung opfern, nutzt jina-clip-v1 Multi-Task-Kontrast-Training, um starke Performance in allen Retrieval-Kombinationen zu halten. Es unterstützt einen Textkontext von 12.288 Tokens — das 100-Fache der 77-Token-Grenze des originalen CLIP.

Methoden

Die Architektur kombiniert einen angepassten Jina-BERT-v2-Text-Encoder (12.288 Tokens dank ALiBi) mit dem EVA-02-Bild-Encoder der Beijing Academy for AI. Die Schlüsselinnovation ist die Multi-Task-Kontrast-Trainingsmethode: Das Modell wird gleichzeitig auf (1) Bild-Beschriftungs-Paaren für die multimodale Ausrichtung, (2) Text-Text-Paaren zur Erhaltung der reinen Text-Retrieval-Qualität und (3) längeren, KI-generierten Textbeschreibungen von Bildern für Robustheit gegenüber variierenden Textlängen trainiert. Eine letzte Stufe verwendet harte negative Text-Triplets, um semantische Unterscheidungen zu schärfen. Dieser Multi-Task-Ansatz verhindert das katastrophale Vergessen von Text-Retrieval, das standardmäßiges CLIP-Training plagt. Der Bild-Encoder verarbeitet 224×224-Pixel-Kacheln, wobei jede Kachel 1.000 Tokens Verarbeitungskapazität verbraucht.

Leistung

Beim reinen Text-Retrieval erreicht das Modell eine 165-prozentige Leistungssteigerung gegenüber OpenAI CLIP (0,429 vs. 0,162 auf MTEB). Für Bildaufgaben: 2 % besser im Text-zu-Bild-Retrieval (0,899), 6 % im Bild-zu-Text-Retrieval (0,803) und 12 % im Bild-zu-Bild-Retrieval (0,916). Bei der Zero-Shot-Bildklassifikation (CIFAR-100) übertrifft es Standard-CLIP. Die multimodale Performance auf Flickr8k/30k und MSCOCO Captions ist mit spezialisierten Einzelmodalitäts-Modellen vergleichbar. Der 12.288-Token-Textkontext ist ein großer Vorteil für die Suche in umfangreichen Textdokumenten neben Bildern. 2026 wird dieses Modell durch jina-clip-v2 mit 89 Sprachen und 512×512-Bildverarbeitung abgelöst.

Anleitung

Das Modell verarbeitet Bilder in 224×224-Pixel-Kacheln; jede Kachel verbraucht 1.000 Tokens. Ein 750×500-Pixel-Bild benötigt 12 Kacheln (12.000 Tokens). Text benötigt etwa 1,1 Tokens pro Wort. Planen Sie Token-Budgets entsprechend für multimodale Anfragen. Das Modell unterstützt derzeit nur Englisch — für mehrsprachige Anwendungen jina-clip-v2 verwenden. Verfügbar über die Jina Embeddings API und als Open-Source-Veröffentlichung auf Hugging Face unter der Apache-2.0-Lizenz. Für Produktionsumgebungen bieten AWS Marketplace und Azure-Deployment-Optionen optimierte Infrastruktur. Für multimodale Vergleiche Cosine-Ähnlichkeit verwenden. Für neue multimodale Projekte jina-clip-v2 (89 Sprachen, 512×512-Bilder, MRL-Unterstützung) oder jina-embeddings-v4 (32K-Kontext, Multi-Vektor-Modus, Code-Unterstützung) bevorzugen.

Blogs, die dieses Modell erwähnen
Juni 25, 2025 • 12 Minuten gelesen
Jina Embeddings v4: Universelle Vektor Modelle (Embeddings) für Multimodale, Mehrsprachige Suche
Jina Embeddings v4 ist ein universelles 向量模型 (Embeddings)-Modell mit 3,8 Milliarden Parametern für multimodale und mehrsprachige Suche, das sowohl Single-Vektor- als auch Multi-Vektor-Embedding-Ausgaben unterstützt.
Jina AI
Word "Embeddings" followed by a numeric or symbol representation, displayed in multiple colors on a technology-themed, colorf
April 08, 2025 • 21 Minuten gelesen
jina-reranker-m0: Mehrsprachiger multimodaler Dokument-Reranker
Wir stellen jina-reranker-m0 vor, unseren neuen mehrsprachigen multimodalen Reranker für das Abrufen visueller Dokumente, mit SOTA-Performance bei mehrsprachigen langen Dokumenten und Code-Suchaufgaben.
Jina AI
Modern dot matrix text display on a dark blue background, conveying a digital feel.
Dezember 12, 2024 • 12 Minuten gelesen
Skalierung der Rechenleistung zur Testzeit bei Embedding-Modellen
Bessere Ergebnisse skalieren mit Rechenleistung—mehr beim Lernen, mehr bei der Suche. Ein gutes vortrainiertes Modell bringt einen weit, aber Rechenleistung zur Testzeit bringt einen noch weiter. Es ist wichtig, dieses neue Paradigma der Skalierung von Rechenleistung zur Testzeit zu erkennen, selbst bei Embedding-Modellen.
Han Xiao
David Hockney artwork of a hand holding a rod with three colored spheres on a blue-toned background.
Dezember 04, 2024 • 13 Minuten gelesen
Braucht man immer noch Chunking, wenn Long-Context-Modelle alles können?
Vergleich der Leistung von Long-Context-Embedding-Modellen mit verschiedenen Chunking-Strategien, um den optimalen Ansatz für Ihre Anforderungen zu finden.
Michael Günther
Alex C-G
Artistic pixel art of two seagulls on colored pipes with speech bubbles; one reads "Too long?" and the other shows math equat
November 21, 2024 • 9 Minuten gelesen
Jina CLIP v2: Multilinguale und Multimodale Embeddings für Text und Bilder
Jina-CLIP v2, ein multimodales Embedding-Modell mit 0,9 Milliarden Parametern, das 89 Sprachen unterstützt, eine hohe Bildauflösung von 512x512 bietet und Matryoshka-Repräsentationen verwendet.
Jina AI
Digital number "2" displayed in a mosaic of colorful squares against a dark background, creating a futuristic vibe.
Aktuelle Sprache / Design
Search Foundation
Reader
Einbettungen
Reranker
Jina API-Schlüssel abrufen
Ratenbegrenzung
Über uns
Neuigkeiten
Jina-Logo herunterladen
open_in_new
Elastic-Logo herunterladen
open_in_new
API-Status
Elastic © 2026.SicherheitAGBPrivatsphäreCookie-EinstellungenMeine persönlichen Daten nicht verkaufen oder weitergeben
Diese Website und alle zugehörigen Inhalte, Software, Produkte und Dienstleistungen sind ausschließlich für den professionellen Gebrauch bestimmt. Eine Nutzung durch Endverbraucher ist weder vorgesehen noch empfohlen.