Embeddings
 Reranker
jina-colbert-v2
 Jina-API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-Gapped
Überblick
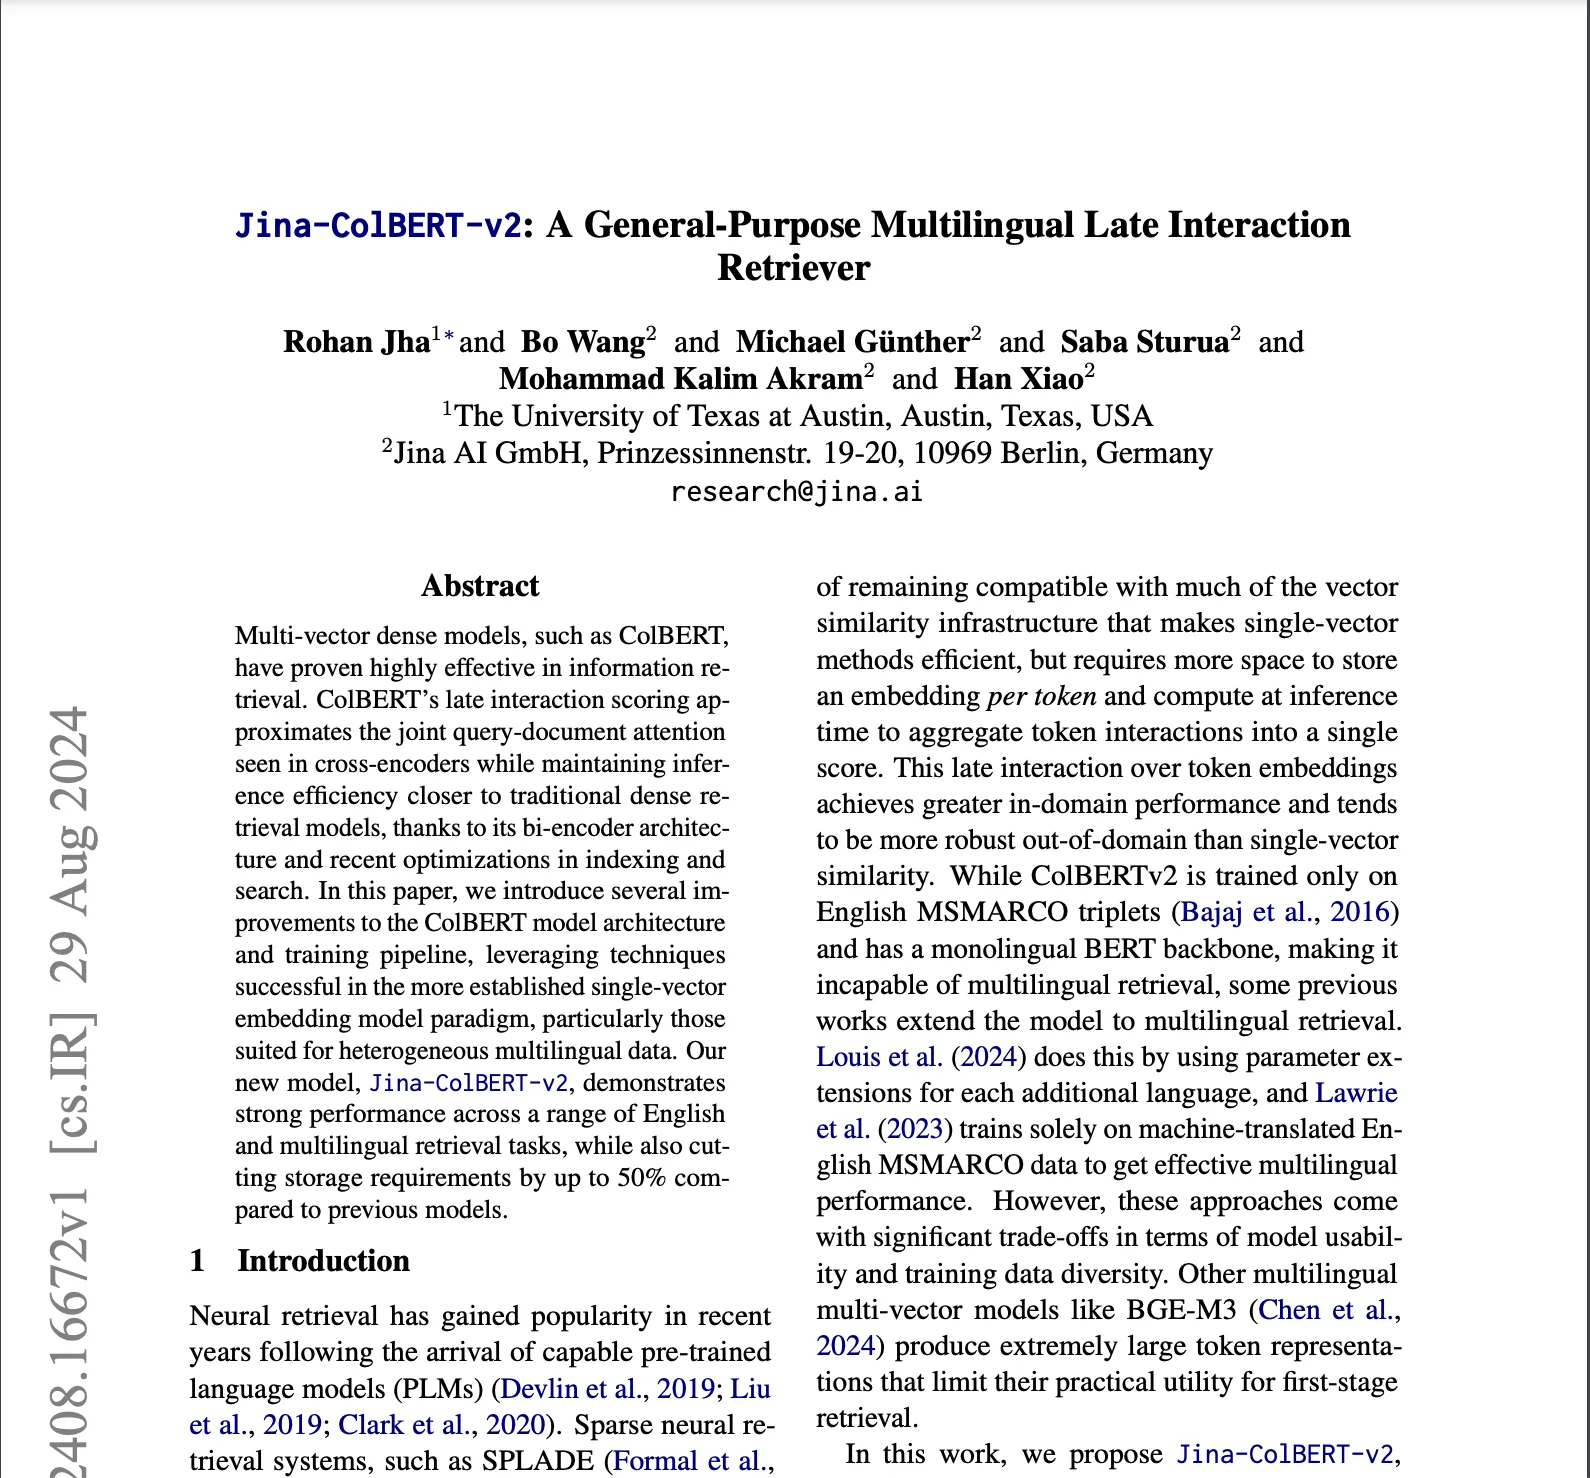
jina-colbert-v2 ist ein 560M-Parameter mehrsprachiges Late-Interaction-Retrieval-Modell, das 89 Sprachen unterstützt. Es ist das erste mehrsprachige ColBERT-ähnliche Modell, das kompakte Embeddings auf Token-Ebene (64–128 Dimensionen pro Token) erzeugt, und ermöglicht damit skalierbare, kosteneffiziente mehrsprachige Suche. Matryoshka-Repräsentationslernen erlaubt die Dimensionsreduzierung von 128 auf 64 mit nur 1,5 % Performance-Abschlag und halbiert die Speicheranforderungen.
Methoden
Das Modell baut auf der ColBERT-Late-Interaction-Architektur mit einem modifizierten XLM-RoBERTa-Backbone (560M Parameter) auf, verstärkt um Rotary Position Embeddings und optimiert mit Flash Attention. Das Training umfasst zwei wesentliche Stufen: (1) initiales Pretraining auf vielfältigen, schwach überwachten Daten aus verschiedenen Sprachen, (2) Feintuning auf gelabelten Triplett-Daten und überwachte Destillation von einem größeren Teacher-Modell. Die wesentliche Innovation ist die Implementierung von Matryoshka-Repräsentationslernen für Multi-Vektor-Embeddings: Das Modell erzeugt Vektoren auf Token-Ebene in 128, 96 oder 64 Dimensionen aus einem einzelnen Trainingslauf und ermöglicht damit dynamische Speicher-Optimierung ohne Neutraining. Der 8.192-Token-Dokument-Kontext (erweiterbar auf 12.288) und das 32-Token-Limit für Queries werden über ALiBi-Positionskodierungen verwaltet.
Leistung
Das Modell erreicht eine 6,5 % Verbesserung gegenüber dem ursprünglichen ColBERT-v2 bei englischen Aufgaben, mit einem Durchschnittsscore von 0,521 über 14 BEIR-Benchmarks. Es übertrifft traditionelle BM25-basierte Retrieval-Methoden in allen getesteten Sprachen auf MIRACL-Benchmarks und zeigt besondere Stärke in sprachübergreifenden Szenarien. Die Reduktion von 128 auf 64 Dimensionen führt zu nur 1,5 % Performance-Abschlag und halbiert die Speicheranforderungen – zum Beispiel kostet das Speichern von 100 Millionen Dokumenten mit 64-dimensionalen Vektoren 659,62 $/Monat auf AWS gegenüber 1.319,24 $ für 128 Dimensionen. Die mehrsprachige Abdeckung des Modells (89 Sprachen) und die kompakten Token-Embeddings machen es besonders geeignet für globale Suchanwendungen.
Empfehlungen
Das Modell benötigt CUDA-fähige Hardware für optimale Performance. Es unterstützt Dokumentlängen bis zu 8.192 Tokens (erweiterbar auf 12.288) und begrenzt Queries auf 32 Tokens. Für Produktions-Deployment ist es über die Jina Search Foundation API, den AWS-Marktplatz und Azure verfügbar, mit einer nichtkommerziellen Version auf Hugging Face. Bei der Implementierung angeben, ob Sie Queries oder Dokumente embedden – das Modell verwendet asymmetrisches Encoding. Das Modell ist nicht für Echtzeit-Verarbeitung extrem großer Dokumentkollektionen ohne geeignete Indexierung ausgelegt; für ANN-Suche FAISS, Qdrant oder Weaviate verwenden. Für domänenspezifische Aufgaben Feintuning auf Ihrem Korpus in Betracht ziehen. Für Single-Vektor-Retrieval mit höherdimensionaler Ausgabe jina-embeddings-v4 (Single-Vektor-Modus) oder jina-embeddings-v5-text-small in Betracht ziehen.