


 Embeddings
 Apache-2.0-Lizenz
jina-embedding-b-en-v1
Apache-2.0 Hugging Face
 Air-Gapped
Überblick
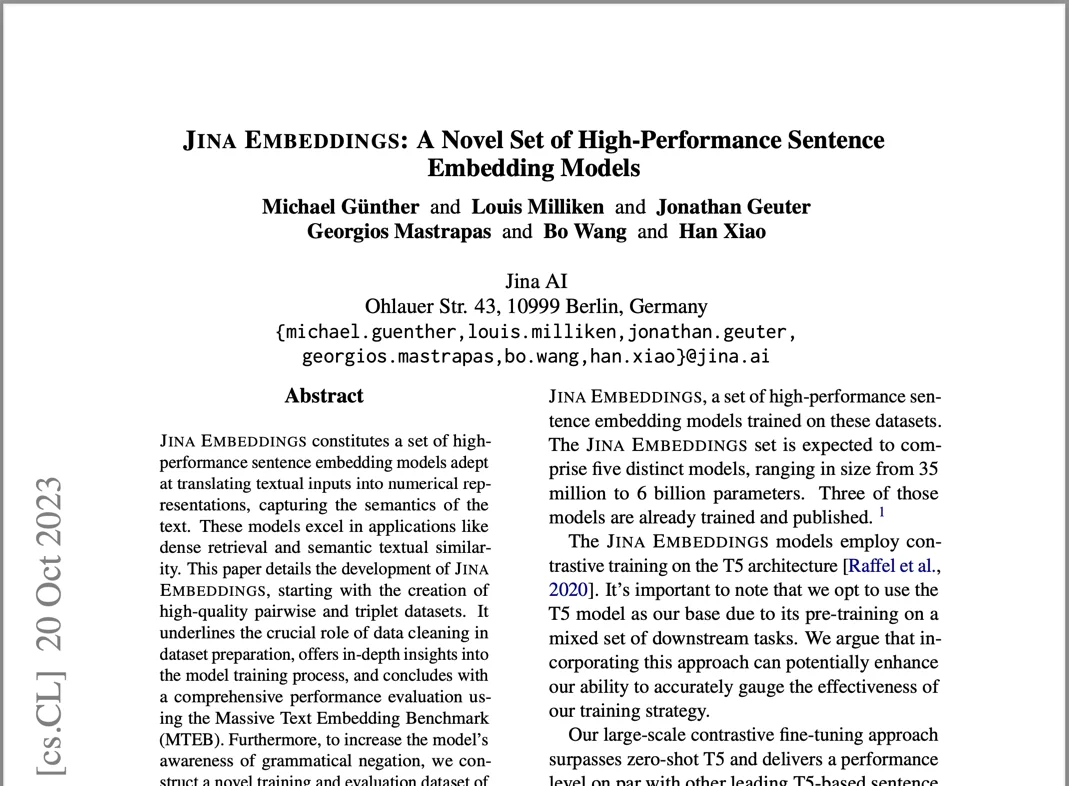
jina-embedding-b-en-v1 war das erste öffentlich veröffentlichte Text-Embedding-Modell von Jina AI: ein 110M-Parameter bidirektionaler Encoder, der englischen Text in 768-dimensionale Vektoren abbildet. Es wurde für semantische Suche, Ähnlichkeitsvergleiche und Inhaltsempfehlungen zu einer Zeit entworfen, in der 512-Token-Kontexte der Industriestandard waren, und etablierte Jinas Einstieg in den Open-Source-Embedding-Bereich. Das Modell gilt inzwischen als Legacy-Modell und wurde von den v2- und v3-Familien überholt, die 8K+-Token-Kontexte und mehrsprachige Eingaben unterstützen.
Methoden
Das Modell verwendet eine T5-Encoder-Architektur mit Mean-Pooling, um festlängige 768-dimensionale Repräsentationen zu erzeugen. Das Training folgte einem zweiphasigen kontrastiven Rezept auf dem Linnaeus-Clean-Datensatz (385M Satzpaare, gefiltert aus 1,6B Kandidaten): zuerst InfoNCE-Loss auf positiven Textpaaren zum Lernen der semantischen Ausrichtung; zweitens Triplet-Loss zur Schärfung der Diskriminierung zwischen ähnlichen, aber semantisch unterschiedlichen Texten. Eine zentrale Designentscheidung war die Mean-Pooling-Strategie, die Repräsentationen auf Token-Ebene zu einem einzigen Vektor mittelt, der globale Satzbedeutung erfasst. Das 512-Token-Kontextfenster war zu seiner Zeit Standard, begrenzt aber den Nutzen des Modells für Anwendungen mit langen Dokumenten.
Leistung
Auf STS12 erreichte das Modell einen Korrelationswert von 0,751 und übertraf bei der Veröffentlichung all-mpnet-base-v2 und all-minilm-l6-v2. Es zeigte starke Performance bei Standardaufgaben für englische Satz-Embeddings und behielt dabei schnelle, für die Produktion geeignete Inferenzeiten. Sein 512-Token-Kontextfenster und der Fokus auf Englisch machten es für die Workloads mit langen Dokumenten und mehrsprachigen Inhalten ungeeignet, die bis 2025 Standard wurden. Das Modell wurde durch jina-embeddings-v2-base-en (8K-Kontext, bidirektionales ALiBi) und jina-embeddings-v3 (570M Parameter, 89 Sprachen, aufgabenspezifische LoRA-Adapter) ersetzt.
Empfehlungen
Dieses Modell gilt als Legacy und sollte nicht für neue Projekte verwendet werden. Wenn Sie von jina-embedding-b-en-v1 migrieren, wechseln Sie für aktuelle Workloads zu jina-embeddings-v5-text-small – es unterstützt 32K-Token-Kontext, 89 Sprachen und aufgabenspezifische LoRA-Adapter. Für codespezifische Embedding-Anforderungen jina-code-embeddings-1.5b verwenden. Das Modell benötigt CUDA-fähige Hardware für optimale Performance und akzeptiert Eingaben bis zu 512 Tokens. Es ist nicht für mehrsprachige Inhalte, lange Dokumente oder code-zentrierte Anwendungen geeignet.