Embeddings
jina-embeddings-v3
 Elastic Inference Service
 Jina-API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-Gapped
Überblick
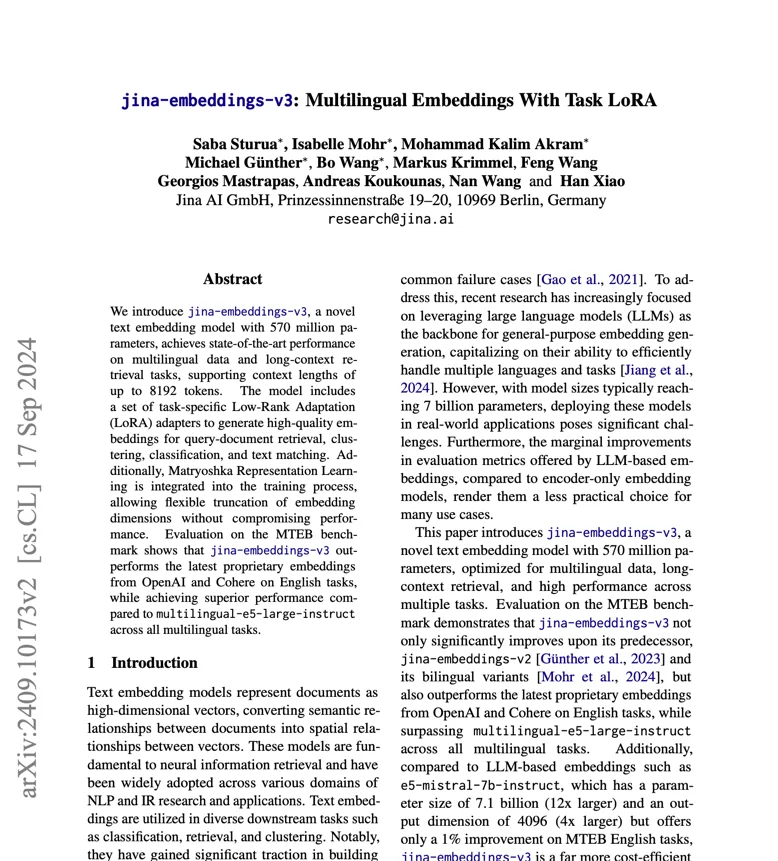
jina-embeddings-v3 ist ein mehrsprachiges Text-Embedding-Modell mit 570M Parametern, das 89 Sprachen und ein 8.192-Token-Kontextfenster unterstützt. Seine prägende Innovation ist die Nutzung von aufgabenspezifischen LoRA-Adaptern: derselbe 570M-Backbone erzeugt optimierte Embeddings für Retrieval, Klassifizierung, Clustering und Text-Matching, indem leichte Adapter-Gewichte ausgetauscht werden (jeweils unter 60M Parametern). Es erreichte bei Veröffentlichung State-of-the-Art-Werte im MTEB und übertraf die proprietären Embeddings von OpenAI und Cohere bei englischsprachigen Aufgaben.
Methoden
Das Modell basiert auf einem jina-XLM-RoBERTa-Backbone mit 24 Transformer-Layern und verwendet Rotary Position Embeddings (RoPE) mit abgestimmter Basisfrequenz für die Extrapolation auf lange Kontexte bis 8.192 Tokens. Das Training folgte einem dreistufigen Curriculum: (1) mehrsprachiges Pretraining auf 89 Sprachen, (2) kontrastive Feinabstimmung auf gepaarten Text-Datensätzen, um die Basisqualität der Embeddings zu etablieren, (3) aufgabenspezifisches LoRA-Adapter-Training. Jeder LoRA-Adapter fügt weniger als 3 % zur Gesamtzahl der Parameter hinzu, während er das Modell für eine bestimmte Aufgabe spezialisiert: retrieval.query und retrieval.passage für asymmetrische Suche, separation für Clustering, classification für Kategorisierung und text-matching für semantische Ähnlichkeit. Matryoshka Representation Learning (MRL) ermöglicht Embedding-Trunkierung von 1024 auf 32 Dimensionen und erhält bei 64 Dimensionen über 90 % der Retrieval-Qualität. Late Chunking wird für Dokumente unterstützt, die das Kontextfenster überschreiten.
Leistung
Auf MTEB erzielte jina-embeddings-v3 einen Durchschnittswert von 65,52 über alle Aufgaben, mit besonders starken Ergebnissen in Klassifizierung (82,58) und Satzähnlichkeit (85,80). Es übertraf multilingual-e5-large-instruct in allen mehrsprachigen Aufgaben und schlug e5-mistral-7b-instruct (12× die Parameterzahl) bei englischen Aufgaben. Auf mehrsprachigem MTEB erzielte es 64,44, mit konsistenter Performance über 89 Sprachen. MRL-Trunkierung bewahrte 92 % der Retrieval-Leistung bei 64 Dimensionen gegenüber den vollen 1024. Im Jahr 2026 wird dieses Modell für die meisten Workloads von jina-embeddings-v5-text-small abgelöst, das 32K-Kontext und destillationsbasiertes Training mit höherer Genauigkeit pro Parameter bietet.
Empfehlungen
Wählen Sie den passenden LoRA-Adapter für Ihre Aufgabe: retrieval.query/retrieval.passage für Suche, separation für Clustering, classification für Kategorisierung, text-matching für semantische Ähnlichkeit. Verwenden Sie den `late_chunking-Parameter für Dokumente über 8.192 Tokens. Matryoshka-Trunkierung auf 256 oder 512 Dimensionen eignet sich für speicherbeschränkte Indexierung; verwenden Sie volle 1024 Dimensionen für Re-Ranking. Das Modell benötigt eine CUDA-fähige GPU für den Produktionsdurchsatz. Für neue mehrsprachige Projekte bevorzugen Sie jina-embeddings-v5-text-small` (32K-Kontext, per Destillation trainiert, höhere Genauigkeit). Das Modell ist nicht für Textgenerierung oder komplexes Reasoning ausgelegt – es erzeugt Embeddings, keine Texte.