Einbettungen
 Qwen-Forschungslizenz
jina-embeddings-v4
Qwen Research License GGUF
 Jina-API
 Hugging Face
 Air-Gapped
Überblick
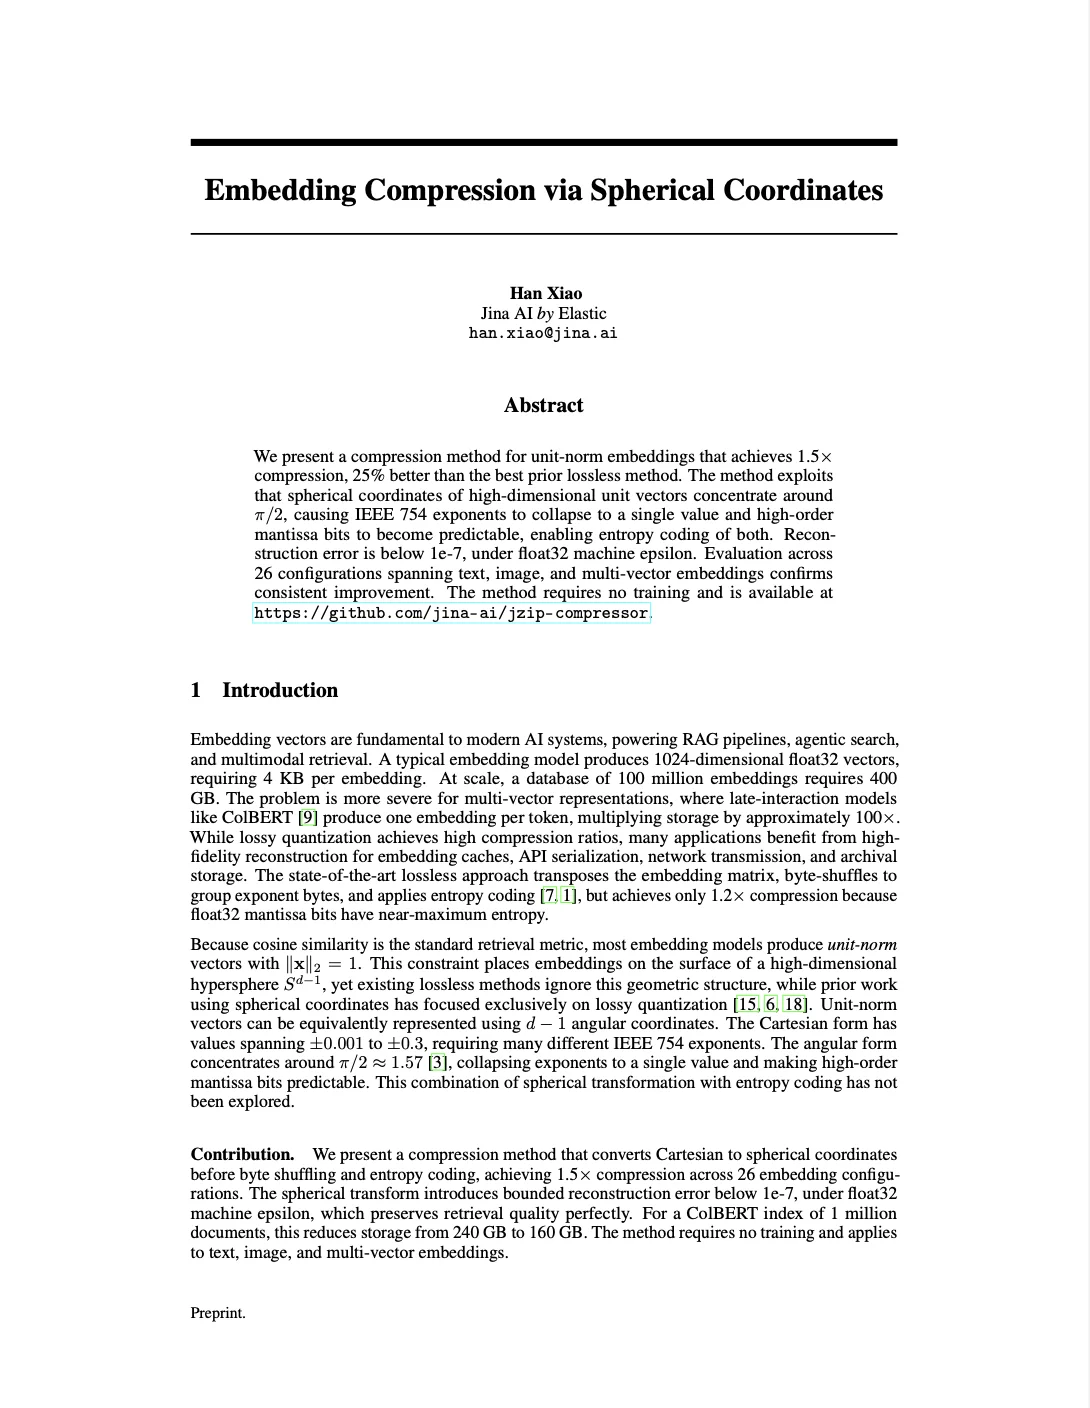
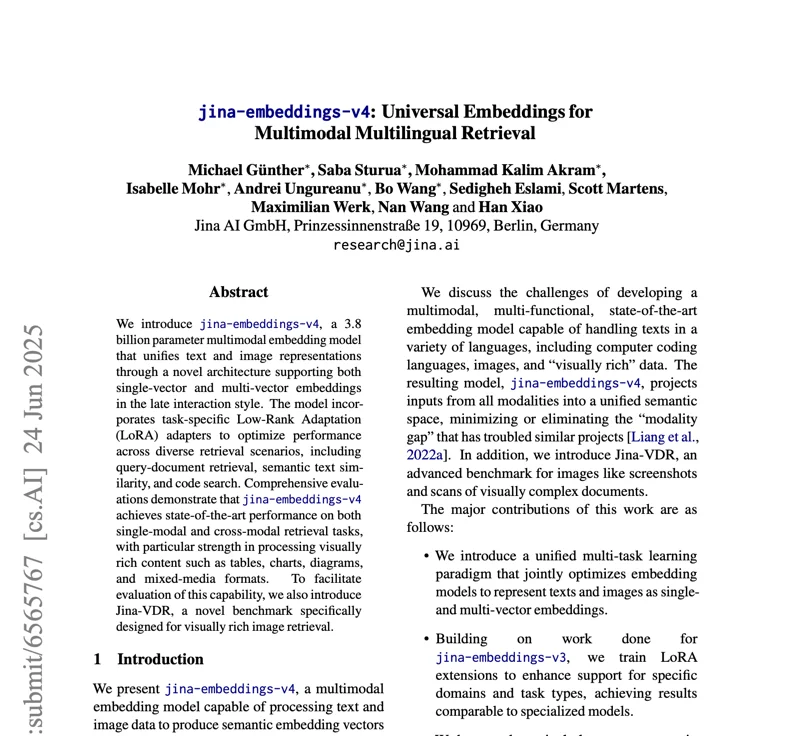
jina-embeddings-v4 ist ein multimodales Embedding-Modell mit 3,8B Parametern, das Text- und Bildrepräsentationen in einer einzigen Architektur vereint. Es unterstützt einzigartig sowohl Single-Vector- (dicht) als auch Multi-Vector- (Late-Interaction-/ColBERT-Stil) Ausgabe-Modi und ermöglicht Teams, Indexier-Effizienz gegen Abruf-Präzision abzuwägen, ohne das Modell zu wechseln. Das Modell erreicht State-of-the-Art-Performance bei visuell reichem Dokumentenretrieval und verarbeitet Tabellen, Diagramme, Grafiken und gemischte Medienformate nativ.
Methoden
Die Architektur kombiniert einen großen Transformer-Encoder-Backbone mit einem Qwen2.5-VL-basierten Vision-Encoder und verarbeitet Text (bis zu 32K Tokens) und Bilder (768×28×28 Patches) über geteilte Attention-Layer. Drei aufgabenspezifische LoRA-Adapter (je 60M Parameter) spezialisieren das Modell auf: asymmetrische Query-Dokumenten-Retrieval, semantische Textähnlichkeit und Code-Suche. Das Dual-Output-Design ist die Schlüsselinnovation: Das Modell kann einen einzelnen 2048-dimensionalen Dense-Vektor (für schnelles ANN-Indexing mit Matryoshka-Trunkierung auf 128 Dimensionen) oder eine Menge von 128-dimensionalen Token-Level-Vektoren für Late-Interaction-Scoring erzeugen. Das Training nutzte ein zweistufiges Curriculum: kontrastives Joint-Pretraining auf Text-Bild- und Text-Text-Paaren, gefolgt von aufgabenspezifischem LoRA-Adapter-Training. Late Chunking wird für Dokumente unterstützt, die das 32K-Token-Kontextfenster überschreiten. Die Qwen Research License gilt.
Leistung
Auf JinaVDR (Visual Document Retrieval) erzielt das Modell einen Durchschnitt von 72,19 gegenüber 64,50 für ColPali-v1.2. Auf ViDoRe erreicht es einen Durchschnitt von 84,11 (90,17 im Multi-Vector-Modus) gegenüber 83,90 für ColPali. Cross-Modal-Retrieval erreicht 84,11 auf dem CLIP-Benchmark und übertrifft jina-clip-v2 (81,12) und nllb-clip-large-siglip (83,19). Text-Retrieval-Scores: 55,97 auf MTEB-en, 66,49 auf MMTEB, 67,11 auf LongEmbed (gegenüber 55,66 für jina-embeddings-v3). Semantische Ähnlichkeit erreicht 85,89 auf English STS und 72,70 auf multilingualer STS. Code-Retrieval erreicht 71,59 auf CoIR. Die Cross-Modal-Ausrichtung erreicht 0,71 Kosinus-Ähnlichkeit (gegenüber 0,15 für OpenAI CLIP). Der Multi-Vector-Modus übertrifft den Single-Vector-Modus konsistent auf visuell reichen Aufgaben; der Single-Vector-Modus liefert effiziente Performance für standardmäßiges Text-Retrieval.
Anleitung
Wählen Sie den Ausgabe-Modus basierend auf Ihrer Pipeline: Single-Vector für großskaliges ANN-Indexing (Matryoshka-Trunkierung auf 128–512 Dimensionen verfügbar), Multi-Vector für das Re-Ranking von Top-k-Kandidaten auf visuell reichen Dokumenten. Wählen Sie den LoRA-Adapter über den API-Task-Parameter: 'retrieval' für Query-Dokumenten-Suche, 'text-matching' für semantische Ähnlichkeit, 'code' für Code-Retrieval. Für Dokumente über 32K Tokens nutzen Sie `late_chunking. Der 60M-Parameter-Overhead pro LoRA-Adapter ist vernachlässigbar (<2 % Speicherzuwachs) und alle drei Adapter können gleichzeitig geladen werden. Das Modell ist unter der Qwen Research License lizenziert (kommerzielle Nutzung ohne kommerzielle Lizenz nicht erlaubt). Für Produktions-Deployments nutzen Sie CUDA-fähige GPUs; das Modell ist über Jina API, AWS, Azure und GCP-Marktplätze verfügbar. Für rein textbasierte Workloads bietet jina-embeddings-v5-text-small` bessere Genauigkeit pro Parameter zu einem Bruchteil der Rechenkosten.