Einbettungen
jina-embeddings-v5-omni-nano
 GGUF
 MLX
 Elastic Inference Service
 Jina-API
 AWS SageMaker
 Hugging Face
 MacOS
 Air-Gapped
Überblick
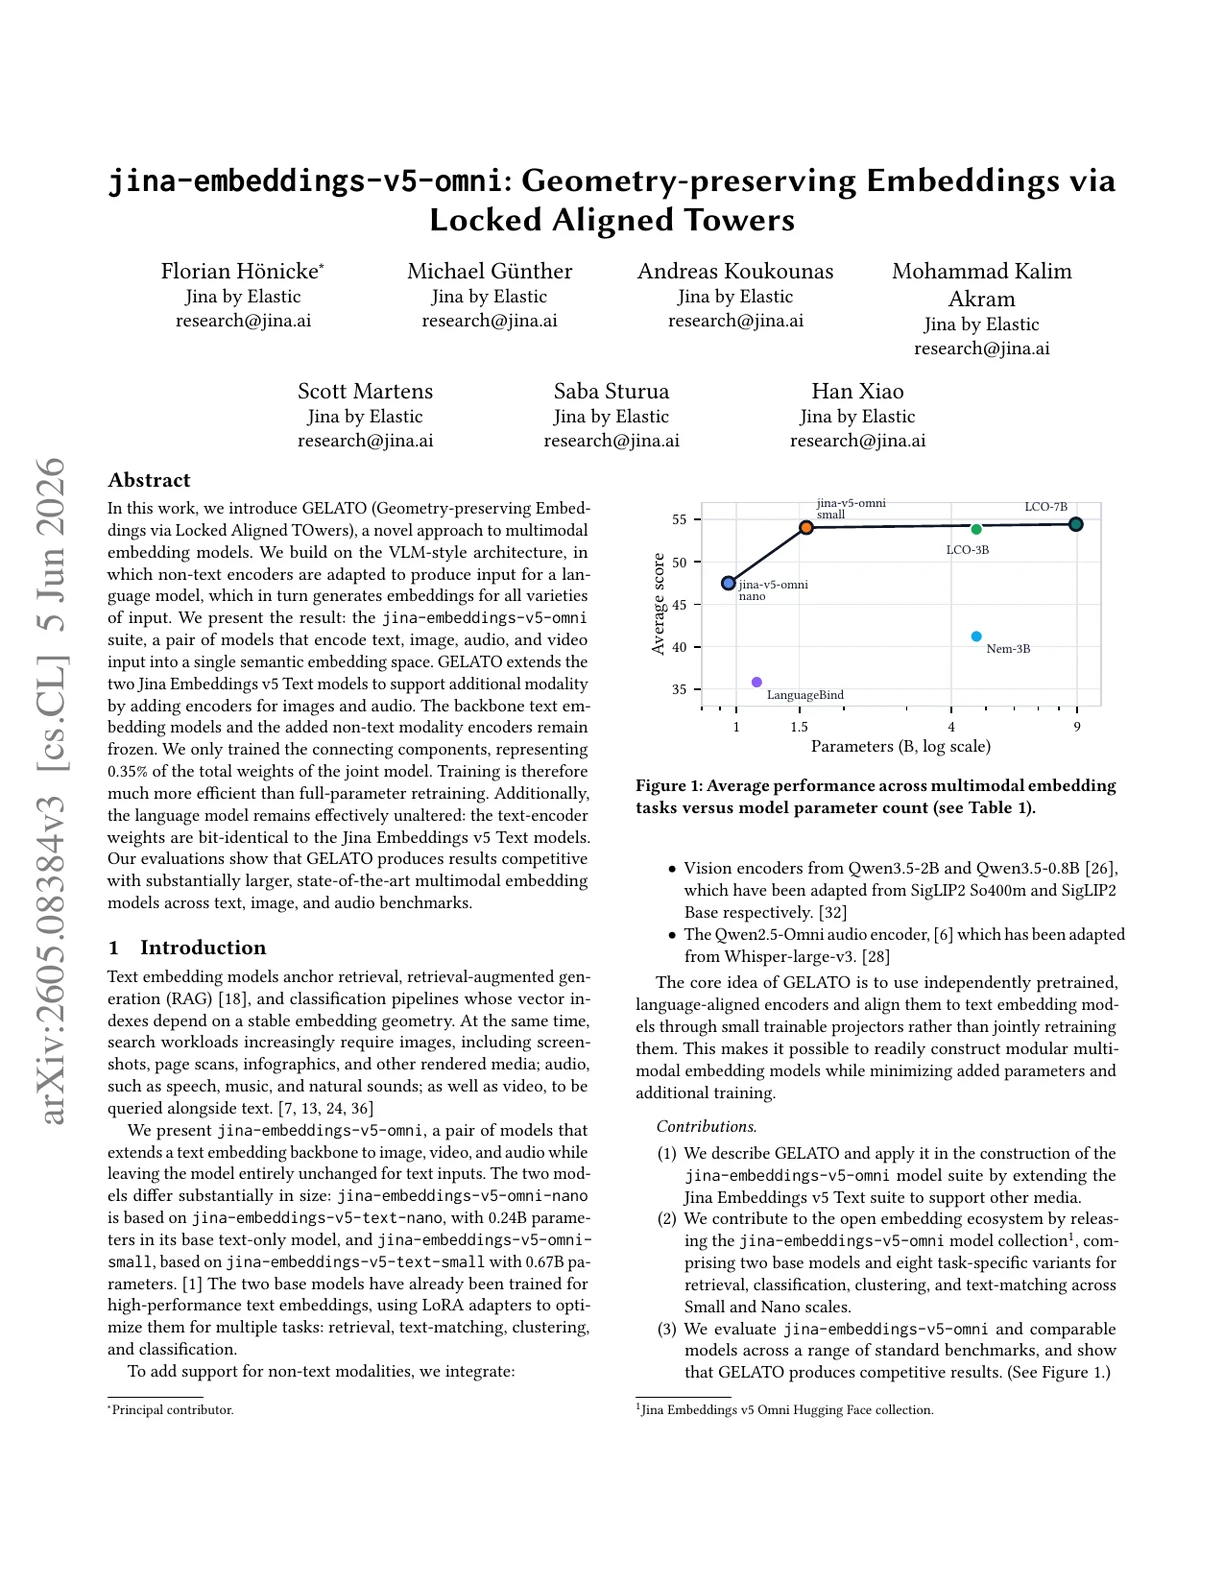
jina-embeddings-v5-omni-nano ist ein multimodales Embedding-Modell mit rund 1,04B Parametern, das Text, Bilder, Video und Audio akzeptiert und Embeddings in einem gemeinsamen Vektorraum erzeugt. Es ist die kompakte Variante der v5-omni-Familie, entworfen für Edge- und Standard-Hardware ohne GPU. Die rein textuellen Ausgaben sind bit-identisch mit jina-embeddings-v5-text-nano, was ein Drop-in-Upgrade von text-only zu multimodal ohne Reindexierung möglich macht.
Methoden
Das Modell wird durch eine dritte Trainingsphase von jina-embeddings-v5-text-nano aus um multimodale Fähigkeiten erweitert. Das EuroBERT-210M-Text-Backbone und alle vier aufgaben-spezifischen LoRA-Adapter werden eingefroren; nur die Cross-Modal-Projectoren werden neu trainiert. Ein SigLIP2 Base-Vision-Encoder verarbeitet Bilder und Video (32 gleichmäßig abgetastete Frames pro Video). Ein Whisper-large-v3-Audio-Encoder verarbeitet Audioeingaben. PDF-Seiten werden als Bilder gerendert und über den visuellen Pfad verarbeitet. Das Training verwendet einen kontrastiven Verlust mit Cross-Modal-Hard-Negativen, um visuelle und Audio-Darstellungen mit dem bestehenden Text-Embedding-Raum auszurichten. Der 768-dimensionale Ausgabe-Raum unterstützt Matryoshka-Verkürzung bis hinab zu 32 Dimensionen. Das 8K-Token-Kontextfenster deckt den Texteingang ab; Bild- und Audioeingaben werden über ihre jeweiligen Encoder verarbeitet.
Leistung
Die reine Text-Leistung ist bit-identisch mit jina-embeddings-v5-text-nano (65,5 MMTEB Task-Ebene-Durchschnitt, 71,0 englisches MTEB). Die multimodale Leistung liegt leicht unter jina-embeddings-v5-omni-small, da der 768-dimensionale Embedding-Raum (gegenüber 1024) schmaler ist und das Text-Backbone kleiner, sie erhält aber eine starke Cross-Modal-Ausrichtung über Text-Bild-, Text-Audio- und Text-Video-Retrieval. Das Modell ist für CPU- und Edge-Hardware optimiert, wo das größere omni-small-Modell nicht effizient läuft. Die Cross-Modal-Retrieval-Qualität ist für seine Größenklasse wettbewerbsfähig.
Anleitung
Gleiche Nutzungsmuster wie jina-embeddings-v5-omni-small: Wählen Sie den passenden LoRA-Adapter (retrieval, text-matching, clustering, classification) und übergeben Sie direkt über die API Bild-URLs, Audio-Datei-URLs, Video-Datei-URLs oder PDF-URLs — das Modell leitet jede Modalität über den passenden Encoder weiter. Unterstützte Audio-Formate: WAV, MP3, FLAC, OGG, M4A, Opus. Videoeingaben werden als 32 gleichmäßig abgetastete Frames verarbeitet. Modalitäten können innerhalb eines einzigen Batches frei gemischt werden; der Embedding-Raum wird über alle Modalitäten hinweg geteilt. Nutzen Sie Kosinus-Ähnlichkeit zum Vergleich. Matryoshka-Verkürzung von 768 auf 32 Dimensionen wird unterstützt. Reine Text-Embeddings sind drop-in-kompatibel mit jina-embeddings-v5-text-nano — bei der Aufrüstung ist keine Reindexierung nötig. Für Server-Deployments, die höhere Genauigkeit erfordern, nutzen Sie jina-embeddings-v5-omni-small (1024 Dimensionen, größeres Backbone).