Embeddings
jina-embeddings-v5-text-small
 GGUF
 MLX
 Elastic Inference Service
 Jina-API
 AWS SageMaker
 Hugging Face
 Air-Gapped
Überblick
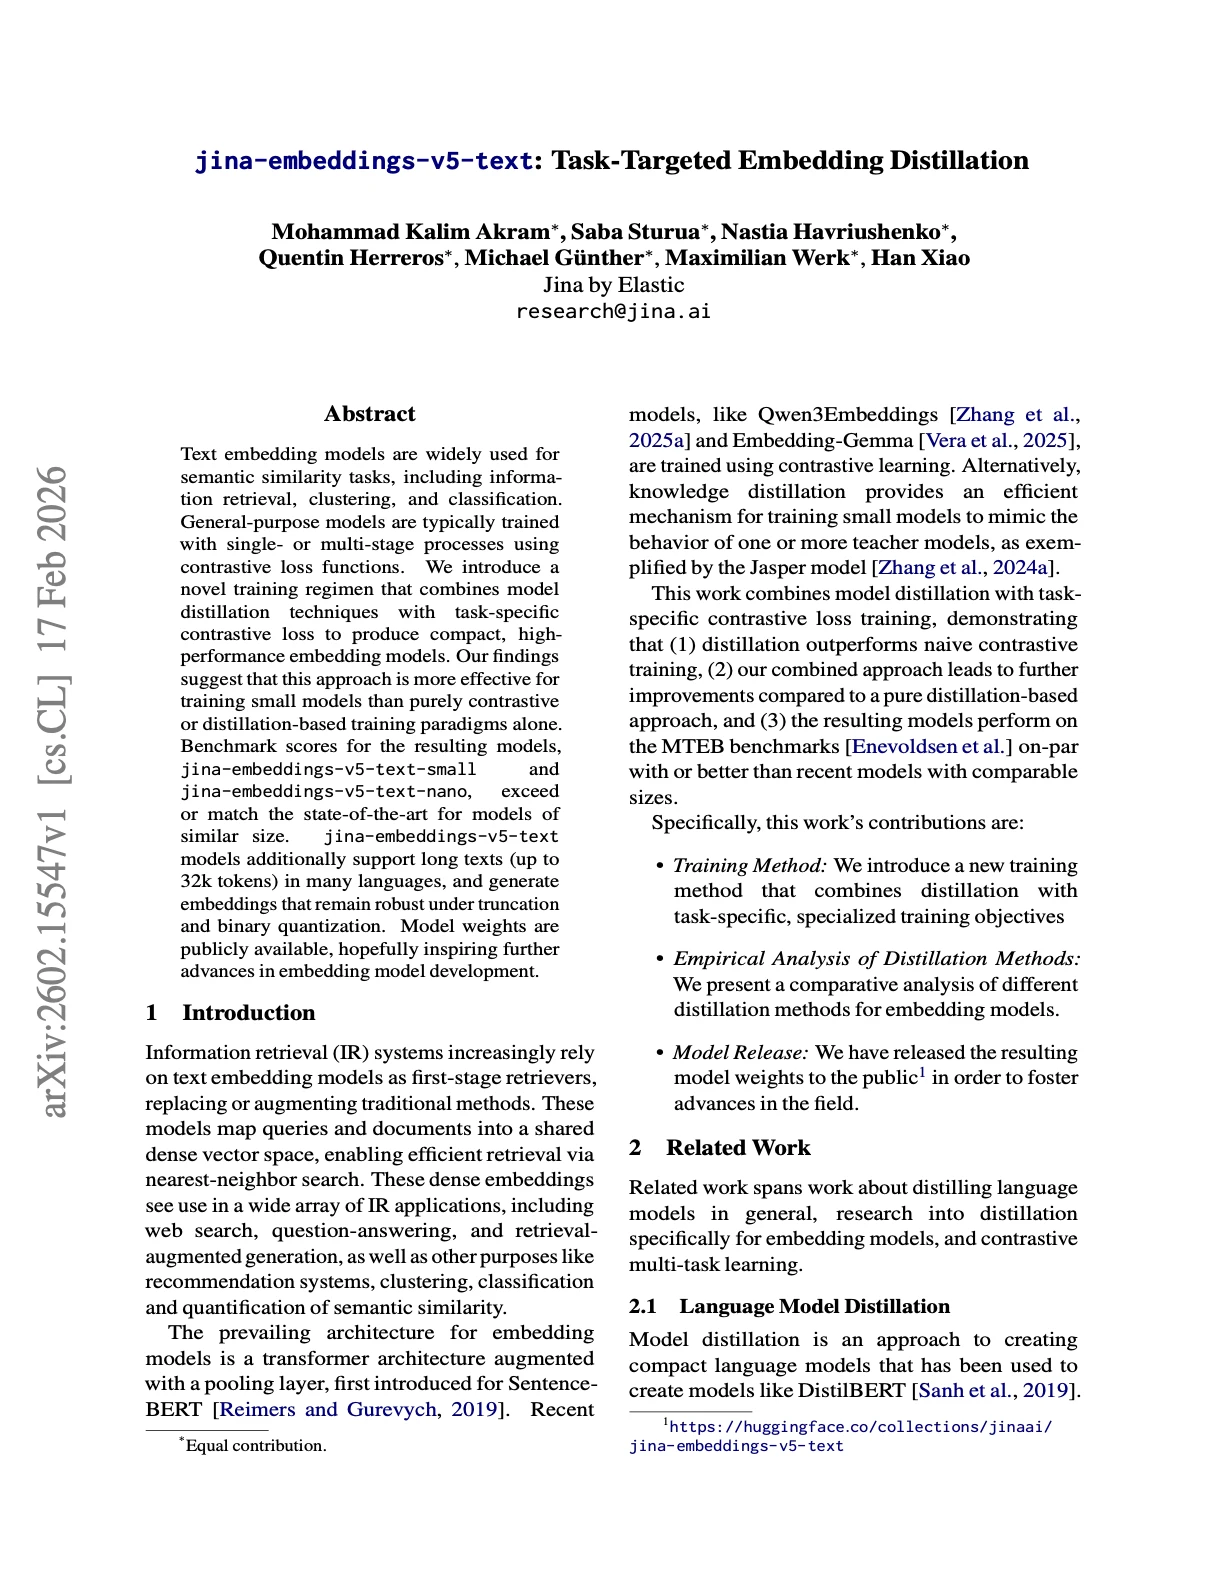
jina-embeddings-v5-text-small ist ein mehrsprachiges Text-Embedding-Modell mit 677M Parametern, aufgebaut auf dem Qwen3-0,6B-Base-Backbone. Es unterstützt einen 32K-Token-Kontext, erzeugt 1024-dimensionale Embeddings mit Matryoshka-Trunkierung bis hinab zu 32 Dimensionen und erreicht den höchsten MTEB-Durchschnitt aller Modelle mit unter 1B Parametern. Es ist das Standard-Embedding-Modell der Jina-API und die erste Wahl für RAG-Pipelines im Produktivbetrieb.
Methoden
Das Modell basiert auf Qwen3-0,6B-Base, einem mehrsprachigen Basismodell, das auf 119 Sprachen vortrainiert wurde. Es verwendet Last-Token-Pooling, um Embeddings zu erzeugen. Das Training folgt einem zweistufigen Verfahren: (1) Embedding-Distillation von Qwen3-Embedding-4B (einem Teacher mit 4B Parametern) überträgt hochwertige Embedding-Repräsentationen auf den 677M-Studenten; (2) ein aufgabenspezifischer kontrastiver Loss stimmt das Modell auf Retrieval-, Text-Matching-, Clustering- und Klassifikationsaufgaben fein. Geometric Orthogonal Regularization (GOR) stellt sicher, dass Embeddings unter binärer Quantisierung mit minimalem Leistungsverlust robust bleiben. Matryoshka Representation Learning ermöglicht das Kürzen der Dimensionen von 1024 auf 32 und bewahrt die starke Retrieval-Qualität bei über 256 Dimensionen. Rotary Position Embeddings mit angepassten Basisfrequenzen ermöglichen das 32K-Kontextfenster, und das Modell wurde zusätzlich auf Langkontext-Daten für robustes Long-Document-Retrieval trainiert.
Leistung
Auf MMTEB (mehrsprachig) erreicht das Modell 67,0 Durchschnitt auf Aufgabenebene und 58,9 Durchschnitt auf Typ-Ebene – das höchste unter allen Modellen mit unter 1B Parametern. Werte auf Aufgabenebene: Klassifikation 71,3, Clustering 53,4, Pair-Klassifikation 82,9, Reranking 65,7, Retrieval 64,9, STS 78,9. Auf englischem MTEB erreicht es 71,7 Durchschnitt und übertrifft Qwen3-0,6B mit Instruktionen (70,5) und jina-embeddings-v3 (65,7). Retrieval-spezifisch: 64,88 auf MTEB-M, 66,84 auf RTEB, 56,67 auf BEIR, 66,39 auf LongEmbed. Bemerkenswert: Das Modell übertrifft seinen 4B-Teacher Qwen3-Embedding-4B bei der Pair-Klassifikation (42,0 vs. 26,8 auf MMTEB), während es 6× kleiner ist – ein Nachweis, dass Destillation kombiniert mit aufgabenspezifischem kontrastivem Training die Performance des Teachers bei bestimmten Aufgaben übertreffen kann.
Empfehlungen
Wählen Sie den passenden LoRA-Adapter: „retrieval“ für asymmetrische Query-Dokument-Suche (Queries mit „Query:“, Passagen mit „Document:“ voranstellen), „text-matching“ für symmetrische Ähnlichkeit (beide Eingaben mit „Document:“-Präfix), „clustering“ zur Gruppierung verwandter Dokumente, „classification“ für Kategorisierung und Sentiment-Analyse. Matryoshka-Trunkierung auf 256–512 Dimensionen eignet sich für speicherbeschränkte Indizes; nutzen Sie die vollen 1024 Dimensionen für das Reranking. Binäre Quantisierung wird mit minimalem Leistungsverlust unterstützt. Das 32K-Kontextfenster verarbeitet lange Dokumente nativ ohne Chunking. Nutzen Sie Kosinusähnlichkeit zum Vergleich von Embeddings. Verfügbar über die Jina AI API, Hugging Face (Sentence Transformers, vLLM) und quantisierte Varianten für llama.cpp. Für multimodale Workloads nutzen Sie stattdessen jina-embeddings-v5-omni-small.