Reranker
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 Jina-API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-Gapped
Überblick
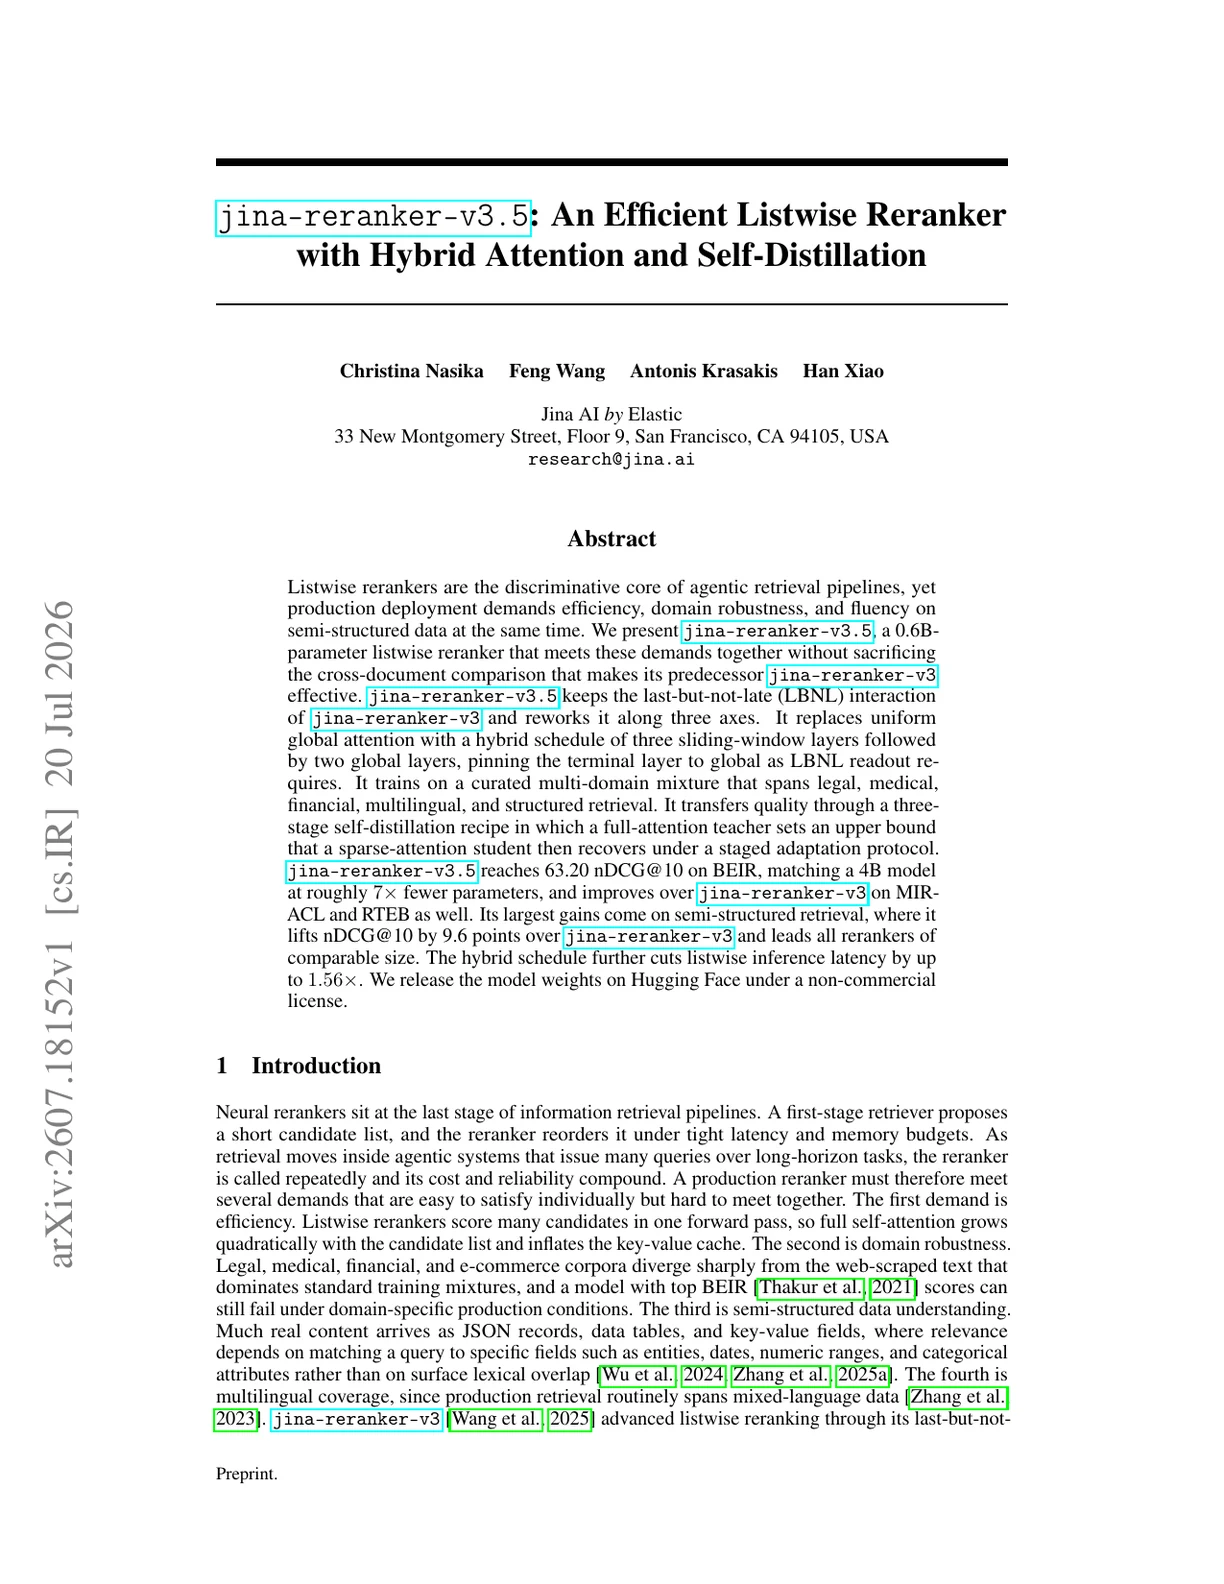
jina-reranker-v3.5 ist ein 0,6B-Parameter listweiser Reranker, der 4B-Parameter-Modelle bei etwa 7× weniger Parametern erreicht. Er führt einen Hybrid-Attention-Plan ein (drei Sliding-Window-Ebenen + zwei globale Ebenen) gekoppelt mit einem dreistufigen Self-Distillation-Rezept, das Qualität von einem Full-Attention-Teacher zu einem Sparse-Attention-Studenten überträgt. Er ist ein Drop-in-Ersatz für jina-reranker-v3 und behält das gleiche API-Schema bei, während er Effizienz und Domänenabdeckung verbessert.
Methoden
Die Architektur behält das LBNL-listweise Design von jina-reranker-v3 bei: die Query und alle Kandidatendokumente teilen ein einzelnes Kontextfenster, und Embeddings werden vom finalen Token jedes Dokuments gelesen. Die Kerninnovation ist der Hybrid-Attention-Plan. Statt uniformer globaler Attention in jeder Ebene, nutzt das Modell drei Sliding-Window-Attention-Ebenen (die die Attention jeder Position auf ein lokales Fenster beschränken) gefolgt von zwei globalen Attention-Ebenen. Die terminale Ebene ist auf globale Attention fixiert, weil der LBNL-Readout-Mechanismus das finale Token auf den vollen Kontext achten lässt. Das Training erfolgt in drei Stufen: (1) ein Full-Attention-Teacher-Modell wird auf einer kuratierten Multi-Domain-Mischung über Recht, Medizin, Finanzen, Mehrsprachigkeit und strukturiertes Retrieval trainiert; (2) ein Sparse-Attention-Student wird vom Teacher initialisiert und mit gestufter Adaptation feinabgestimmt, wobei der Anteil der Trainingsschritte mit dem Hybrid-Plan schrittweise erhöht wird; (3) ein finaler Distillation-Pass, in dem der Student lernt, die weichen Ranking-Verteilungen des Teachers abzugleichen und dabei über 97 % der Ranking-Qualität des Teachers wiederherstellt, während er den günstigeren Sparse-Attention-Inferenzpfad ausführt.
Leistung
Unter einem einheitlichen Top-100-Protokoll mit jina-embeddings-v5-text-small als Erststufen-Retriever erzielt das Modell 63,20 NDCG{'@'}10 auf BEIR, 74,11 auf MIRACL, 70,95 auf RTEB und 48,3 auf Struct-IR und verbessert sich gegenüber jina-reranker-v3 (62,10 / 72,20 / 68,01 / 38,7) in jeder Dimension. Seine BEIR-Punktzahl schlägt den 4B Qwen3-Reranker (62,28) bei etwa 7× weniger Parametern. Relative Gewinne gegenüber v3 umfassen +1,10 BEIR, +2,6 % MIRACL, +4,3 % RTEB (mit großen Sprüngen im legalen Retrieval) und +24,8 % im Ranking strukturierter Daten (Struct-IR). Listwise-Inferenz läuft 1,22×–1,56× schneller als v3 von kurzen zu langen Kontexten (A100, FlashAttention-2). Die Multi-Domain-Trainingsmischung bringt besonders starke Verbesserungen auf halbstrukturierten Daten (Tabellen, JSON, XML) und domänenspezifischen Korpora.
Anleitung
jina-reranker-v3.5 ist ein Drop-in-Ersatz für jina-reranker-v3: Das Request-Schema ändert sich nicht, daher erfordert das Wechseln des Modell-Strings keine Code-Änderungen. Es rankt eine Query gegen die vollständige Kandidatenliste in einem einzelnen Aufruf — übergeben Sie Dokumente über den Standard-Rerank-Endpunkt und nutzen Sie top_n, um die zurückgegebenen Ergebnisse zu begrenzen, oder setzen Sie return_embeddings, um auch Dokument-Embeddings abzurufen. Das Modell ist besonders stark im Ranking strukturierter Daten, im legalen und anderen domänenspezifischen Retrieval und in mehrsprachigen Sammlungen. Sein Hybrid-Attention-Design hält die Latenz auf langen Kandidatenlisten niedrig. Das 131K-Token-Kontextfenster unterstützt sehr lange Dokumente ohne Chunking. Verfügbar unter CC-BY-NC-4.0 auf Hugging Face; für kommerzielle Nutzung kontaktieren Sie Jina AI. Für air-gapped oder On-Premises-Deployments sind quantisierte Gewichte verfügbar. Kombinieren Sie es mit jina-embeddings-v5-text-small oder jina-embeddings-v4 als Erststufen-Retriever.