Reranker
jina-reranker-v3
 GGUF
 MLX
 Elastic Inference Service
 Jina-API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-Gapped
Überblick
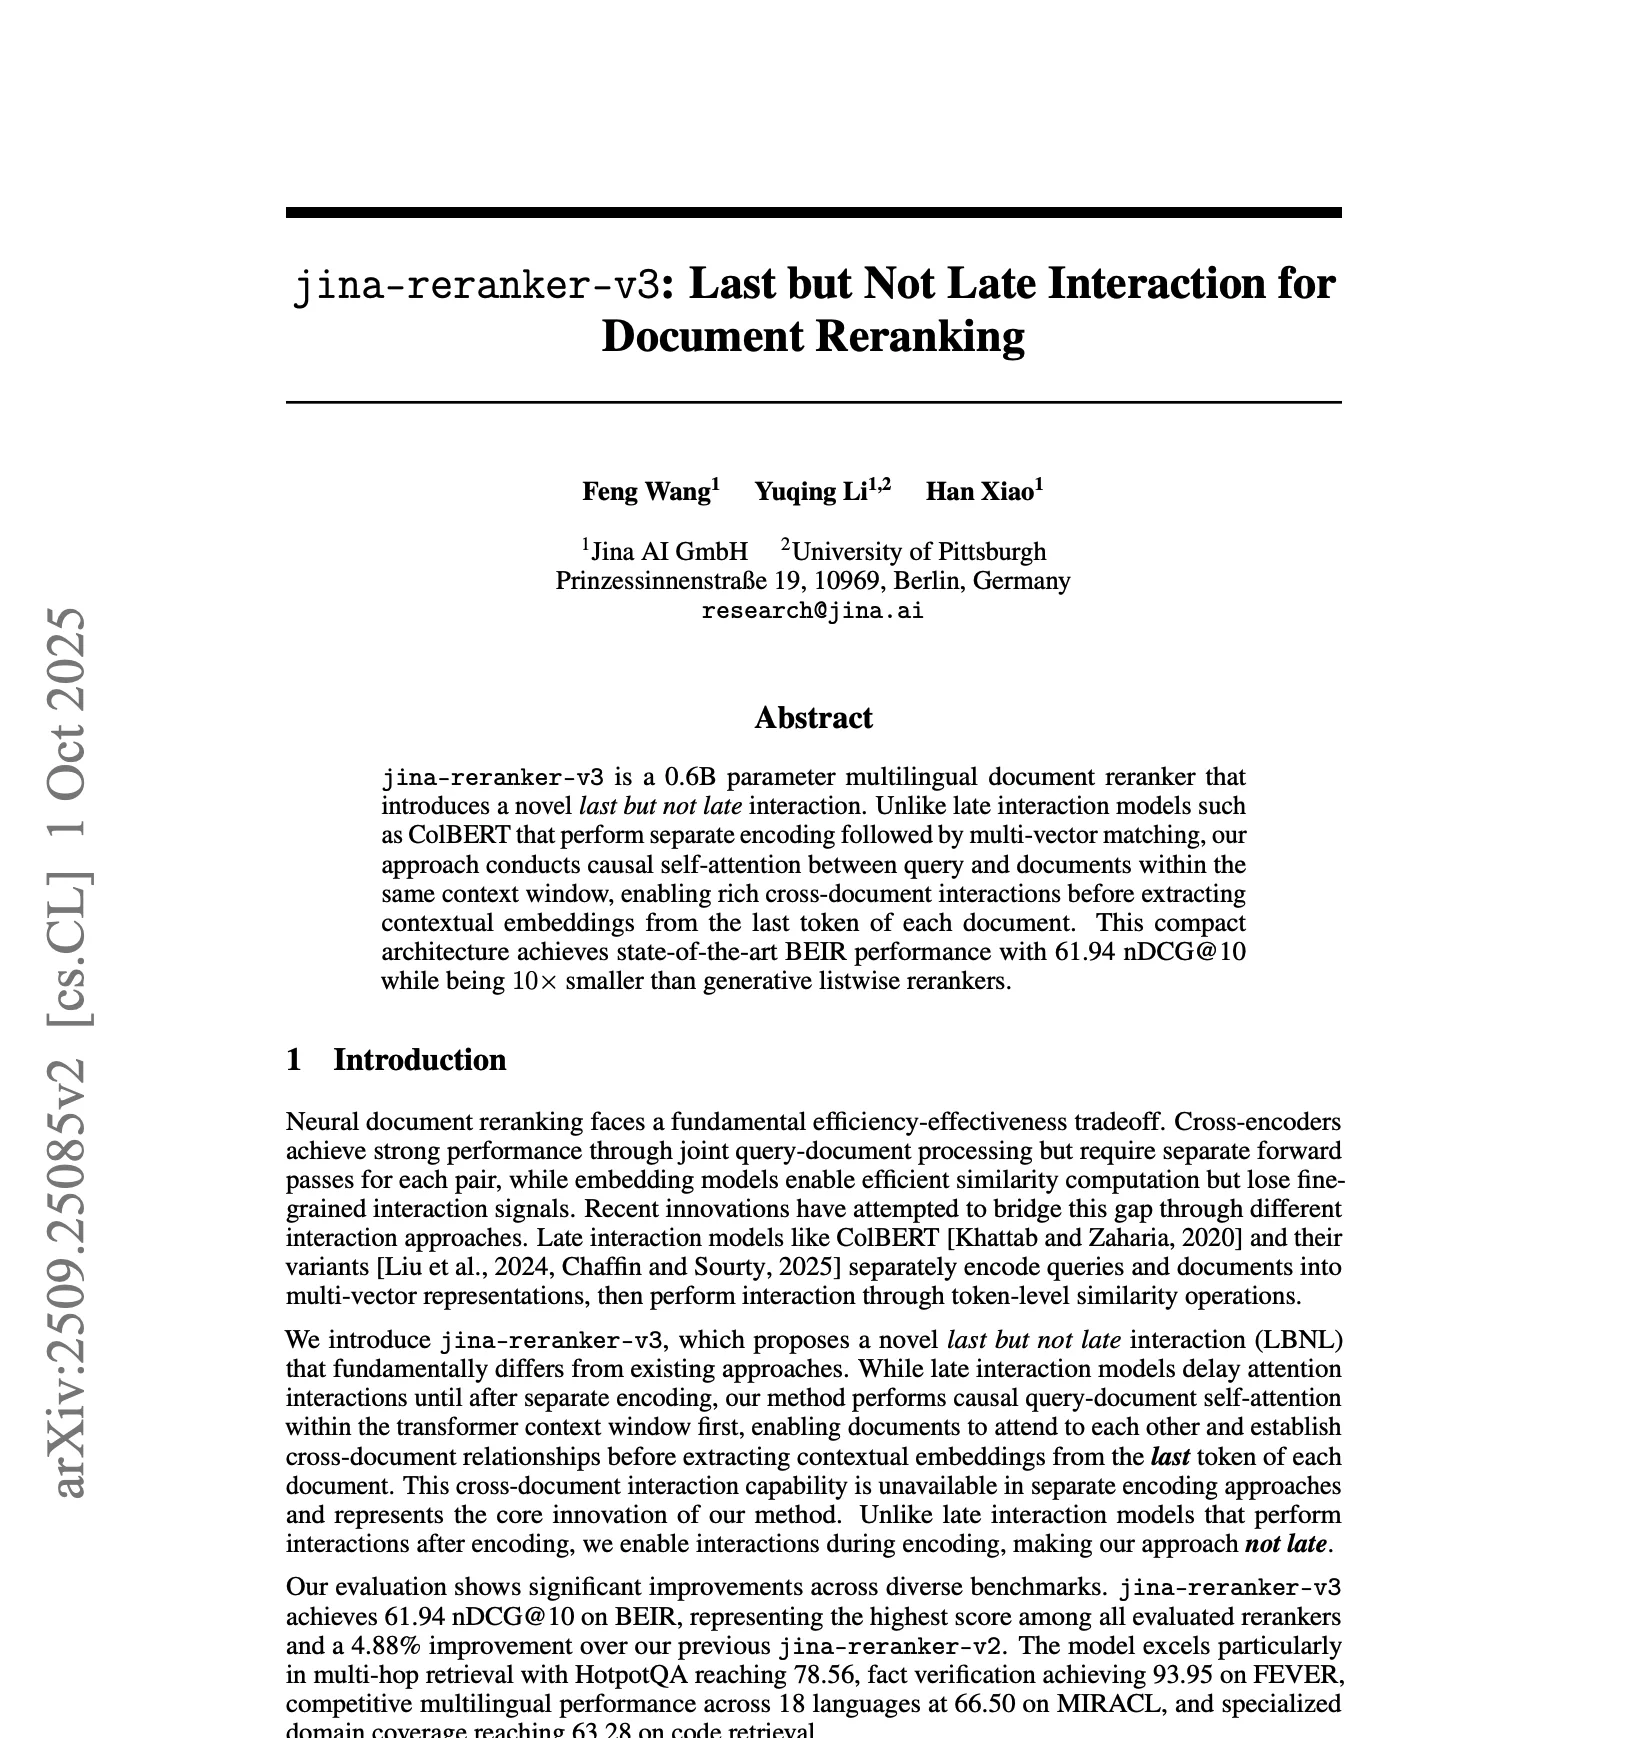
jina-reranker-v3 ist ein mehrsprachiger Listwise-Reranker mit 597M Parametern, der die Interaktion „last but not late“ (LBNL) einführt – einen Paradigmenwechsel vom paarweisen Cross-Encoder-Scoring. Statt jedes Query-Dokument-Paar isoliert zu bewerten, verarbeitet es eine gesamte Liste von Kandidatendokumenten gleichzeitig innerhalb eines einzelnen 131K-Token-Kontextfensters und nutzt kausale Attention, um Dokument-zu-Dokument-Beziehungen zu erfassen. Es erreicht State-of-the-Art-BEIR-Performance (61,94 NDCG{'@'}10) mit 2,5× weniger Parametern als der nächstbeste Wettbewerber.
Methoden
Die Kerninnovation ist die LBNL-Architektur. In einem Standard-Cross-Encoder wird jedes Query-Dokument-Paar unabhängig bewertet. In einem Late-Interaction-Modell (ColBERT) werden Dokumente separat codiert und tokenweise abgeglichen. LBNL kombiniert die Stärken beider: Query und alle Kandidatendokumente teilen einen einzelnen kausalen Attention-Kontext, sodass das Modell über Dokumente hinweg Attention berechnen und relative Relevanzsignale erfassen kann, die paarweises Scoring verfehlt. Das Modell verarbeitet bis zu 16 Dokumente pro Forward-Pass (während des Trainings ein Positives, 15 Negative), wobei jedes Dokument auf eine feste Länge gekürzt wird. Embeddings werden vom finalen Token jedes Dokuments per Last-Token-Pooling extrahiert, wobei der kausale Attention-Mechanismus die Informationen aus dem vorangehenden Kontext auf natürliche Weise aggregiert. Rotary Position Embeddings mit angepassten Basisfrequenzen ermöglichen das 131K-Token-Kontextfenster. Das Training verwendet ein dreistufiges progressives Curriculum mit einem Multi-Objective-Loss, der InfoNCE, Dispersive Loss (Gewicht 0,45), Dual-Matching-Loss (Gewicht 0,85) und Similarity Loss kombiniert.
Leistung
Auf BEIR erreicht das Modell 61,94 NDCG{'@'}10, den höchsten Wert unter allen evaluierten Rerankern und eine Verbesserung von 4,88 % gegenüber jina-reranker-v2. Es ist besonders stark bei Multi-Hop-Retrieval (78,56 auf HotpotQA) und Faktenverifizierung (93,95 auf FEVER). Die mehrsprachige Performance erreicht 66,50 auf MIRACL über 18 Sprachen, mit Arabisch bei 78,69 und Thai bei 81,06. Code-Retrieval erreicht 63,28 auf CoIR. Es übertrifft den 1,5B mxbai-rerank-large (61,44) mit 2,5× weniger Parametern und zeigt eine Verbesserung von 5,43 % gegenüber bge-reranker-v2-m3 gleicher Größe. Die Performance bleibt über verschiedene Dokumentreihenfolgen hinweg relativ stabil: zufällig (62,54), absteigend (61,94), aufsteigend (61,52) – was auf ein robustes Listwise-Scoring unabhängig von der Reihenfolge der Kandidaten hindeutet.
Empfehlungen
Verwenden Sie die strukturierte Prompt-Vorlage mit System/User/Assistant-Rollen und Sonder-Token für die Embedding-Extraktion. Verarbeiten Sie bis zu 64 Dokumente pro Forward-Pass für Sammlungen, die den 131K-Kontext überschreiten. Optimal bei Dokumenten, die zufällig oder nach absteigender Relevanz geordnet sind (Performance-Unterschied <1 %). Nutzen Sie die Dokument-zu-Dokument-Interaktionsfähigkeit für vergleichende Ranking-Aufgaben – das Listwise-Design des Modells erfasst Beziehungen zwischen Kandidaten, die paarweises Scoring verfehlt. Für mehrsprachige Anwendungen bietet das Modell starken Zero-Shot-Transfer über 18 Sprachen. Implementieren Sie Batch-Verarbeitung für große Dokumentsets und halten Sie Query-Embeddings konsistent über Batches hinweg. Die 256-dimensionalen Ausgabe-Embeddings ermöglichen effiziente Ähnlichkeitsberechnung. Ideal für Multi-Hop-Reasoning und Faktenverifizierung. Im Produktivbetrieb nutzen Sie jina-reranker-v3.5 für 1,22–1,56× schnellere Inferenz durch Hybrid-Attention.