Neuigkeiten

Beschleunigen Sie die Such-KI, Token für Token.

RSS
Hervorgehoben
Wissenschaftliche Publikationen
arXiv
September 02, 2026
jina-ocr-v1: Efficient Document Parsing with Speculative Decoding and Dense Verifiable Rewards
arXiv
Juli 20, 2026
jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation
SIGIR 2026
Mai 11, 2026
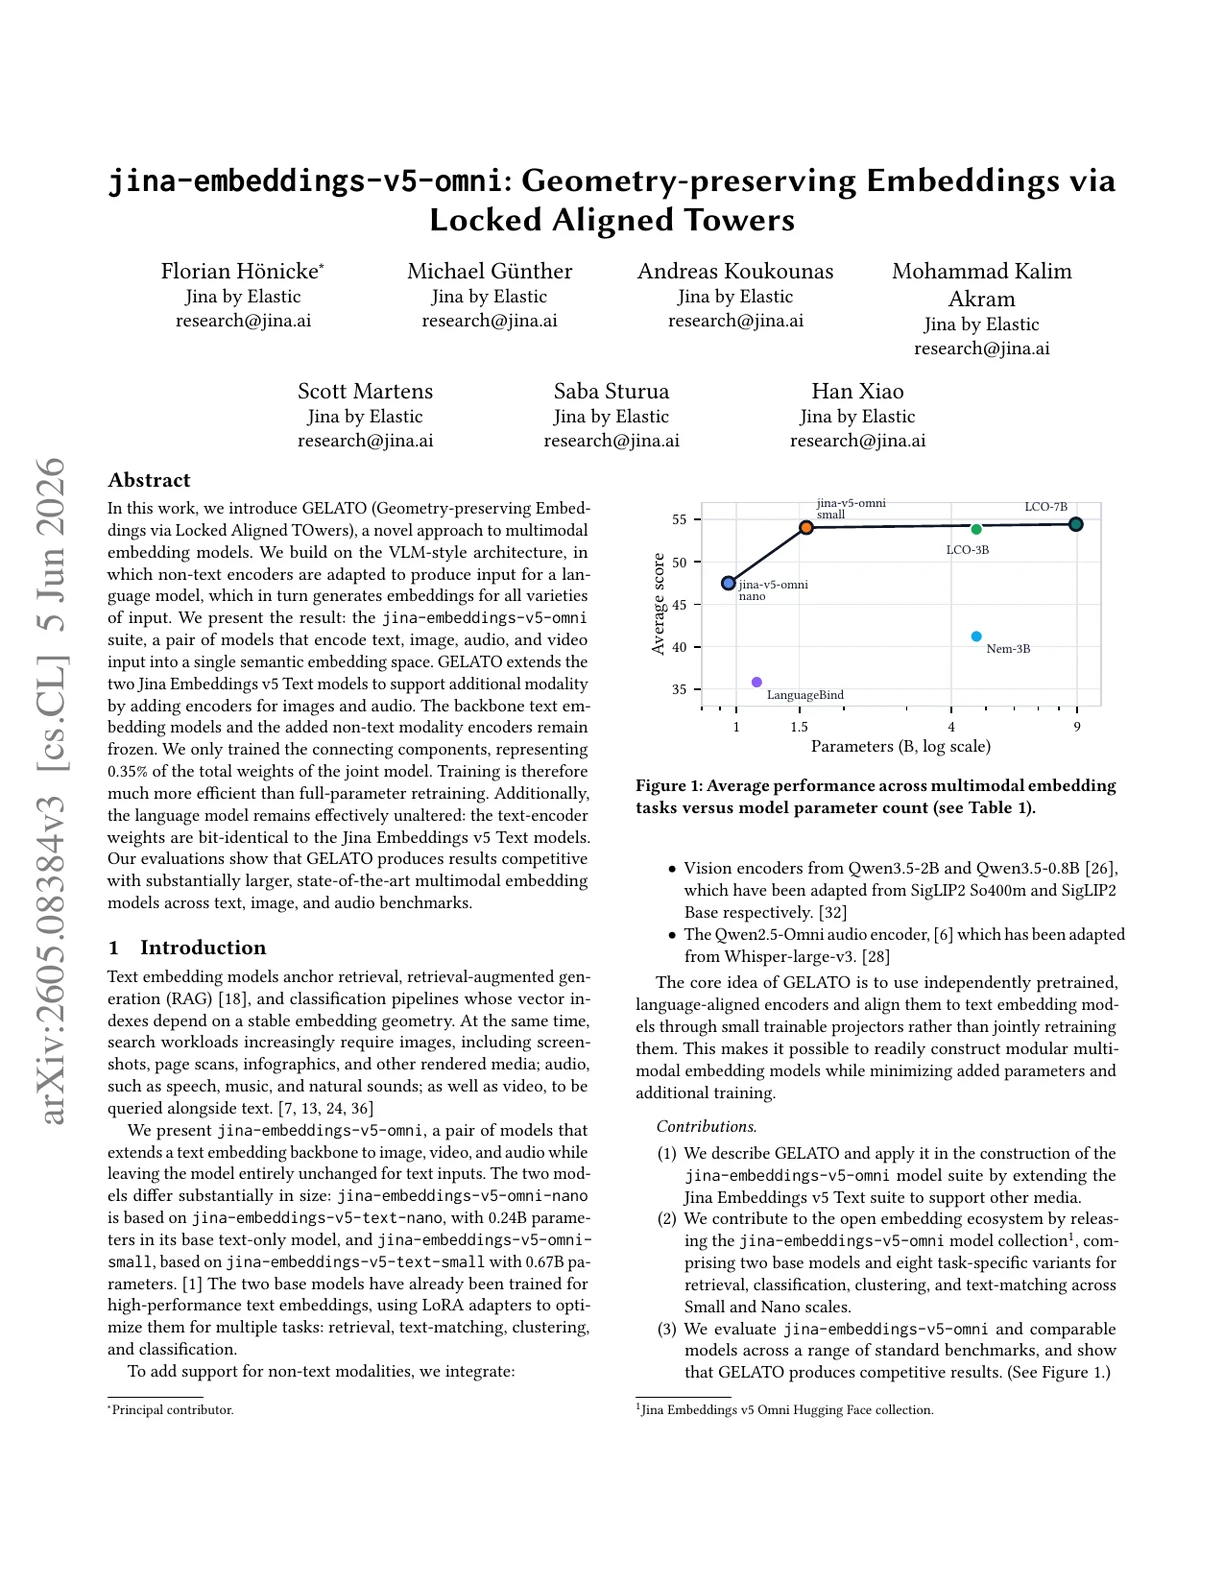
jina-embeddings-v5-omni: Geometry-preserving Embeddings via Locked Aligned Towers
SIGIR 2026
Februar 17, 2026
jina-embeddings-v5-text: Task-Targeted Embedding Distillation
ICLR 2026
Januar 22, 2026
Embedding Compression via Spherical Coordinates
arXiv
Dezember 29, 2025
Vision Encoders in Vision-Language Models: A Survey
ICLR 2026
Dezember 04, 2025
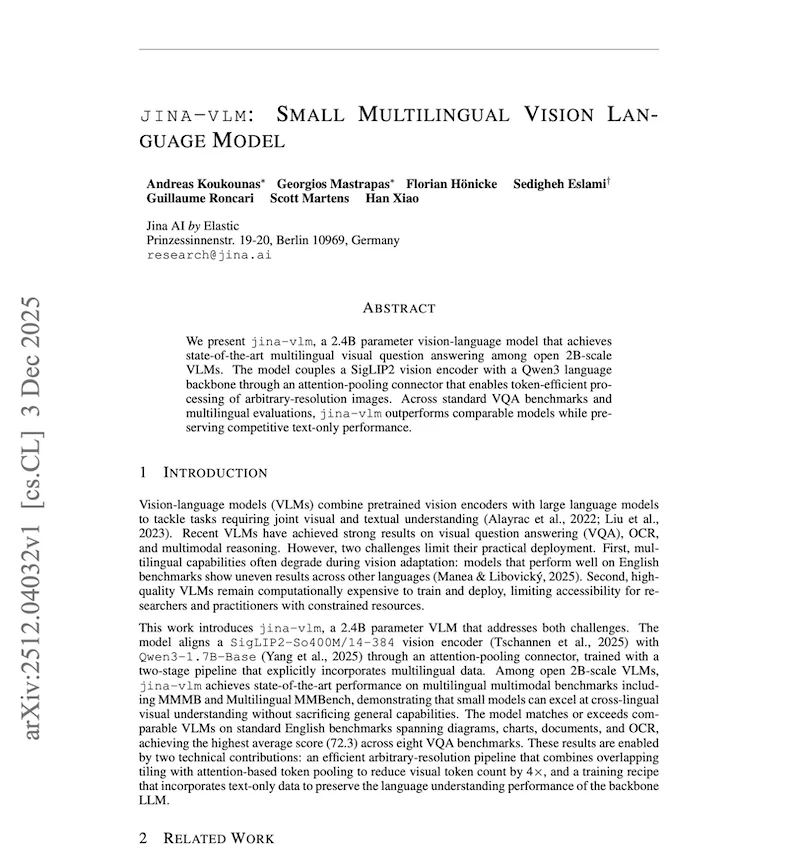
Jina-VLM: Small Multilingual Vision Language Model
AAAI 2026
Oktober 01, 2025
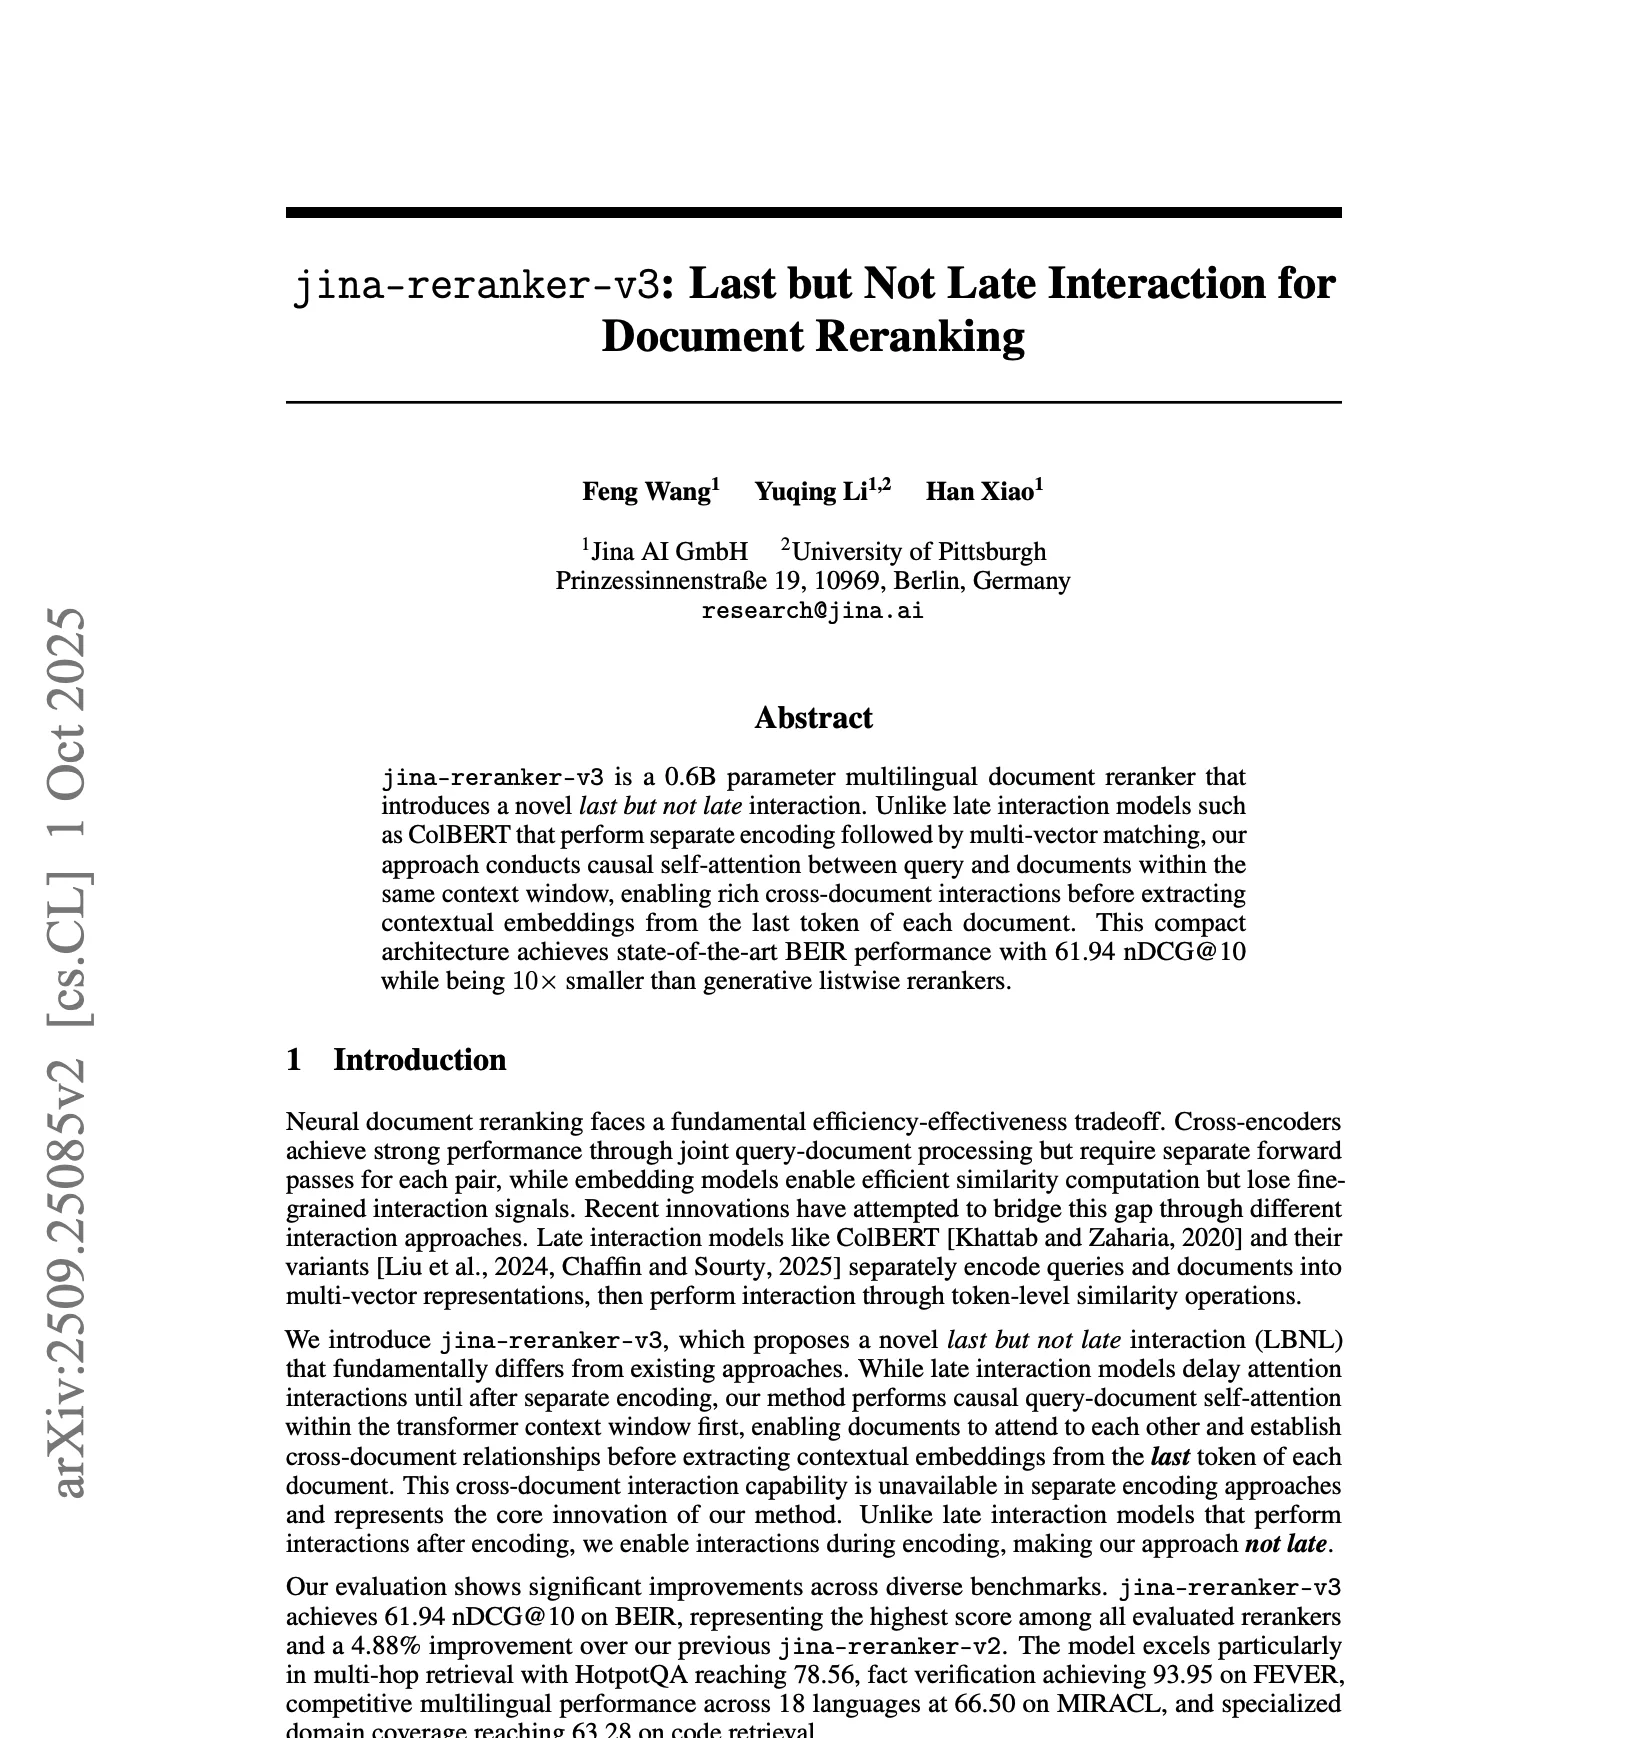
jina-reranker-v3: Last but Not Late Interaction for Document Reranking
NeurIPS 2025
August 31, 2025
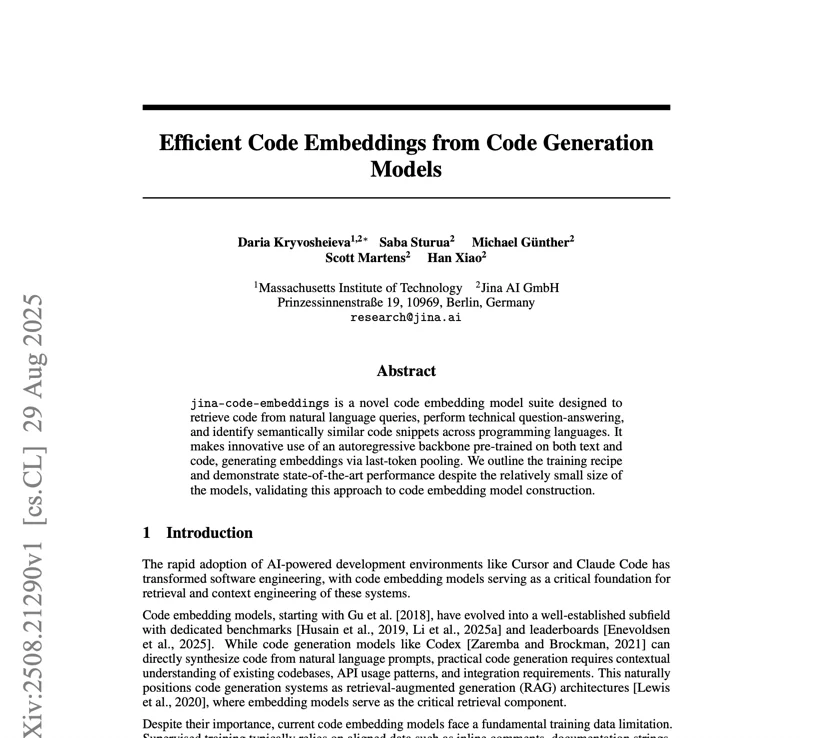
Efficient Code Embeddings from Code Generation Models
EMNLP 2025
Juni 24, 2025
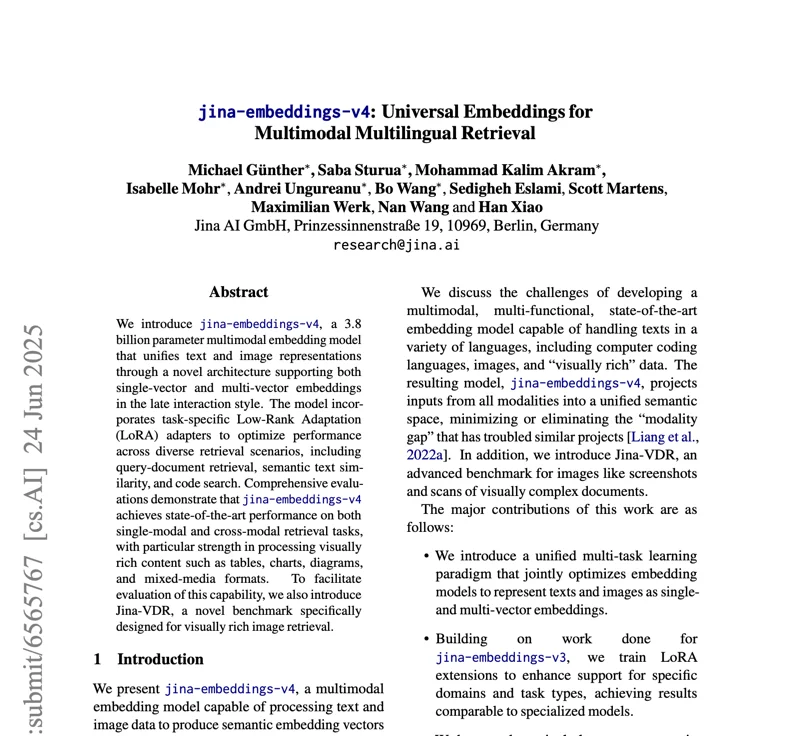
jina-embeddings-v4: Universal Embeddings for Multimodal Multilingual Retrieval
ICLR 2025
März 04, 2025
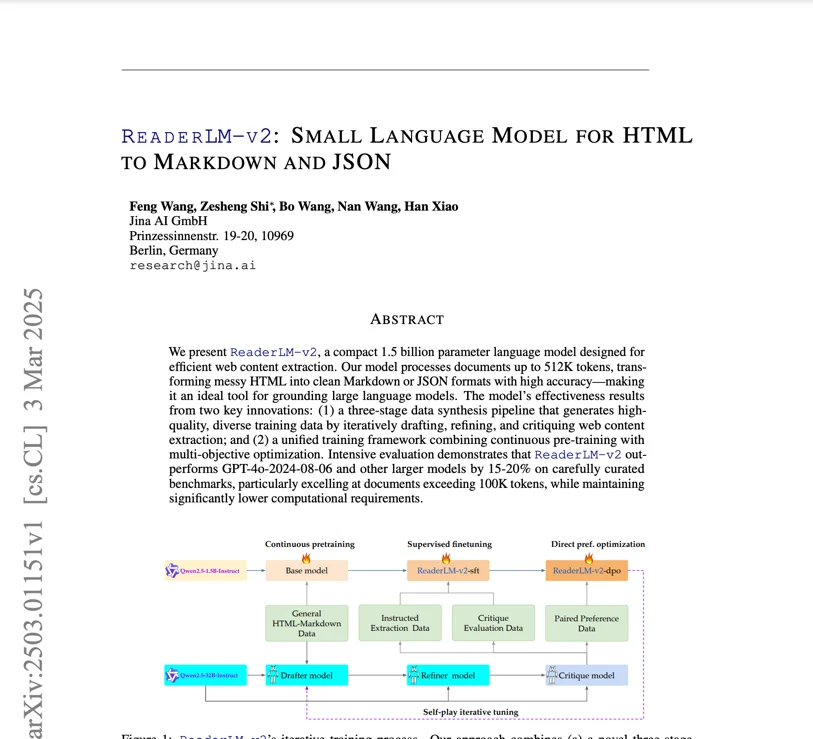
ReaderLM-v2: Small Language Model for HTML to Markdown and JSON
ACL 2025
Dezember 17, 2024
AIR-Bench: Automated Heterogeneous Information Retrieval Benchmark
ICLR 2025
Dezember 12, 2024
jina-clip-v2: Multilingual Multimodal Embeddings for Text and Images
ECIR 2025
September 18, 2024
jina-embeddings-v3: Multilingual Embeddings With Task LoRA
SIGIR 2025
September 07, 2024
Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models
EMNLP 2024
August 30, 2024
Jina-ColBERT-v2: A General-Purpose Multilingual Late Interaction Retriever
WWW 2025
Juni 21, 2024
Leveraging Passage Embeddings for Efficient Listwise Reranking with Large Language Models
ICML 2024
Mai 30, 2024
Jina CLIP: Your CLIP Model Is Also Your Text Retriever
arXiv
Februar 26, 2024
Multi-Task Contrastive Learning for 8192-Token Bilingual Text Embeddings
arXiv
Oktober 30, 2023
Jina Embeddings 2: 8192-Token General-Purpose Text Embeddings for Long Documents
EMNLP 2023
Juli 20, 2023
Jina Embeddings: A Novel Set of High-Performance Sentence Embedding Models
21 Veröffentlichungen insgesamt.

September 14, 2026 • 9 Minuten gelesen
jina-ocr-v1: Schnellere Dokumentenanalyse auf kostengünstigen GPUs
jina-ocr-v1 ist ein Vision-Language-Modell mit 3,4 Mrd. Parametern und 570 Mio. aktiven Parametern, das 91,1 Punkte bei OmniDocBench v1.6 und 83,4 Punkte bei olmOCR-Bench erzielt.
August 03, 2026 • 11 Minuten gelesen
jina-reranker-v3.5: Schnelleres listweises Reranking mit Hybrid Attention und Self-Distillation
Ein 0,6B Listwise-Reranker, der Qwen3-Reranker-4B auf BEIR übertrifft, bis zu 1,56-mal schneller als v3 neu sortiert (rerankt) und 9,6 nDCG@10 bei der semi-strukturierten Suche gewinnt.
Mai 12, 2026 • 7 Minuten gelesen
jina-embeddings-v5-omni: Embeddings für Text, Bild, Audio und Video
Ein Modell, vier Modalitäten: Text, Bild, Audio, Video. Erstklassige Omni-Embeddings mit 1,6 Mrd. und 0,9 Mrd. Parametern.
März 11, 2026 • 7 Minuten gelesen
Bootstrapping von Audio-Embeddings aus multimodalen LLMs
Verwandeln Sie jedes multimodale LLM in ein kleines Audio-Embedding-Modell, das CLAP mit 25-mal weniger Daten übertrifft.
März 06, 2026 • 6 Minuten gelesen
Identifizierung von Einbettungsmodellen anhand numerischer Rohwerte
Ein winziger Transformer, der Einbettungsmodelle durch das Lesen von rohen numerischen Ziffern per Fingerabdruck identifiziert. Kein Feature-Engineering.
Februar 19, 2026 • 7 Minuten gelesen
jina-embeddings-v3-text: Neue SOTA kleine mehrsprachige Embeddings
Zwei mehrsprachige Embeddings mit weniger als 1 Milliarde Parametern und erstklassiger Leistung, verfügbar für Elastic Inference Service, Llama.cpp und MLX.
Dezember 04, 2025 • 7 Minuten gelesen
Jina-VLM: Kleines, mehrsprachiges Vision Language Model
Neues 2B Vision-Language-Modell erzielt SOTA bei mehrsprachigem VQA, kein katastrophales Vergessen bei reinen Textaufgaben.
Oktober 03, 2025 • 7 Minuten gelesen
Jina Reranker v3: 0.6B Listwise Reranker für SOTA Multilingual Retrieval
Ein neuer Listwise-Reranker mit 0,6 Milliarden Parametern, der die Anfrage und alle Kandidatendokumente in einem einzigen Kontextfenster berücksichtigt.
September 09, 2025 • 11 Minuten gelesen
Multimodale Vektormodelle in Llama.cpp und GGUF
Wir haben multimodale VektorModelle zu llama.cpp und GGUF gebracht und dabei einige überraschende Probleme aufgedeckt.
September 04, 2025 • 6 Minuten gelesen

Jina Code Embeddings: SOTA Code Retrieval bei 0.5B und 1.5B
Code generierende LLMs → Code-Vektor-Modelle: 0,5B/1,5B Modelle erzielen SOTA-Performance über 25 Code-Retrieval-Benchmarks hinweg.