


Reader
Eine URL lässt sich in ein LLM-kompatibles Eingabeformat umwandeln, indem man
r.jina.ai voranstellt.Reader-API
Eine URL lässt sich in ein LLM-kompatibles Eingabeformat umwandeln, indem man
r.jina.ai voranstellt.globe_book
Verwenden Sie
r.jina.ai, um eine URL zu lesen und ihren Inhalt abzurufentravel_explore
Verwenden Sie
s.jina.ai, um im Web zu suchen und SERP zu erhalten
Fügen Sie
mcp.jina.ai als MCP-Server hinzu, um unsere APIs von jedem LLM aus aufzurufencurl "https://r.jina.ai/https://www.example.com"jina-ocr-v1: Schnelleres Dokumenten-Parsing auf GPUs mit kleinem Budget
Ein Mixture-of-Experts-Dokumentenparser mit 3,4 Milliarden Parametern, von denen pro Token nur 570 Millionen aktiv sind. Er liest ein Seitenbild und liefert in einem Durchgang Markdown mit Text, Formeln, Tabellen und Lesereihenfolge.
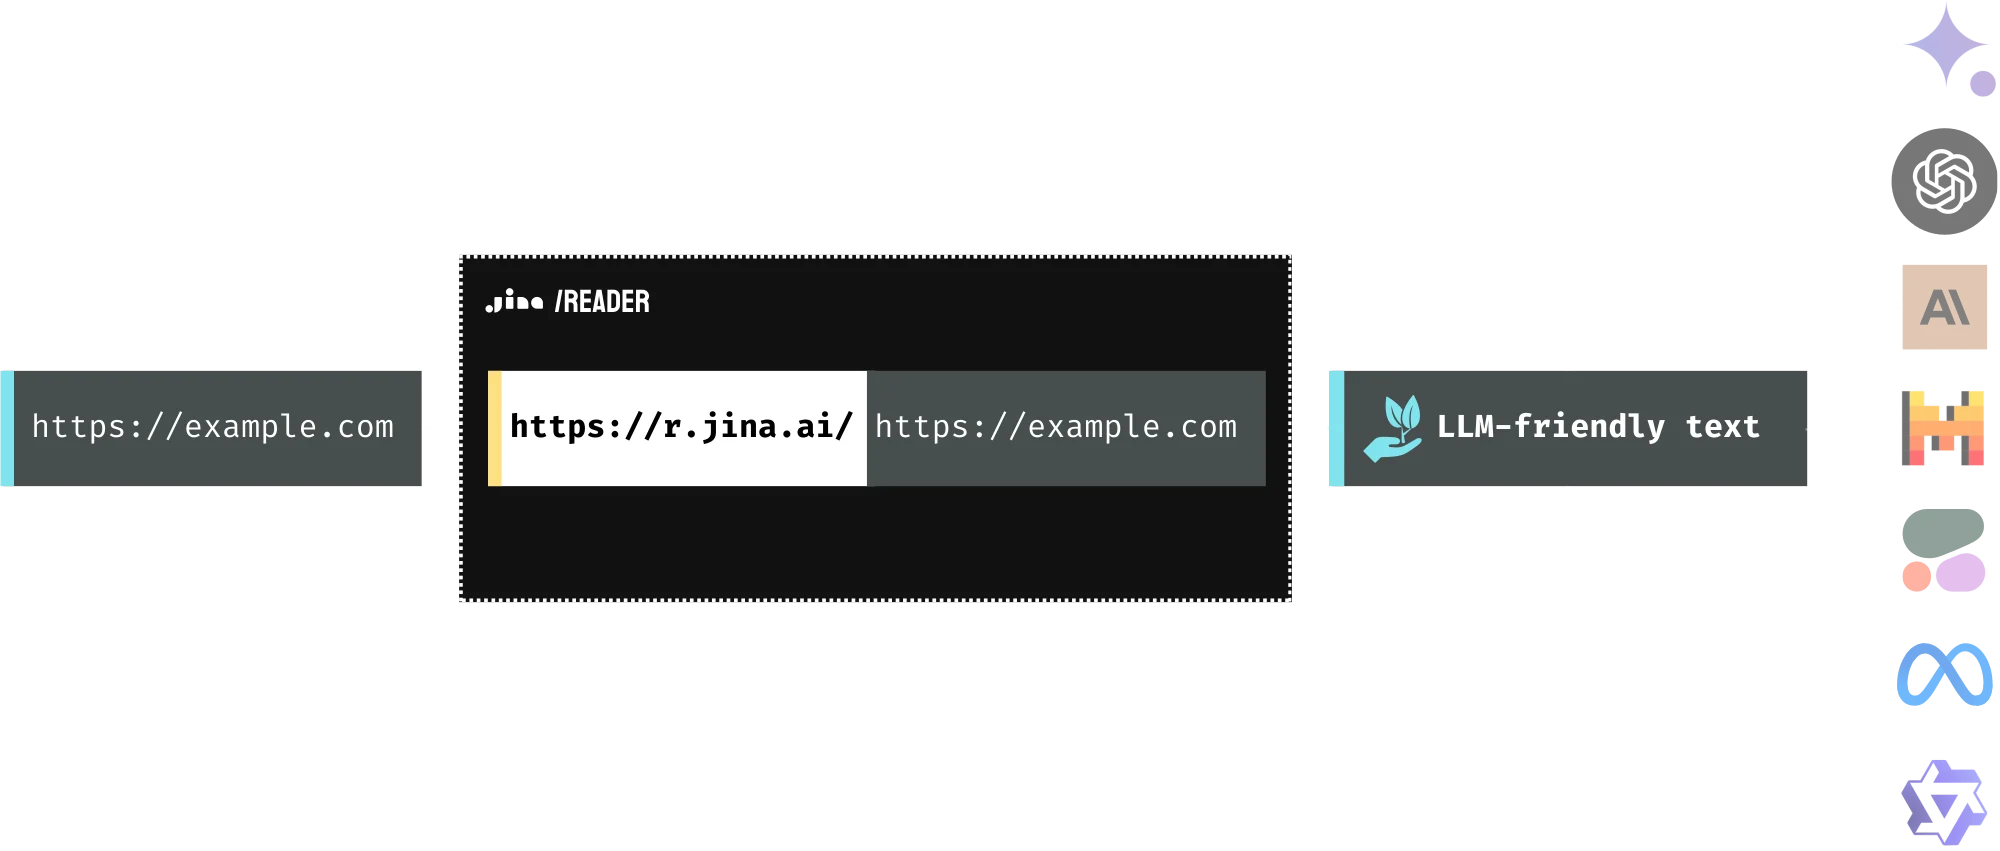
Die Integration von Webinformationen in LLMs ist ein wichtiger, aber mitunter schwieriger Schritt des Groundings. Die einfachste Methode besteht darin, die Webseite zu scrapen und das rohe HTML zu verwenden. Scraping kann jedoch komplex sein und wird oft blockiert, und rohes HTML ist voll von überflüssigen Elementen wie Markup und Skripten. Die Reader API löst diese Probleme, indem sie den Kerninhalt einer URL extrahiert und in sauberen, LLM-kompatiblen Text umwandelt. So wird eine hohe Datenqualität für Ihre Agenten- und RAG-Systeme gewährleistet. Die Reader API ist eine Entwicklerinfrastruktur: Sie wandelt eine von Ihnen bereitgestellte URL in LLM-kompatiblen Text um, sodass Sie Ihre eigenen Such-, RAG- und Agentensysteme erstellen können. Sie ist keine Suchmaschine für Endverbraucher und indexiert oder rankt das Web nicht in Ihrem Auftrag. Sie bestimmen, welche URLs verarbeitet werden und sind für die Verwendung der Ergebnisse verantwortlich.
Rohes HTML
Reader-Ausgabe
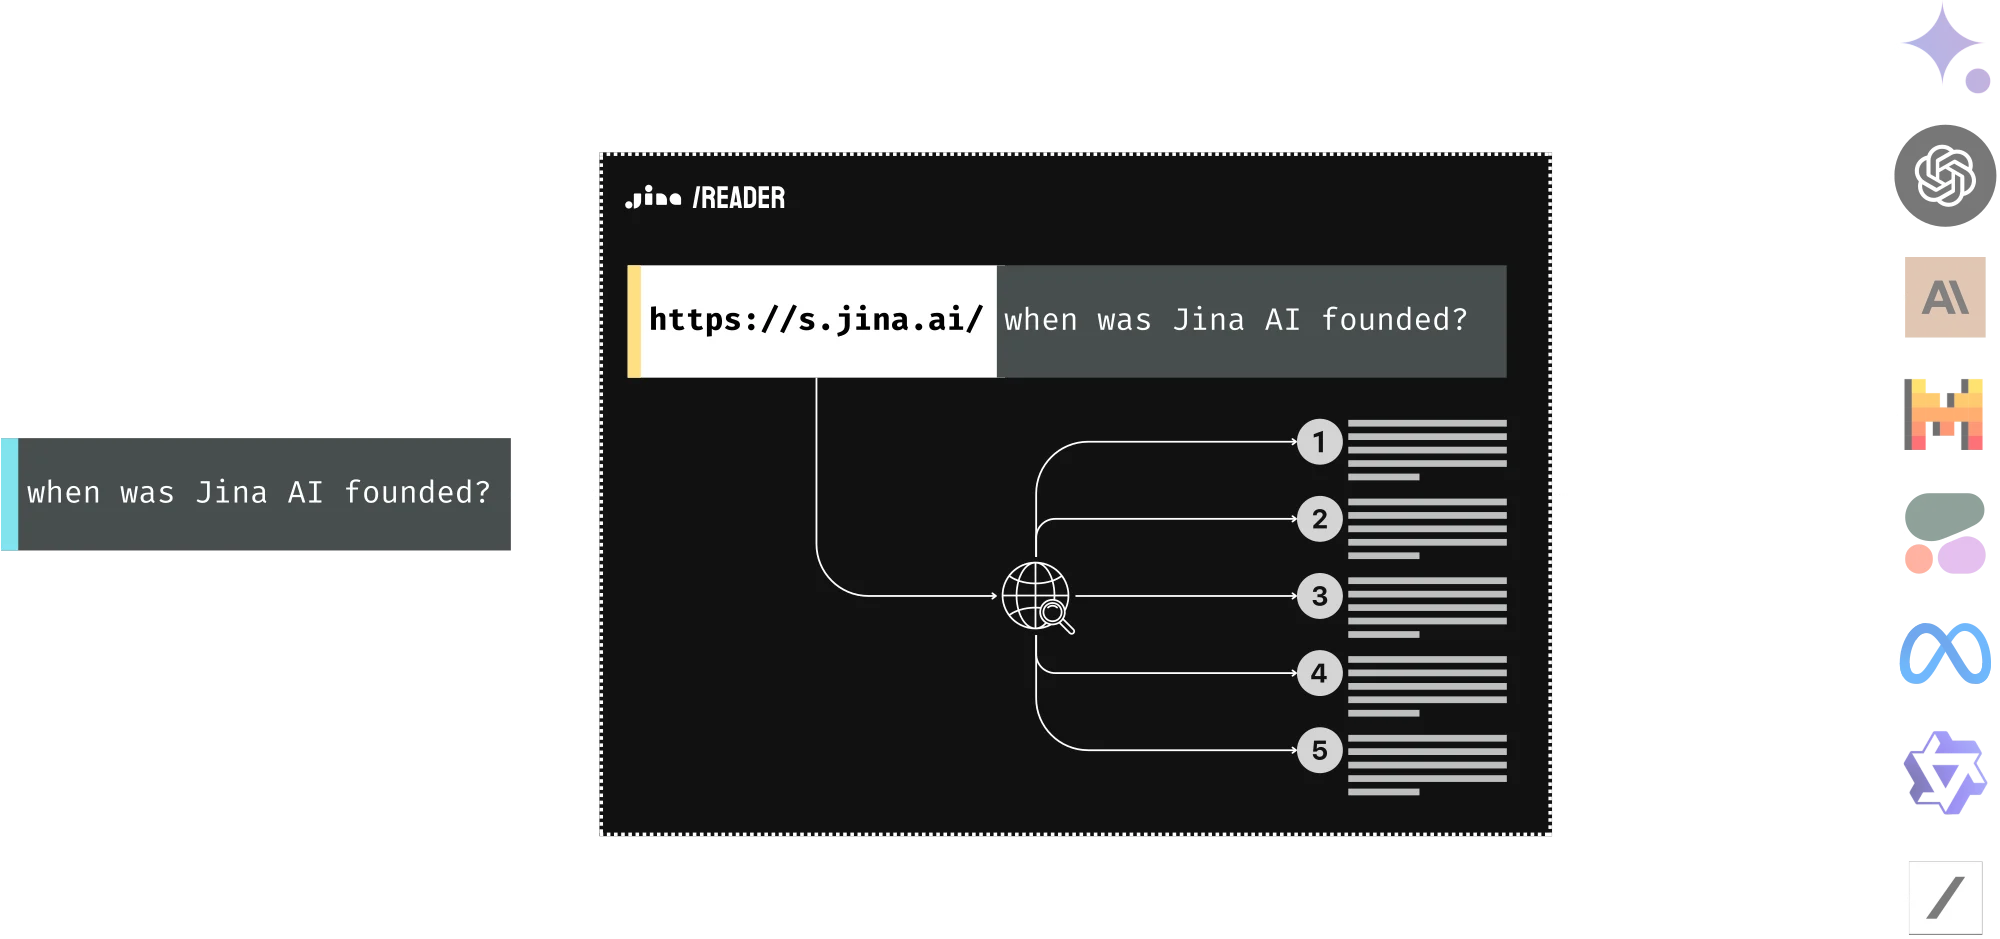
Reader kann als SERP-API verwendet werden. Damit können Sie Ihr LLM mit den Inhalten hinter der Suchergebnisseite versorgen. Stellen Sie Ihrer Abfrage einfach
https://s.jina.ai/?q= voran, und Reader durchsucht das Web und gibt die fünf besten Ergebnisse mit ihren URLs und Inhalten zurück, jeweils in sauberem, LLM-freundlichem Text. Auf diese Weise können Sie Ihr LLM immer auf dem neuesten Stand halten, seine Faktentreue verbessern und Halluzinationen reduzieren.info Bitte beachten Sie, dass Sie in der Praxis – anders als in der Demo oben – nicht die ursprüngliche Frage im Web suchen, um sie zu belegen. Üblich ist, die ursprüngliche Frage umzuschreiben oder Multi-Hop-Fragen zu verwenden. Sie lesen die abgerufenen Ergebnisse und erzeugen dann bei Bedarf weitere Abfragen, um zusätzliche Informationen zu sammeln, bevor Sie zu einer endgültigen Antwort gelangen.
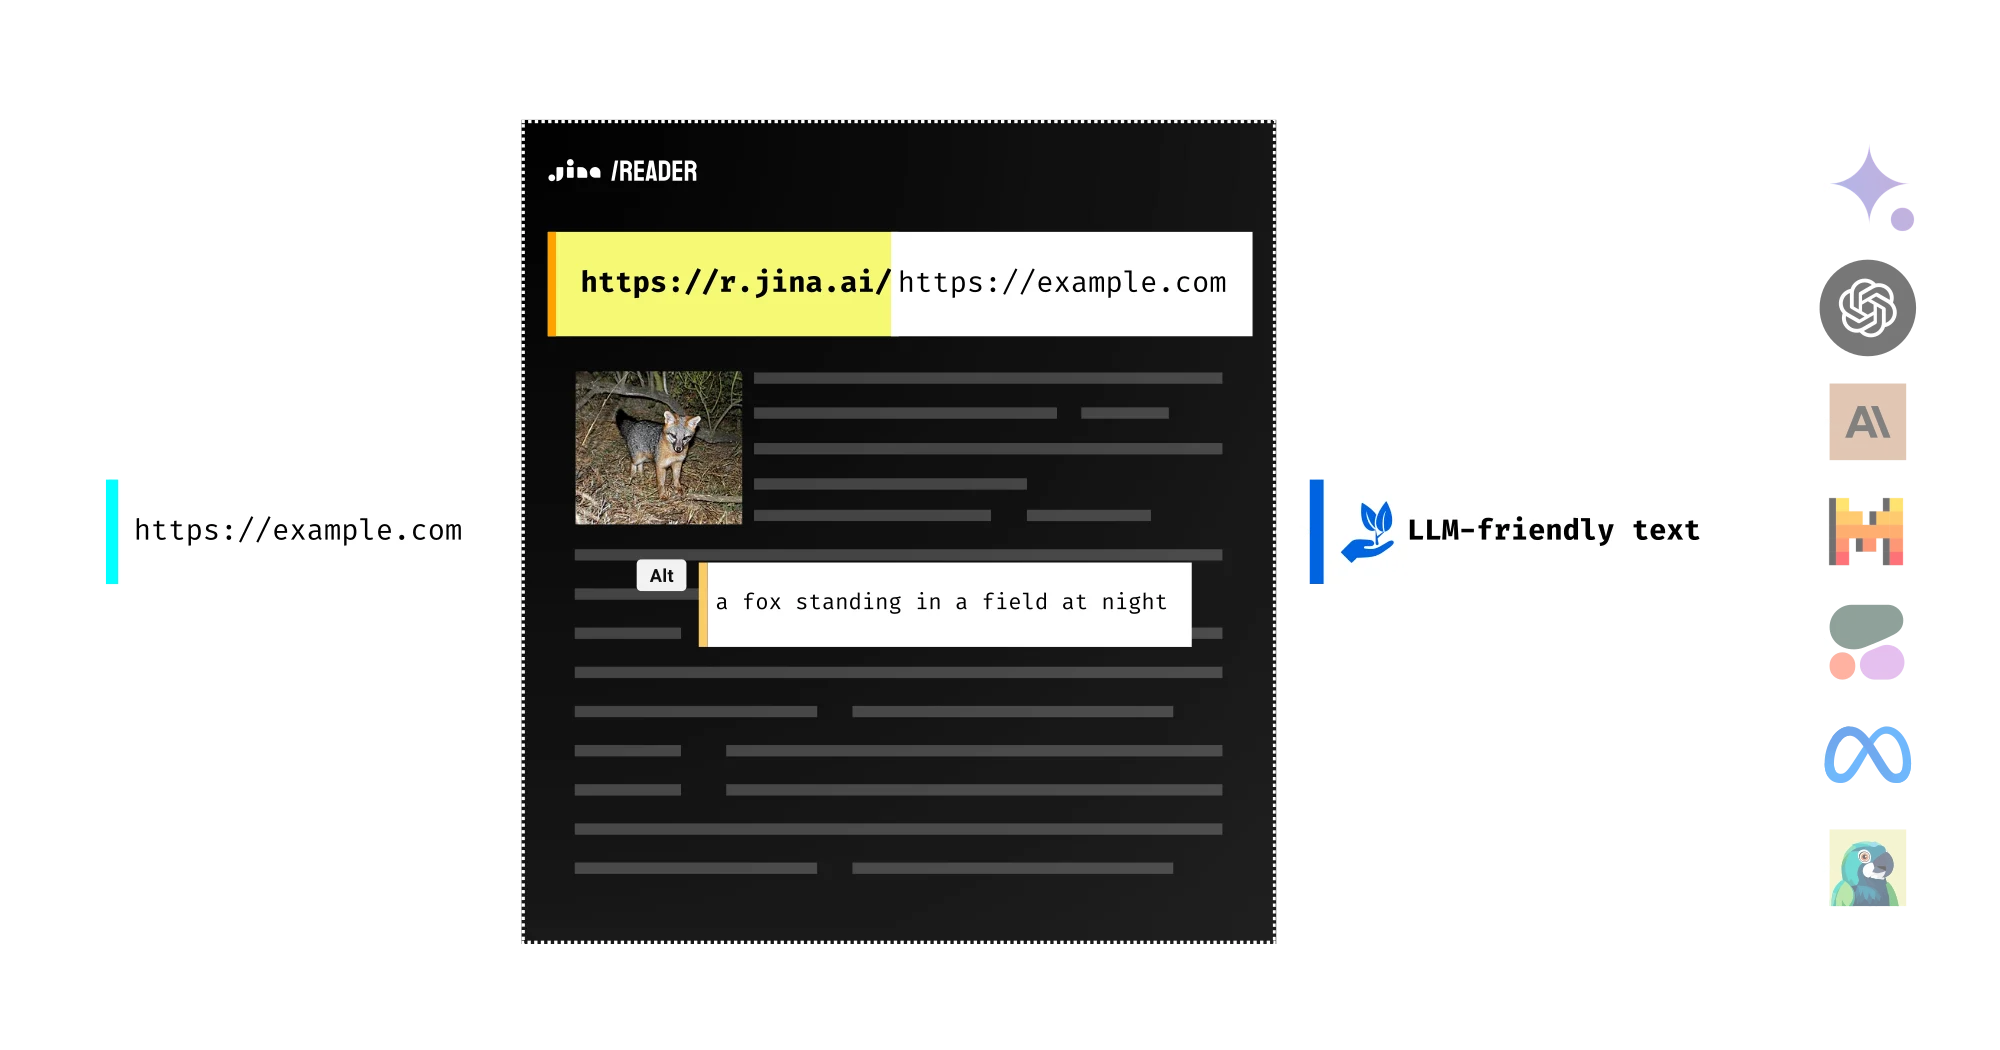
Bilder auf der Webseite werden mithilfe eines Vision-Language-Modells im Reader automatisch mit Bildunterschriften versehen und in der Ausgabe als Bild-Alt-Tags formatiert. Dadurch erhält Ihr nachgelagertes LLM gerade genug Hinweise, um diese Bilder in seine Denk- und Zusammenfassungsprozesse einzubeziehen. Das bedeutet, dass Sie Fragen zu den Bildern stellen, bestimmte Bilder auswählen oder sogar ihre URLs zur tieferen Analyse an ein leistungsfähigeres VLM weiterleiten können!
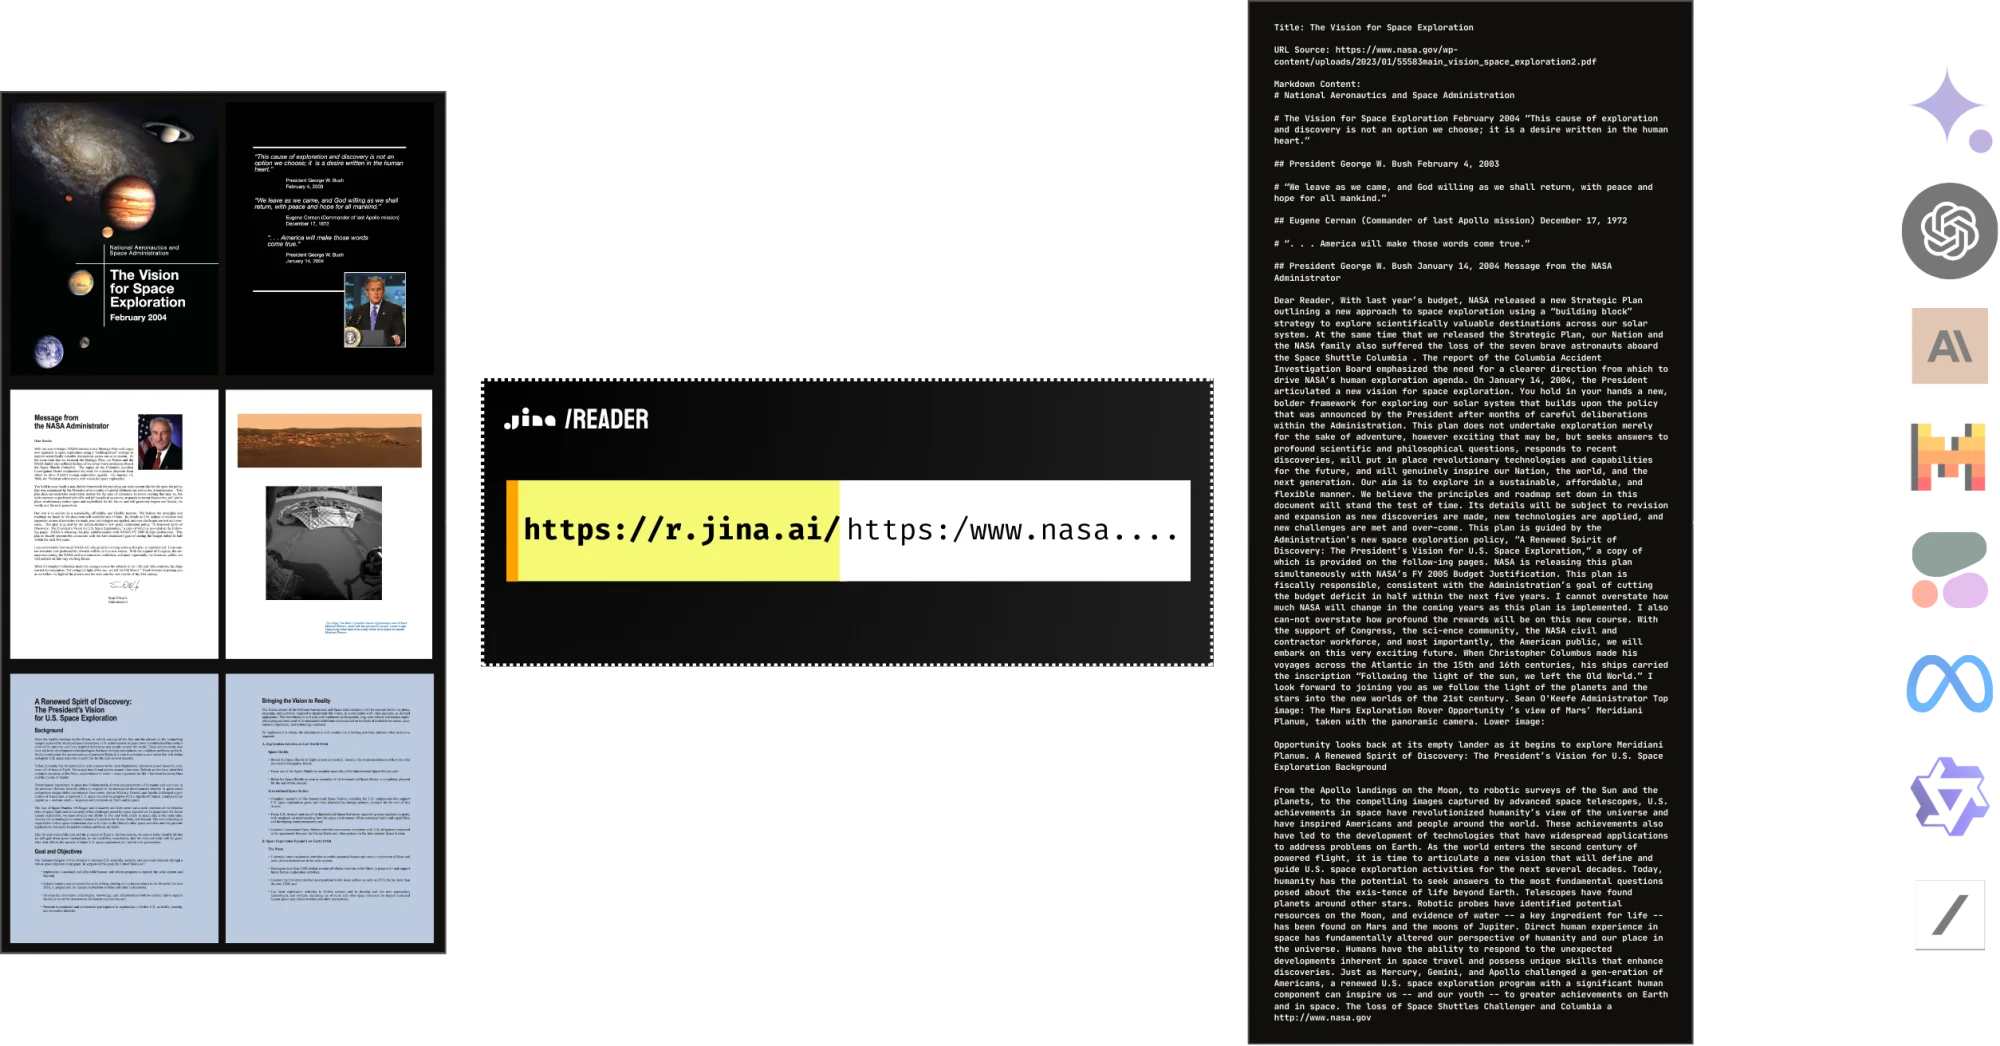
Ja, Reader unterstützt das Lesen von PDFs nativ. Er ist mit den meisten PDFs kompatibel, auch mit PDFs, die viele Bilder enthalten, und er ist blitzschnell! In Kombination mit einem LLM können Sie im Handumdrehen ganz einfach eine ChatPDF- oder Dokumentenanalyse-KI erstellen.
Und das Beste daran? Es ist kostenlos!
Die Reader API ist kostenlos erhältlich und bietet flexible Ratenlimits und Preise. Sie basiert auf einer skalierbaren Infrastruktur und bietet hohe Verfügbarkeit, Parallelität und Zuverlässigkeit. Wir möchten die bevorzugte Grounding-Lösung für Ihre LLMs sein.
Ratenlimit
Ratenlimits werden auf zwei Arten erfasst: RPM (Anfragen pro Minute) und TPM (Token pro Minute). Die Limits gelten pro IP-Adresse bzw. API-Schlüssel und greifen, sobald der RPM- oder der TPM-Schwellenwert erreicht wird. Wenn Sie im Request-Header einen API-Schlüssel angeben, erfassen wir die Ratenlimits pro Schlüssel und nicht nach IP-Adresse.
| Produkt | API-Endpunkt | Beschreibungarrow_upward | ohne Schlüsselkey_off | mit Gratis-Schlüsselkey | mit bezahltem Schlüsselkey | mit Premium-Schlüsselkey | Ø Latenz | Zählung der Token-Nutzung | HTTP-Methode | |
|---|---|---|---|---|---|---|---|---|---|---|
| Reader-API | https://r.jina.ai | URL in LLM-freundlichen Text konvertieren | 20 RPM | 500 RPM | 500 RPM | trending_up5000 RPM | 7.9s | Anzahl der Token in der Ausgabeantwort zählen | GET/POST | |
| Reader-API | https://s.jina.ai | Das Web durchsuchen und die Ergebnisse in LLM-freundlichen Text konvertieren | block | 100 RPM | 100 RPM | trending_up1000 RPM | 2.5s | Jede Anfrage kostet eine feste Anzahl an Token, beginnend bei 10.000 Token | GET/POST | |
| Embeddings-API | https://api.jina.ai/v1/embeddings | Text/Bilder in Vektoren mit fester Länge konvertieren | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart hängt von der Eingangsgröße ab help | Anzahl der Token in der Eingabeanforderung zählen | POST | |
| Reranker-API | https://api.jina.ai/v1/rerank | Dokumente nach Abfrage ordnen | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart hängt von der Eingangsgröße ab help | Anzahl der Token in der Eingabeanforderung zählen | POST |


Keine Panik! Jeder neue API-Schlüssel enthält 10 Mio. kostenlose Token!
API-Preise
Die API-Preise basieren auf der Token-Nutzung. Ein API-Schlüssel gibt Ihnen Zugriff auf alle Search-Foundation-Produkte.

Mit Jina Search-Foundation-API
Der einfachste Weg, auf alle unsere Produkte zuzugreifen. Laden Sie Token nach Bedarf auf.
key
verified_user
Laden Sie diesen API-Schlüssel mit weiteren Token auf
Bitte geben Sie zum Aufladen den richtigen API-Schlüssel ein.
speed
Verstehen Sie das Ratenlimit
Ratenlimits begrenzen, wie viele Anfragen (RPM) und Token (TPM) pro Minute und IP-Adresse oder API-Schlüssel an eine API gesendet werden können. Weitere Informationen zu den Limits für jedes Produkt und jede Stufe finden Sie unten.
keyboard_arrow_down

Welche Kosten sind mit der Nutzung der Reader-API verbunden?
keyboard_arrow_down
Wie funktioniert die Reader-API?
keyboard_arrow_down
Ist die Reader-API Open Source?
keyboard_arrow_down
Wie hoch ist die typische Latenz für die Reader-API?
keyboard_arrow_down
Warum sollte ich die Reader-API verwenden, anstatt die Seite selbst zu scrapen?
keyboard_arrow_down
Unterstützt die Reader-API mehrere Sprachen?
keyboard_arrow_down
Berücksichtigt die Reader-API die Zugriffskontrollen der Website?
keyboard_arrow_down
Kann die Reader-API Inhalte aus PDF-Dateien extrahieren?
keyboard_arrow_down
Kann die Reader-API Medieninhalte von Webseiten verarbeiten?
keyboard_arrow_down
Ist es möglich, die Reader-API auf lokale HTML-Dateien anzuwenden?
keyboard_arrow_down
Speichert die Reader-API den Inhalt im Cache?
keyboard_arrow_down
Kann ich die Reader-API verwenden, um auf Inhalte hinter einer Anmeldung zuzugreifen?
keyboard_arrow_down
Kann ich mit der Reader-API PDFs auf arXiv abrufen?
keyboard_arrow_down
Wie funktioniert die Bildbeschreibung im Reader?
keyboard_arrow_down
Wie skalierbar ist der Reader? Kann ich ihn in der Produktion einsetzen?
keyboard_arrow_down
Wie hoch ist das Ratenlimit der Reader-API?
keyboard_arrow_down
Was ist ReaderLM? Wie kann ich es verwenden?
keyboard_arrow_down
Wie extrahiere ich strukturierte Daten von Webseiten?
keyboard_arrow_down
Umgeht Reader aktiv den Anti-Bot-Schutz der Website?
keyboard_arrow_down
Erhalte ich durch das Upgrade von einem kostenlosen auf einen kostenpflichtigen API-Schlüssel Zugriff auf mehr Websites?
keyboard_arrow_down
Kann ich Reader innerhalb meiner eigenen Infrastruktur ausführen?
keyboard_arrow_down
Ratenlimit
Ratenlimits werden auf zwei Arten erfasst: RPM (Anfragen pro Minute) und TPM (Token pro Minute). Die Limits gelten pro IP-Adresse bzw. API-Schlüssel und greifen, sobald der RPM- oder der TPM-Schwellenwert erreicht wird. Wenn Sie im Request-Header einen API-Schlüssel angeben, erfassen wir die Ratenlimits pro Schlüssel und nicht nach IP-Adresse.
| Produkt | API-Endpunkt | Beschreibungarrow_upward | ohne Schlüsselkey_off | mit Gratis-Schlüsselkey | mit bezahltem Schlüsselkey | mit Premium-Schlüsselkey | Ø Latenz | Zählung der Token-Nutzung | HTTP-Methode | |
|---|---|---|---|---|---|---|---|---|---|---|
| Reader-API | https://r.jina.ai | URL in LLM-freundlichen Text konvertieren | 20 RPM | 500 RPM | 500 RPM | trending_up5000 RPM | 7.9s | Anzahl der Token in der Ausgabeantwort zählen | GET/POST | |
| Reader-API | https://s.jina.ai | Das Web durchsuchen und die Ergebnisse in LLM-freundlichen Text konvertieren | block | 100 RPM | 100 RPM | trending_up1000 RPM | 2.5s | Jede Anfrage kostet eine feste Anzahl an Token, beginnend bei 10.000 Token | GET/POST | |
| Embeddings-API | https://api.jina.ai/v1/embeddings | Text/Bilder in Vektoren mit fester Länge konvertieren | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart hängt von der Eingangsgröße ab help | Anzahl der Token in der Eingabeanforderung zählen | POST | |
| Reranker-API | https://api.jina.ai/v1/rerank | Dokumente nach Abfrage ordnen | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart hängt von der Eingangsgröße ab help | Anzahl der Token in der Eingabeanforderung zählen | POST |
Häufige Fragen zu APIs
code
Kann ich denselben API-Schlüssel für alle Jina-APIs verwenden?
keyboard_arrow_down
code
Kann ich die Token-Nutzung meines API-Schlüssels überwachen?
keyboard_arrow_down
code
Was soll ich tun, wenn ich meinen API-Schlüssel vergesse?
keyboard_arrow_down
code
Laufen API-Schlüssel ab?
keyboard_arrow_down
code
Kann ich Token zwischen API-Schlüsseln übertragen?
keyboard_arrow_down
code
Kann ich meinen API-Schlüssel widerrufen?
keyboard_arrow_down
code
Warum ist die erste Anfrage für einige Modelle langsam?
keyboard_arrow_down
code
Werden meine API-Daten zum Trainieren Ihrer Modelle verwendet?
keyboard_arrow_down
code
Welche Ratenlimits gelten für Jina-APIs?
keyboard_arrow_down
code
Gibt es Beschränkungen hinsichtlich der Batchgröße für die APIs?
keyboard_arrow_down
code
Sind die Jina-APIs dasselbe wie die Jina-Modelle innerhalb von Elastic?
keyboard_arrow_down
Häufige Fragen zur Abrechnung
attach_money
Erfolgt die Abrechnung nach der Anzahl der Sätze bzw. Anfragen?
keyboard_arrow_down
attach_money
Gibt es eine kostenlose Testversion für neue Benutzer?
keyboard_arrow_down
attach_money
Werden für fehlgeschlagene Anfragen Token berechnet?
keyboard_arrow_down
attach_money
Welche Zahlungsmethoden werden akzeptiert?
keyboard_arrow_down
attach_money
Ist eine Rechnungsstellung für Token-Käufe verfügbar?
keyboard_arrow_down
attach_money
Wie kann ich eine kommerzielle Lizenz anstelle von API-Tokens erwerben?
keyboard_arrow_down
attach_money
Kann ich per Rechnung oder Bestellschein statt per Karte bezahlen?
keyboard_arrow_down
attach_money
Ich habe bezahlt, aber mein Kontostand oder mein Ratenlimit hat sich nicht geändert. Was sollte ich überprüfen?
keyboard_arrow_down
attach_money
Wie kann ich eine Zahlung stornieren, die automatische Aufladung stoppen oder eine gespeicherte Zahlungsmethode entfernen?
keyboard_arrow_down
