Reader
LM-v2
 API de Reader
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-gapped
Resumen
ReaderLM-v2 es un modelo de lenguaje pequeño de 1,54B parámetros que transforma HTML desordenado en Markdown o JSON limpio con alta precisión, procesando documentos hasta 512K tokens. Es la herramienta ideal para el Grounding de grandes modelos de lenguaje: convierte contenido web en formatos estructurados que los LLM pueden consumir de forma eficiente. Supera a Qwen2.5-32B-Instruct y Gemini2-flash-expr en tareas de HTML a Markdown y funciona a una fracción de su costo.
Métodos
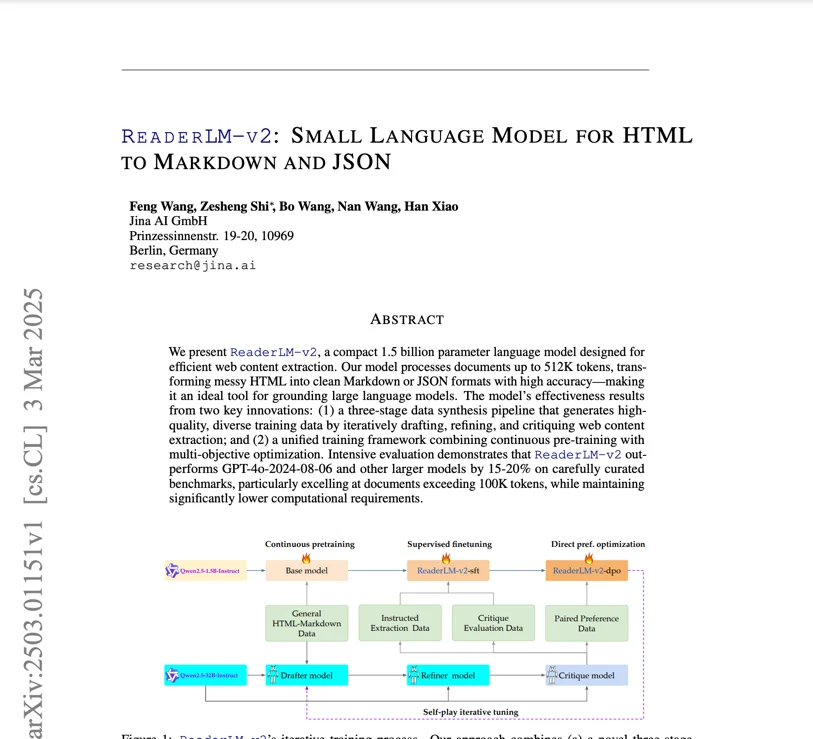
La eficacia del modelo se debe a dos innovaciones clave. En primer lugar, un pipeline de síntesis de datos de tres etapas genera datos de entrenamiento de alta calidad y diversos redactando, refinando y criticando de forma iterativa la extracción de contenido web: este enfoque de datos sintéticos asegura que el modelo vea una amplia variedad de estructuras HTML sin necesidad de anotación manual. En segundo lugar, un marco de entrenamiento unificado combina el preentrenamiento continuo con la optimización multiobjetivo, lo que permite al modelo aprender simultáneamente la conversión de HTML a Markdown y de HTML a JSON. La arquitectura decoder-only 'shallow-but-wide' (28 capas, 1536 dimensiones ocultas, 12 cabezas de consulta y 2 cabezas KV) está optimizada para operaciones de copia selectiva. El contexto de 512K tokens se habilita mediante zigzag-ring-attention. El entrenamiento con pérdida contrastiva reduce significativamente los problemas de degeneración.
Rendimiento
En tareas de HTML a Markdown, el modelo alcanza un ROUGE-L de 0,84, un Jaro-Winkler de 0,82 y una distancia de Levenshtein de 0,22, superando a Qwen2.5-32B-Instruct y Gemini2-flash-expr. En tareas de HTML a JSON mantiene un rendimiento competitivo, con puntuaciones F1 de 0,81 y una tasa de aprobación del 98 %. El modelo procesa 67 tokens/s de entrada y 36 tokens/s de salida en una GPU T4. Los problemas de degeneración (bucles de tokens, salida repetitiva) se reducen significativamente gracias al entrenamiento con pérdida contrastiva. La ventana de contexto de 512K tokens elimina la necesidad de segmentar la mayoría de los documentos del mundo real.
Buenas prácticas
El modelo está accesible a través de un notebook de Google Colab que demuestra la conversión de HTML a Markdown, la extracción de JSON y el seguimiento de instrucciones. Para tareas de HTML a Markdown, ingrese HTML sin procesar y sin instrucciones de prefijo. Para la extracción de JSON, especifique el esquema objetivo en el prompt. La función auxiliar create_prompt facilita la creación de prompts para ambas tareas. El modelo funciona en la capa gratuita de GPU T4 de Colab (requiere vllm y triton) pero tiene limitaciones sin soporte de bfloat16 o Flash Attention 2; para producción se recomienda RTX 3090/4090. Disponible en AWS SageMaker, Azure y el mercado de GCP. Con licencia CC BY-NC 4.0 para uso no comercial. Use este modelo como paso de preprocesamiento en pipelines de RAG para convertir el contenido web en Markdown limpio antes de crear embeddings con jina-embeddings-v5-text-small.