Embeddings
jina-embeddings-v3
 Elastic Inference Service
 API de Jina
 AWS SageMaker
 Microsoft Azure
 Nube de Google
 Hugging Face
 Air-gapped

Descripción general
jina-embeddings-v3 es un modelo de embeddings de texto multilingüe de 570M parámetros que soporta 89 idiomas y una ventana de contexto de 8.192 tokens. Su innovación definitoria es el uso de adaptadores LoRA específicos de tarea: el mismo backbone de 570M produce embeddings optimizados para recuperación, clasificación, agrupamiento y coincidencia de texto intercambiando pesos de adaptadores ligeros (cada uno con menos de 60M parámetros). Alcanzó un rendimiento MTEB líder al lanzamiento, superando los embeddings propietarios de OpenAI y Cohere en tareas de inglés.
Métodos
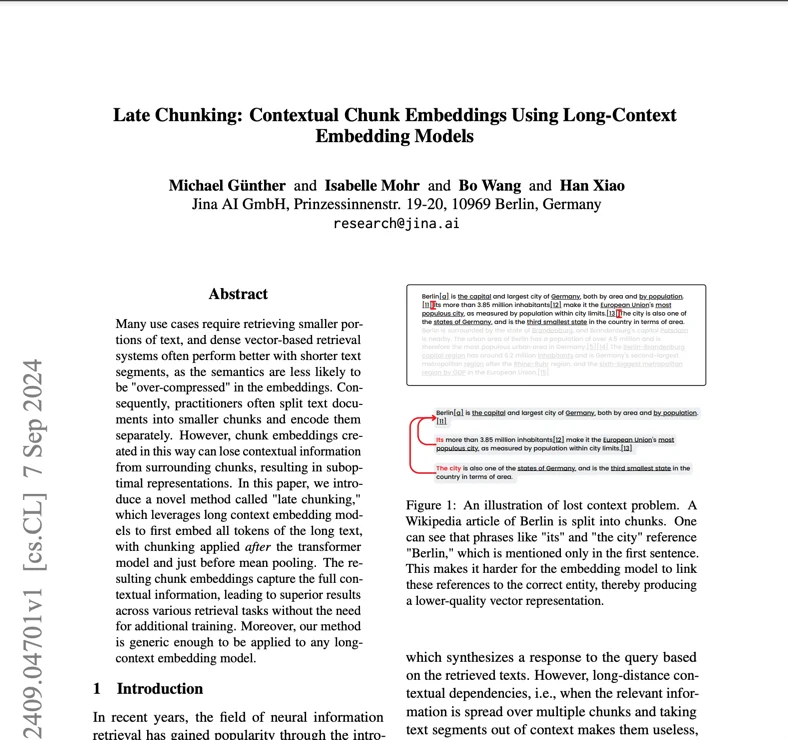
El modelo se basa en un backbone jina-XLM-RoBERTa con 24 capas transformadoras, usando embeddings de posición rotatorios (RoPE) con una frecuencia base ajustada para la extrapulación de contexto largo hasta 8.192 tokens. El entrenamiento siguió un currículum de tres etapas: (1) preentrenamiento multilingüe en 89 idiomas, (2) ajuste contrastivo en conjuntos de datos de texto emparejado para establecer la calidad base de los embeddings, y (3) entrenamiento de adaptadores LoRA específicos de tarea. Cada adaptador LoRA añade menos del 3 % a la cuenta total de parámetros mientras especializa el modelo para una tarea específica: retrieval.query y retrieval.passage para búsqueda asimétrica, separation para agrupamiento, classification para categorización y text-matching para similitud semántica. El Matryoshka Representation Learning (MRL) permite la truncación de embeddings de 1024 a 32 dimensiones preservando más del 90 % de la calidad de recuperación a 64 dimensiones. Se admite el late chunking para documentos que exceden la ventana de contexto.
Rendimiento
En MTEB, jina-embeddings-v3 obtuvo una puntuación media de 65,52 en todas las tareas, con resultados especialmente fuertes en clasificación (82,58) y similitud de oraciones (85,80). Superó a multilingual-e5-large-instruct en todas las tareas multilingües y venció a e5-mistral-7b-instruct (12× la cantidad de parámetros) en tareas de inglés. En MTEB multilingüe, puntuó 64,44, demostrando un rendimiento consistente en 89 idiomas. La truncación MRL preservó el 92 % del rendimiento de recuperación a 64 dimensiones frente a los 1024 completos. En 2026, jina-embeddings-v5-text-small supera a este modelo para la mayoría de las cargas de trabajo, ofreciendo contexto de 32K y entrenamiento basado en destilación que produce mayor precisión por parámetro.
Guía
Seleccione el adaptador LoRA apropiado para su tarea: retrieval.query/retrieval.passage para búsqueda, separation para agrupamiento, classification para categorización, text-matching para similitud semántica. Use el parámetro `late_chunking para documentos que excedan 8.192 tokens. La truncación Matryoshka a 256 o 512 dimensiones es adecuada para indexación con restricciones de almacenamiento; use las 1024 dimensiones completas para re-ranking. El modelo requiere una GPU con soporte CUDA para el rendimiento de producción. Para nuevos proyectos multilingües, prefiera jina-embeddings-v5-text-small` (contexto de 32K, entrenado por destilación, mayor precisión). El modelo no está diseñado para la generación de texto o el razonamiento complejo — produce embeddings, no texto.