Elastic
Jina AI
Modelos
API
keyboard_arrow_down
Reader
Convierta cualquier URL a Markdown para un mejor anclaje de los LLM.
Embeddings
Embeddings multimodales y multilingües.
Reranker
Reranker para maximizar la relevancia de los resultados de búsqueda.
MCP
terminal
CLI
article
llms.txt
smart_toy
Agentes
data_object
Esquema
menu_book
Documentos
Acceso
login
Embeddings
Licencia de investigación de Qwen
open_in_new Publicación de lanzamiento

jina-embeddings-v4

Modelo de integración universal para la recuperación multimodal y multilingüe
Licencia
Qwen Research License
Fecha de lanzamiento
calendar_month
2025-06-24
Entrada
abc
Texto
image
Imagen
picture_as_pdf
PDF
arrow_forward
Producción
more_horiz
Vector
apps
Multi-vectorial
Dimensiones Matryoshka help_outline
128
256
512
1024
2048
Segmentación tardía help_outline
check_circle
Yes
Detalles del modelo
Parámetros: 3.8B
Longitud del token de entrada: 32K
Tamaño de la imagen de entrada: 768×28×28
Dimensión de salida: 2048
Modelo base help_outline
open_in_new
Qwen2.5-VL-3B-Instruct
Idiomas entrenados help_outline
34 idiomas
Idiomas admitidos help_outline
29 idiomas
Cuantizaciones help_outline
GGUF
Modelos relacionados
link
jina-embeddings-v3
link
jina-clip-v2
Tareas admitidas
search Recuperación
compare_arrows Coincidencia de texto
code Código
Disponible a través de
API de Jina
Hugging Face
Air-gapped
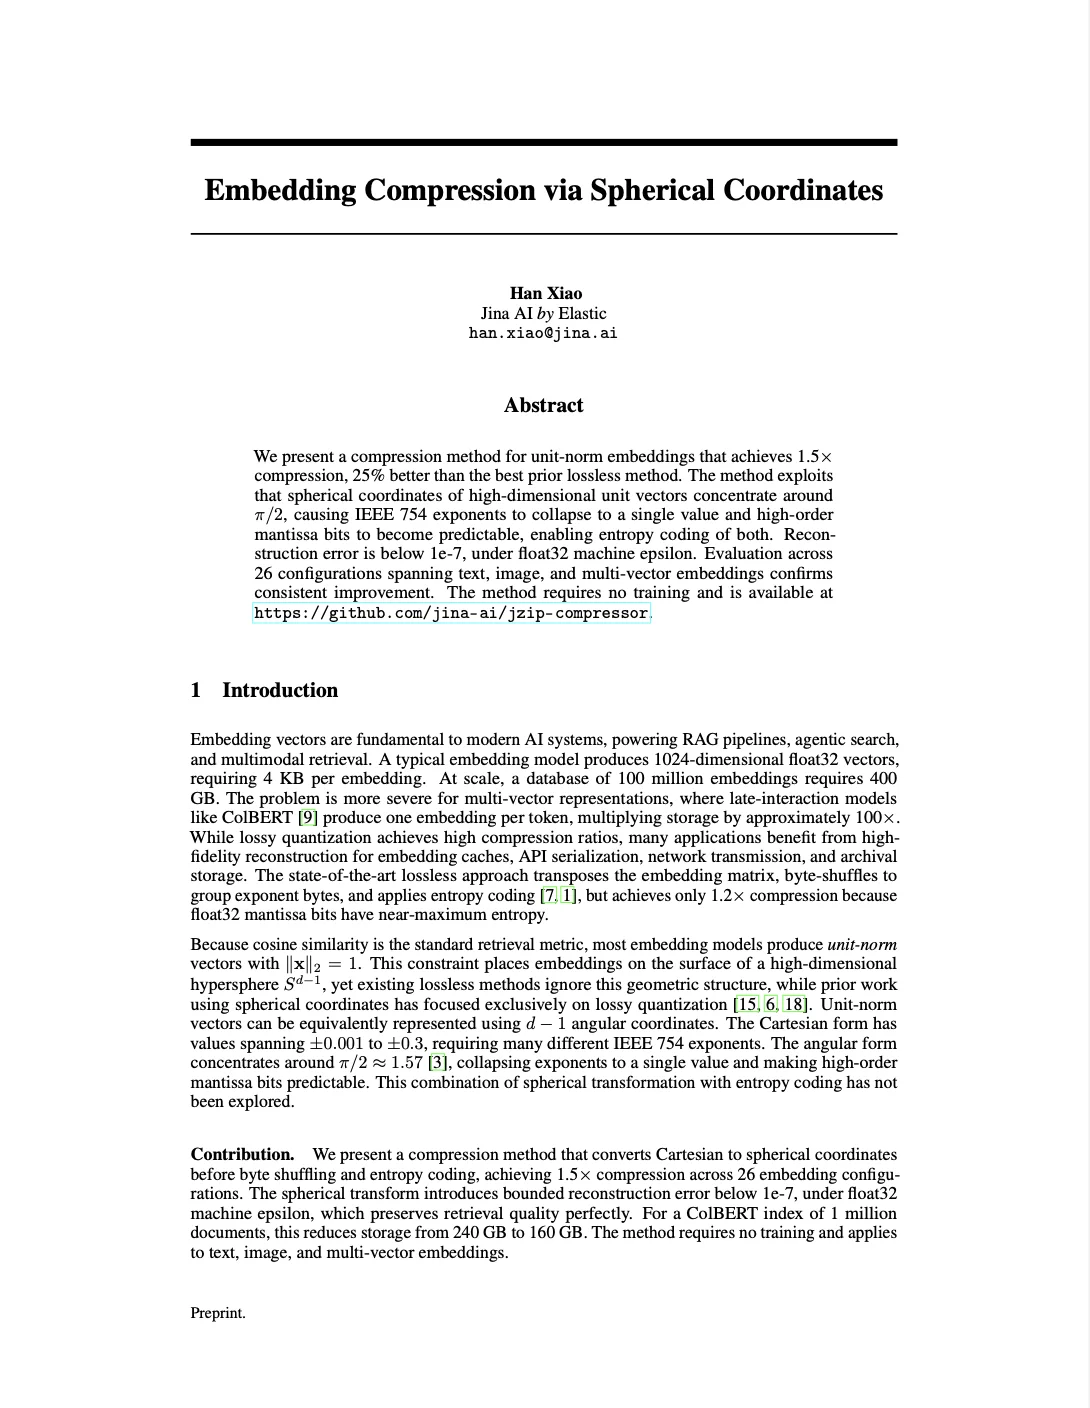
Gráfico de E/S 1

Texto

jina-embeddings-v4

Tarea

Vector

Gráfico de E/S 2

Imagen

jina-embeddings-v4

Tarea

Vector

Gráfico de E/S 3

múltiple

Vector

Texto

jina-embeddings-v4

Tarea

Gráfico de E/S 4

múltiple

Vector

Imagen

jina-embeddings-v4

Tarea

Frontera de Pareto help_outline
workspace_premium
RTEB public
LongEmbed
CoIR
ViDoRe v1
MTEB English · retrieval
chevron_leftchevron_right
30M100M300M1B3.0B10B40506070bge-base-en-v1.5bge-m3bge-small-en-v1.5CodeRankEmbedCodeSage-baseCodeSage-largeCodeSage-large-v2CodeSage-smallCodeXEmbed-7BContrievere5-base-v2e5-mistral-7b-instructe5-small-v2granite-embedding-engli…granite-embedding-small…gte-base-en-v1.5gte-modernbert-basegte-Qwen2-1.5B-instructjina-code-embeddings-0.…jina-embeddings-v3modernbert-embed-baseNV-Embed-v2SFR-Embedding-2_RSFR-Embedding-Code-2B_RSFR-Embedding-Code-400M…snowflake-arctic-embed-…UniXcoderjina-embeddings-v4Parámetros (log)nDCG@10
Este modelo
En la frontera
Jina AI
Otros
CoIR
71.59
Parámetros
3.8B
Rango por score
2 / 31
Frontera de Pareto
Por detrás
Distribución de valoreshelp_outline
AUC 0.8308
Corpus
Pares de traducción
Búsqueda documental
Código
Imagen / banner
Imagen / logotipo
Tarea
code.passage
code.query
code.query → code.passage
retrieval.passage
retrieval.query
retrieval.query → retrieval.passage
text-matching
0.8360.400.500.600.700.800.90
Relacionados6.7%
Negativo difícil1.1%
No relacionados0.8%
Umbrales recomendados
FPR 0.1 · 0.714
FPR 0.01 · 0.836
FPR 0.001 · 0.877
FPR 0.0001 · 0.896
equilibrado · 0.618
AUC
0.8308
Techo de ruido
0.877
Caída de exhaustividad
0.516
Pares medidos
119 / 11k
Componentes del vectorhelp_outline
-0.19-0.020.15
σ 0.0221 · 487k valores
Geometría del embeddinghelp_outline
02048
Media por dimensión, pasa el cursor para ver el rango
Suelo de ruido
0.496
Dim. efectivas
73 / 2048
Truncado de dimensioneshelp_outline
12825651210242048
text-matching · Umbral según las dimensiones solicitadas
Pares de idiomashelp_outline
de-ruen-deen-koen-zhja-ko
Dispersión del umbral entre pares: 0.069
Elija modelos para comparar
Publicaciones (2)
ICLR 2026
enero 22, 2026
Embedding Compression via Spherical Coordinates
EMNLP 2025
junio 24, 2025
jina-embeddings-v4: Universal Embeddings for Multimodal Multilingual Retrieval

Descripción general

jina-embeddings-v4 es un modelo de embedding multimodal de 3,8B parámetros que unifica las representaciones de texto e imagen en una única arquitectura. Apoya de forma única tanto el modo de salida de vector único (denso) como el de múltiples vectores (interacción tardía/estilo ColBERT), permitiendo a los equipos compensar la eficiencia de indexación frente a la precisión de recuperación sin cambiar de modelo. El modelo alcanza un rendimiento state-of-the-art en la recuperación de documentos visualmente ricos, procesando tablas, gráficos, diagramas y formatos de medios mixtos de forma nativa.

Métodos

La arquitectura combina un backbone de encoder transformer grande con un vision encoder basado en Qwen2.5-VL, procesando texto (hasta 32K tokens) e imágenes (768×28×28 patches) a través de capas de atención compartidas. Tres adaptadores LoRA específicos por tarea (60M parámetros cada uno) especializan el modelo en: recuperación asimétrica consulta-documento, similitud semántica de texto y búsqueda de código. El diseño de doble salida es la clave de la innovación: el modelo puede producir un único vector denso de 2048 dimensiones (para indexado ANN rápido con truncamiento Matryoshka a 128 dimensiones) o un conjunto de vectores a nivel de token de 128 dimensiones para puntuación de interacción tardía. El entrenamiento usó un plan de estudios de dos etapas: preentrenamiento contrastivo conjunto en pares texto-imagen y texto-texto, seguido de entrenamiento de adaptadores LoRA específicos por tarea. Se soporta late chunking para documentos que exceden la ventana de contexto de 32K tokens. Se aplica la Qwen Research License.

Rendimiento

En JinaVDR (Visual Document Retrieval), el modelo puntúa un promedio de 72,19, frente a 64,50 para ColPali-v1.2. En ViDoRe, logra un promedio de 84,11 (90,17 en modo multi-vector) frente a 83,90 para ColPali. La recuperación cross-modal alcanza 84,11 en el benchmark CLIP, superando jina-clip-v2 (81,12) y nllb-clip-large-siglip (83,19). Puntuaciones de recuperación de texto: 55,97 en MTEB-en, 66,49 en MMTEB, 67,11 en LongEmbed (frente a 55,66 para jina-embeddings-v3). La similitud semántica alcanza 85,89 en English STS y 72,70 en STS multilingüe. La recuperación de código puntúa 71,59 en CoIR. El alineamiento cross-modal alcanza 0,71 de similitud coseno (frente a 0,15 para OpenAI CLIP). El modo multi-vector supera consistentemente al modo single-vector en tareas visualmente ricas; el modo single-vector ofrece rendimiento eficiente para la recuperación de texto estándar.

Guía

Elija el modo de salida según su pipeline: vector único para indexado ANN a gran escala (truncamiento Matryoshka a 128–512 dimensiones disponible), múltiples vectores para reclasificar los top-k candidatos en documentos visualmente ricos. Seleccione el adaptador LoRA a través del parámetro de tarea de la API: 'retrieval' para búsqueda consulta-documento, 'text-matching' para similitud semántica, 'code' para recuperación de código. Para documentos que exceden 32K tokens, use `late_chunking. El sobrecargo de 60M parámetros por adaptador LoRA es despreciable (<2 % de aumento de memoria) y los tres adaptadores pueden cargarse simultáneamente. El modelo está licenciado bajo Qwen Research License (uso no comercial sin licencia comercial). Para despliegues de producción, use GPUs con soporte CUDA; el modelo está disponible a través de Jina API, AWS, Azure y marketplaces de GCP. Para cargas de trabajo solo de texto, jina-embeddings-v5-text-small` ofrece mejor precisión por parámetro a una fracción del costo computacional.

Blogs que mencionan este modelo
marzo 11, 2026 • 7 minutos de lectura
Generación de embeddings de audio a partir de LLM multimodales
Convierte cualquier LLM multimodal en un pequeño modelo de vectores de audio que supera a CLAP con 25 veces menos datos.
Han Xiao
Abstract illustration of a sound wave or heartbeat, formed by blue, orange, and gray dots on a white background.
febrero 19, 2026 • 7 minutos de lectura
jina-embeddings-v5-text: Nuevos Embeddings Multilingües Pequeños SOTA
Dos modelos de embeddings multilingües de menos de 1B de parámetros con un rendimiento líder en su clase, disponibles en Elastic Inference Service, Llama.cpp y MLX.
Jina AI
Abstract digital artwork in black and white, featuring scattered dots forming letters in a halftone effect. The central lette
septiembre 09, 2025 • 11 minutos de lectura
Vectores multimodales en Llama.cpp y GGUF
Hemos incorporado modelos de vectores multimodales a llama.cpp y GGUF, y hemos descubierto algunos problemas sorprendentes en el camino.
Andrei Ungureanu
Alex C-G
Cartoon llama in the center of a white background, emitting laser-like beams from its eyes. The illustration creates a playfu
septiembre 04, 2025 • 6 minutos de lectura
Jina Code Embeddings: Recuperación de código SOTA a 0.5B y 1.5B
LLM de generación de código → Embeddings de código: los modelos de 0.5B/1.5B alcanzan un rendimiento SOTA en 25 benchmarks de recuperación de código.
Jina AI
Green "Code Embeddings" text displayed in a LED dot style on a black background, evoking a futuristic and technological atmos
agosto 13, 2025 • 15 minutos de lectura
Optimización de GGUF para modelos de Embeddings solo de decodificador
4000 tokens/segundo para un modelo de 向量模型 de 3B parámetros en una GPU L4 es probablemente lo más rápido que conseguirás con llama.cpp. ¿O no?
Han Xiao
Text "DGUF for Embedding Models" written in yellow on a dark background, conveying a sleek, minimalistic, digital design.
Idioma / tema actual
Search Foundation
Reader
Embeddings
Reranker
Obtener la clave API de Jina
Límite de velocidad
Sobre nosotros
Noticias
Descargar el logotipo de Jina
open_in_new
Descargar el logotipo de Elastic
open_in_new
Estado de la API
Elastic © 2026.SeguridadTérminos y condicionesPrivacidadAdministrar cookiesNo venda ni comparta mi información personal.
Este sitio web y su contenido, software, productos y servicios asociados están destinados exclusivamente a un uso profesional. El uso por parte de consumidores no está previsto ni dirigido.