Embeddings
jina-embeddings-v5-text-nano
 GGUF
 MLX
 Elastic Inference Service
 API de Jina
 AWS SageMaker
 Hugging Face
 Air-gapped
Resumen
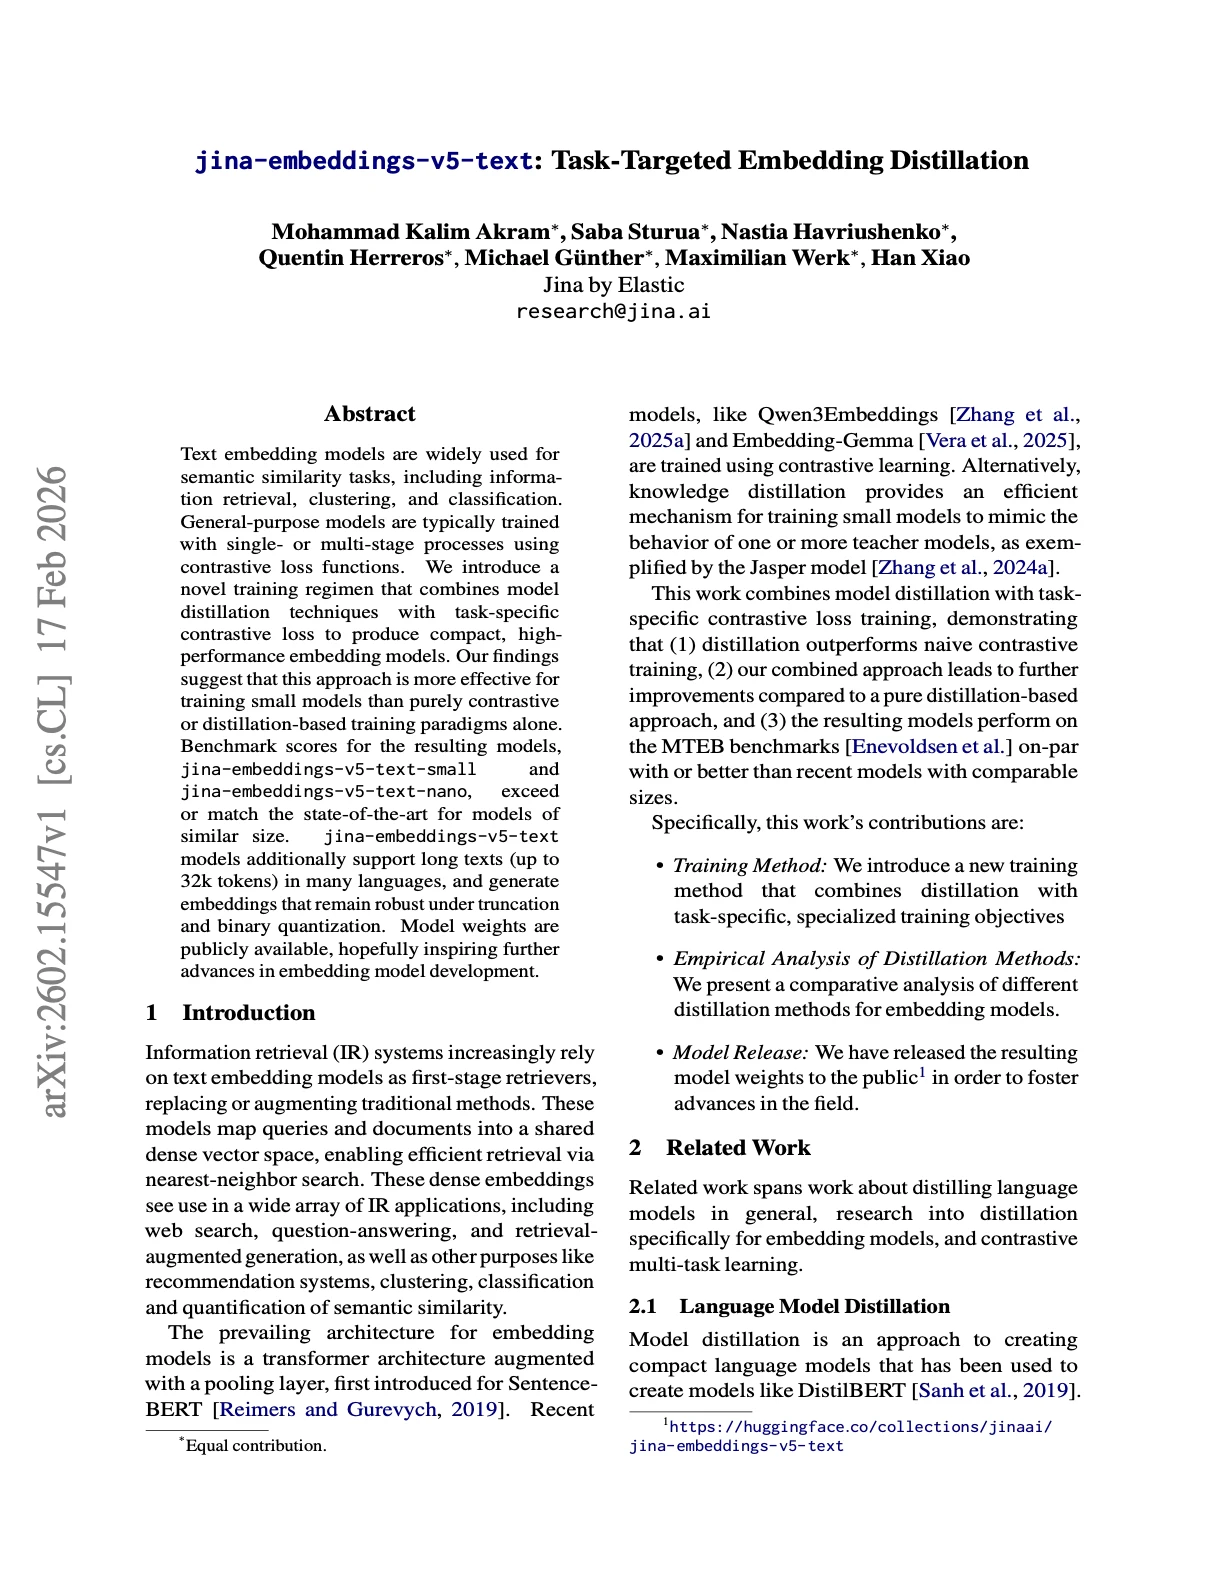
jina-embeddings-v5-text-nano es un modelo de embeddings de texto multilingüe de 239M parámetros construido sobre el backbone EuroBERT-210M. Admite contexto de 8K tokens, produce embeddings de 768 dimensiones con truncación Matryoshka hasta 32 dimensiones y ofrece la mayor precisión por parámetro en la familia de embeddings sub-500M de Jina. Diseñado para despliegues en edge, aplicaciones sensibles a la latencia y entornos con recursos limitados donde no hay una GPU completa disponible.
Métodos
El modelo se construye sobre EuroBERT-210M, un encoder bidireccional compacto preentrenado con datos multilingües que cubren 15 idiomas principales. Emplea Last-Token-Pooling para generar embeddings a partir de la representación del token final. El entrenamiento sigue una receta de destilación de dos etapas: primero, la destilación de conocimiento desde un modelo maestro más grande transfiere calidad de embedding; segundo, una pérdida contrastiva específica de tarea afina el modelo en tareas de recuperación, coincidencia de texto, agrupamiento y clasificación. Matryoshka Representation Learning permite truncar las dimensiones de embedding en cualquier tamaño admitido (32, 64, 128, 256, 512, 768) manteniendo un rendimiento sólido. Geometric Orthogonal Regularization (GOR) limita la degradación de rendimiento bajo cuantización binaria a menos de 2 puntos en MTEB retrieval. La ventana de contexto de 8K permite el procesamiento de documentos largos sin chunking.
Rendimiento
En MMTEB (multilingüe), el modelo logra 65,5 de media (nivel de tarea) y 57,7 de media (nivel de tipo) con apenas 239M parámetros, superando a todos los modelos bajo 500M, incluyendo KaLM-mini-v2.5 (60,1, 494M), voyage-4-nano (58,9, 480M) y Gemma-300M (61,1, 308M). Puntuaciones a nivel de tarea: clasificación 69,2, agrupamiento 52,7, clasificación de pares 81,9, reranking 64,6, recuperación 63,3, STS 78,2. En MTEB en inglés, logra 71,0 de media, casi igualando al mucho mayor jina-embeddings-v5-text-small (71,7). Específico de recuperación: 63,26 en MTEB-M, 64,08 en RTEB, 56,06 en BEIR, 63,65 en LongEmbed. Los embeddings siguen siendo robustos bajo cuantización binaria gracias a la regularización GOR.
Buenas prácticas
Seleccione el prefijo de tarea apropiado: 'retrieval' para búsqueda asimétrica de consulta-documento, 'text-matching' para similitud simétrica, 'clustering' para agrupamiento, 'classification' para categorización. La truncación Matryoshka a 256 dimensiones preserva más del 95 % de la calidad de recuperación y reduce el almacenamiento en un 67 %. Se admite cuantización binaria para reducir aún más el almacenamiento. El backbone EuroBERT ofrece una cobertura sólida para 15 idiomas principales, incluyendo inglés, francés, alemán, español, chino, japonés, árabe e hindi. Use similitud coseno para comparar embeddings. Disponible vía la API de Jina AI, Hugging Face (Sentence Transformers, vLLM) y variantes cuantizadas para llama.cpp. Para cargas que requieren contexto de 32K o mayor precisión, use en su lugar jina-embeddings-v5-text-small.