Embeddings
jina-embeddings-v5-text-small
 GGUF
 MLX
 Elastic Inference Service
 API de Jina
 AWS SageMaker
 Hugging Face
 Air-gapped
Resumen
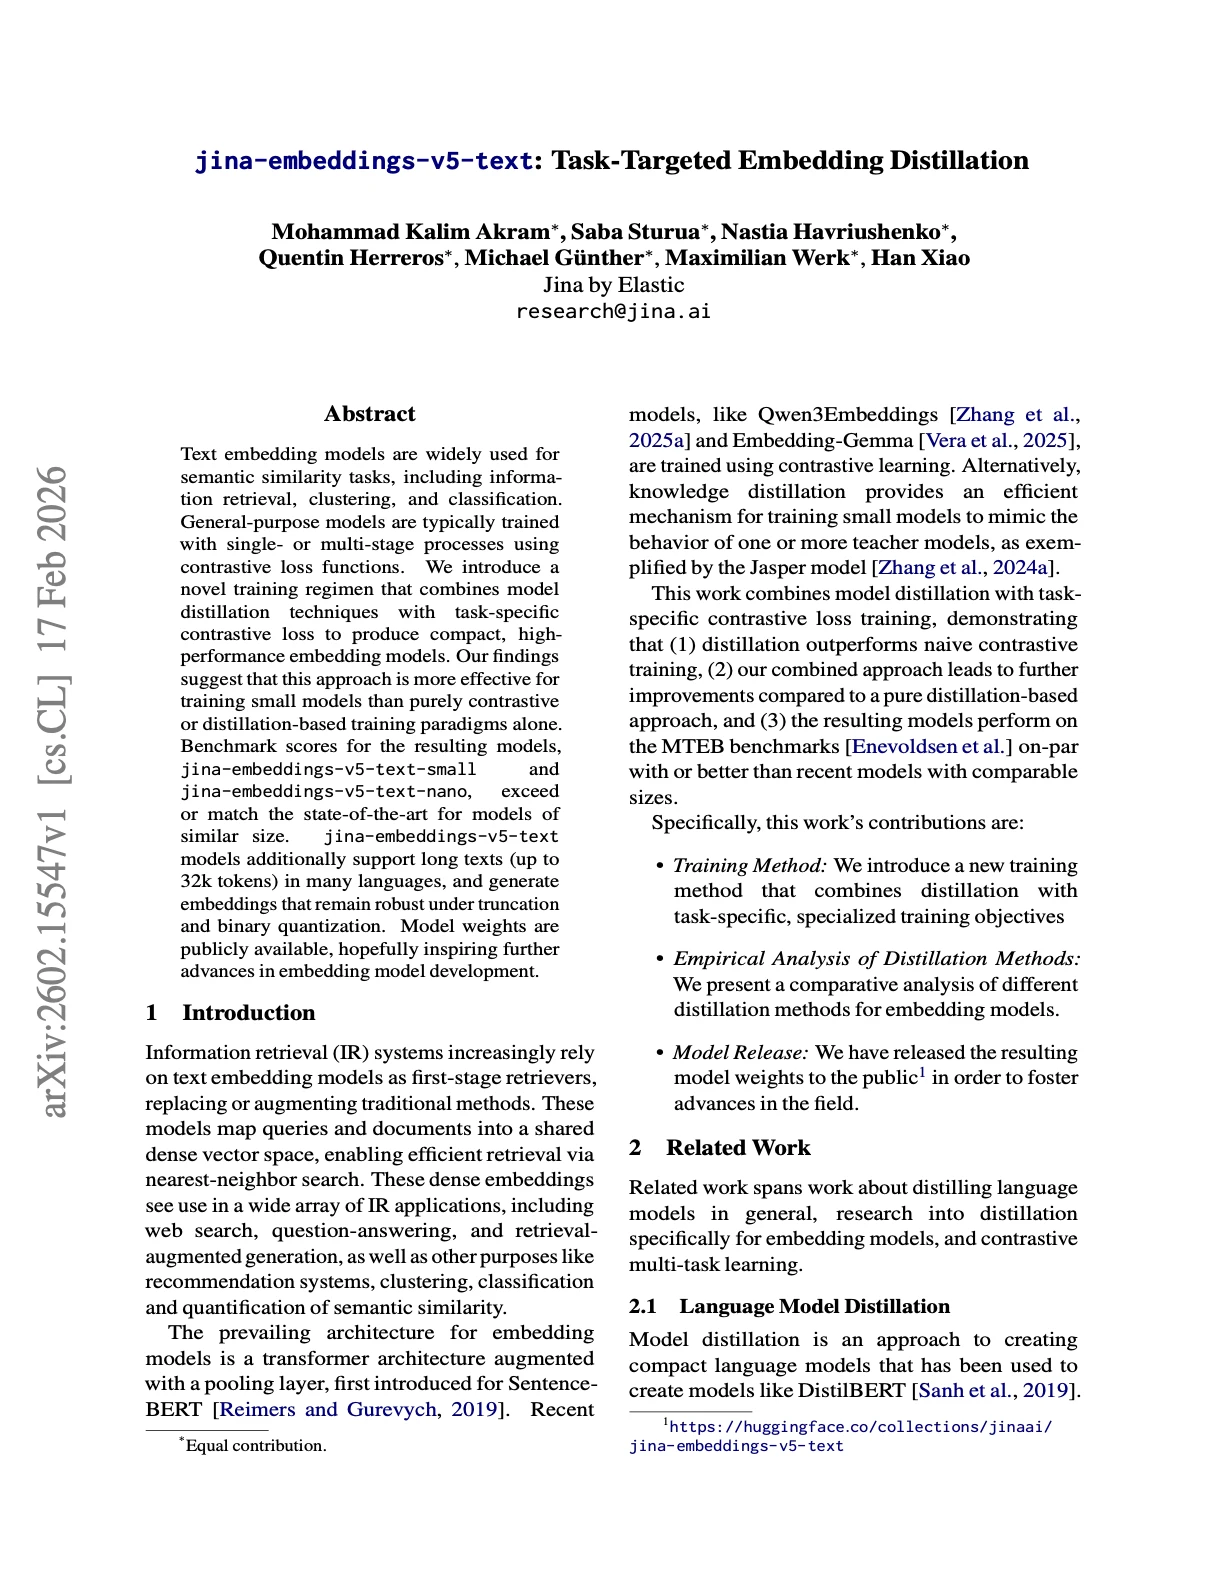
jina-embeddings-v5-text-small es un modelo de embeddings de texto multilingüe de 677M parámetros construido sobre el backbone Qwen3-0,6B-Base. Admite contexto de 32K tokens, produce embeddings de 1024 dimensiones con truncación Matryoshka hasta 32 dimensiones y logra el promedio MTEB más alto entre todos los modelos con menos de 1B parámetros. Es el modelo de embeddings predeterminado de la API de Jina y la recomendación principal para pipelines de RAG de producción.
Métodos
El modelo se construye sobre Qwen3-0,6B-Base, un modelo de lenguaje multilingüe preentrenado en 119 idiomas. Emplea Last-Token-Pooling para generar embeddings. El entrenamiento sigue un régimen de dos etapas: (1) la destilación de embeddings desde Qwen3-Embedding-4B (un maestro de 4B parámetros) transfiere representaciones de embedding de alta calidad al estudiante de 677M; (2) una pérdida contrastiva específica de tarea afina el modelo en tareas de recuperación, coincidencia de texto, agrupamiento y clasificación. Geometric Orthogonal Regularization (GOR) garantiza que los embeddings se mantengan robustos bajo cuantización binaria con pérdida de rendimiento mínima. Matryoshka Representation Learning habilita la truncación de dimensiones de 1024 a 32 preservando una sólida calidad de recuperación por encima de 256 dimensiones. La ventana de contexto de 32K se habilita mediante embeddings de posición rotatorios con frecuencias base ajustadas, y el modelo se entrenó adicionalmente en datos de contexto largo para una recuperación robusta de documentos largos.
Rendimiento
En MMTEB (multilingüe), el modelo logra 67,0 de media (nivel de tarea) y 58,9 de media (nivel de tipo), la más alta entre todos los modelos con menos de 1B parámetros. Puntuaciones a nivel de tarea: clasificación 71,3, agrupamiento 53,4, clasificación de pares 82,9, reranking 65,7, recuperación 64,9, STS 78,9. En MTEB en inglés, logra 71,7 de media, superando a Qwen3-0,6B con instrucciones (70,5) y jina-embeddings-v3 (65,7). Específico de recuperación: 64,88 en MTEB-M, 66,84 en RTEB, 56,67 en BEIR, 66,39 en LongEmbed. Notablemente, el modelo supera a su maestro 4B Qwen3-Embedding-4B en clasificación de pares (42,0 vs. 26,8 en MMTEB) siendo 6× más pequeño, demostrando que la destilación combinada con entrenamiento contrastivo específico de tarea puede superar el rendimiento del maestro en tareas específicas.
Buenas prácticas
Seleccione el adaptador LoRA apropiado: 'retrieval' para búsqueda asimétrica de consulta-documento (añada 'Query:' al inicio de las consultas y 'Document:' al inicio de los pasajes), 'text-matching' para similitud simétrica (use el prefijo 'Document:' para ambas entradas), 'clustering' para agrupar documentos relacionados, 'classification' para categorización y análisis de sentimiento. La truncación Matryoshka a 256–512 dimensiones es adecuada para indexación con restricciones de almacenamiento; use las 1024 dimensiones completas para reranking. Se admite cuantización binaria con una pérdida de rendimiento mínima. La ventana de contexto de 32K maneja documentos largos de forma nativa sin chunking. Use similitud coseno para comparar embeddings. Disponible vía la API de Jina AI, Hugging Face (Sentence Transformers, vLLM) y variantes cuantizadas para llama.cpp. Para cargas multimodales, use en su lugar jina-embeddings-v5-omni-small.