Reranker
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 API de Jina
 AWS SageMaker
 Microsoft Azure
 Nube de Google
 Hugging Face
 Air-gapped
Descripción general
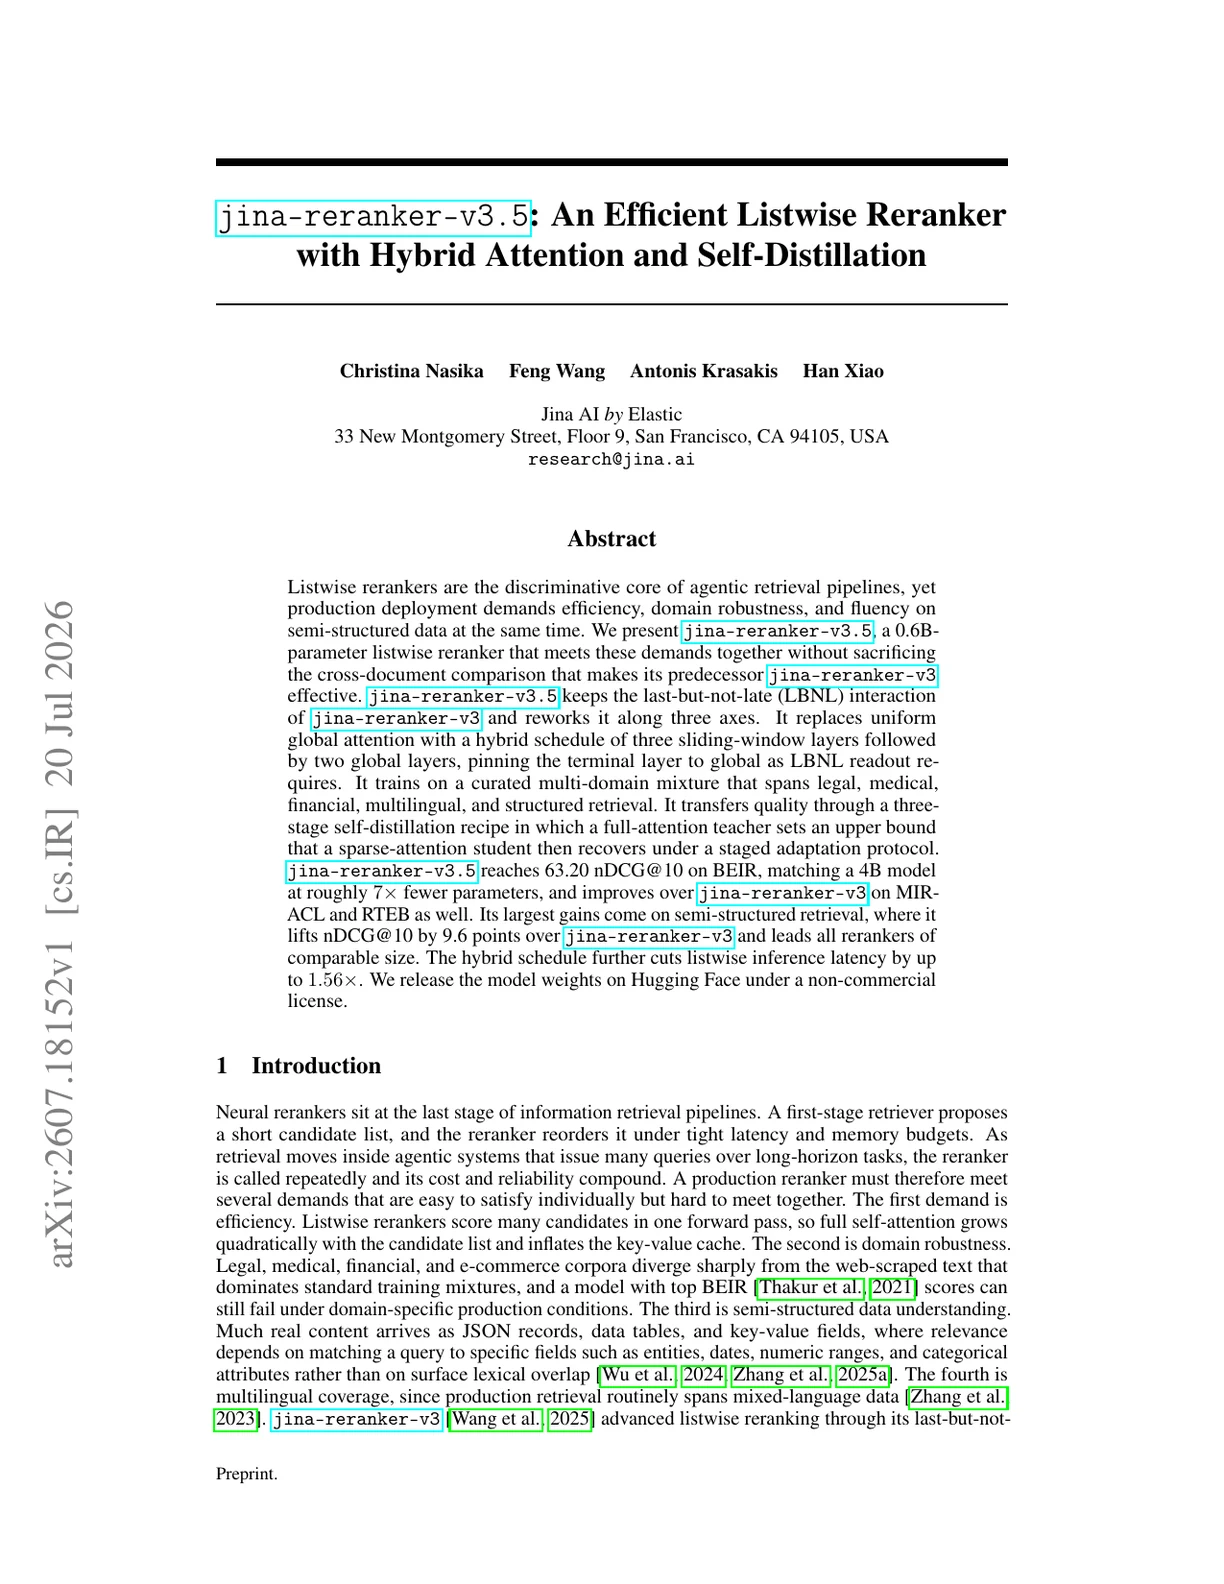
jina-reranker-v3.5 es un reranker listwise de 0,6B parámetros que iguala a modelos de 4B parámetros con aproximadamente 7× menos parámetros. Introduce un calendario de atención híbrida (tres capas de ventana deslizante + dos capas globales) emparejado con una receta de auto-destilación de tres etapas que transfiere la calidad de un maestro de atención completa a un estudiante de atención dispersa. Es un reemplazo directo (drop-in) para jina-reranker-v3, manteniendo el mismo esquema de API mientras mejora la eficiencia y la cobertura de dominio.
Métodos
La arquitectura mantiene el diseño listwise LBNL de jina-reranker-v3: la consulta y todos los documentos candidatos comparten una única ventana de contexto, y los embeddings se leen del token final de cada documento. La innovación clave es el calendario de atención híbrida. En lugar de una atención global uniforme en cada capa, el modelo usa tres capas de atención de ventana deslizante (que restringen la atención de cada posición a una ventana local) seguidas de dos capas de atención global. La capa terminal está fijada a atención global porque el mecanismo de lectura LBNL requiere que el token final atienda al contexto completo. El entrenamiento procede en tres etapas: (1) se entrena un modelo maestro de atención completa sobre una mezcla multidominio curada que abarca legal, médico, financiero, multilingüe y recuperación estructurada; (2) un estudiante de atención dispersa se inicializa desde el maestro y se ajusta con adaptación por etapas, aumentando gradualmente la proporción de pasos de entrenamiento que usan el calendario híbrido; (3) un pase final de destilación donde el estudiante aprende a igualar las distribuciones de clasificación blandas del maestro, recuperando más del 97 % de la calidad de clasificación del maestro mientras ejecuta la ruta de inferencia de atención dispersa, más barata.
Rendimiento
Bajo un protocolo unificado top-100 con jina-embeddings-v5-text-small como recuperador de primera etapa, el modelo logra 63,20 NDCG{'@'}10 en BEIR, 74,11 en MIRACL, 70,95 en RTEB y 48,3 en Struct-IR, mejorando respecto a jina-reranker-v3 (62,10 / 72,20 / 68,01 / 38,7) en cada eje. Su puntuación BEIR supera al Qwen3-Reranker de 4B (62,28) con aproximadamente 7× menos parámetros. Las ganancias relativas respecto a v3 incluyen +1,10 BEIR, +2,6 % MIRACL, +4,3 % RTEB (con grandes mejoras en la recuperación legal) y +24,8 % en el ranking de datos estructurados (Struct-IR). La inferencia listwise corre 1,22×–1,56× más rápido que v3 desde contextos cortos a largos (A100, FlashAttention-2). La mezcla de entrenamiento multidominio produce mejoras particularmente fuertes en datos semiestructurados (tablas, JSON, XML) y corpus de dominio específico.
Guía
jina-reranker-v3.5 es un reemplazo directo para jina-reranker-v3: el esquema de solicitud no cambia, por lo que cambiar el string del modelo no requiere cambios de código. Clasifica una consulta contra la lista completa de candidatos en una sola llamada —pasa los documentos a través del endpoint estándar de rerank y use top_n para limitar los resultados devueltos, o configure return_embeddings para también recuperar embeddings de documentos. El modelo es especialmente fuerte en el ranking de datos estructurados, la recuperación legal u otros dominios específicos, y las colecciones multilingües. Su diseño de atención híbrida mantiene baja la latencia en listas de candidatos largas. La ventana de contexto de 131K tokens soporta documentos muy largos sin segmentación. Disponible bajo CC-BY-NC-4.0 en Hugging Face; para uso comercial, contacta con Jina AI. Para despliegues aislados de red (air-gapped) o en las instalaciones, hay pesos cuantizados disponibles. Combine con jina-embeddings-v5-text-small o jina-embeddings-v4 como recuperador de primera etapa.