Reranker
jina-reranker-v3
 GGUF
 MLX
 Elastic Inference Service
 API de Jina
 AWS SageMaker
 Microsoft Azure
 Nube de Google
 Hugging Face
 Air-gapped
Descripción general
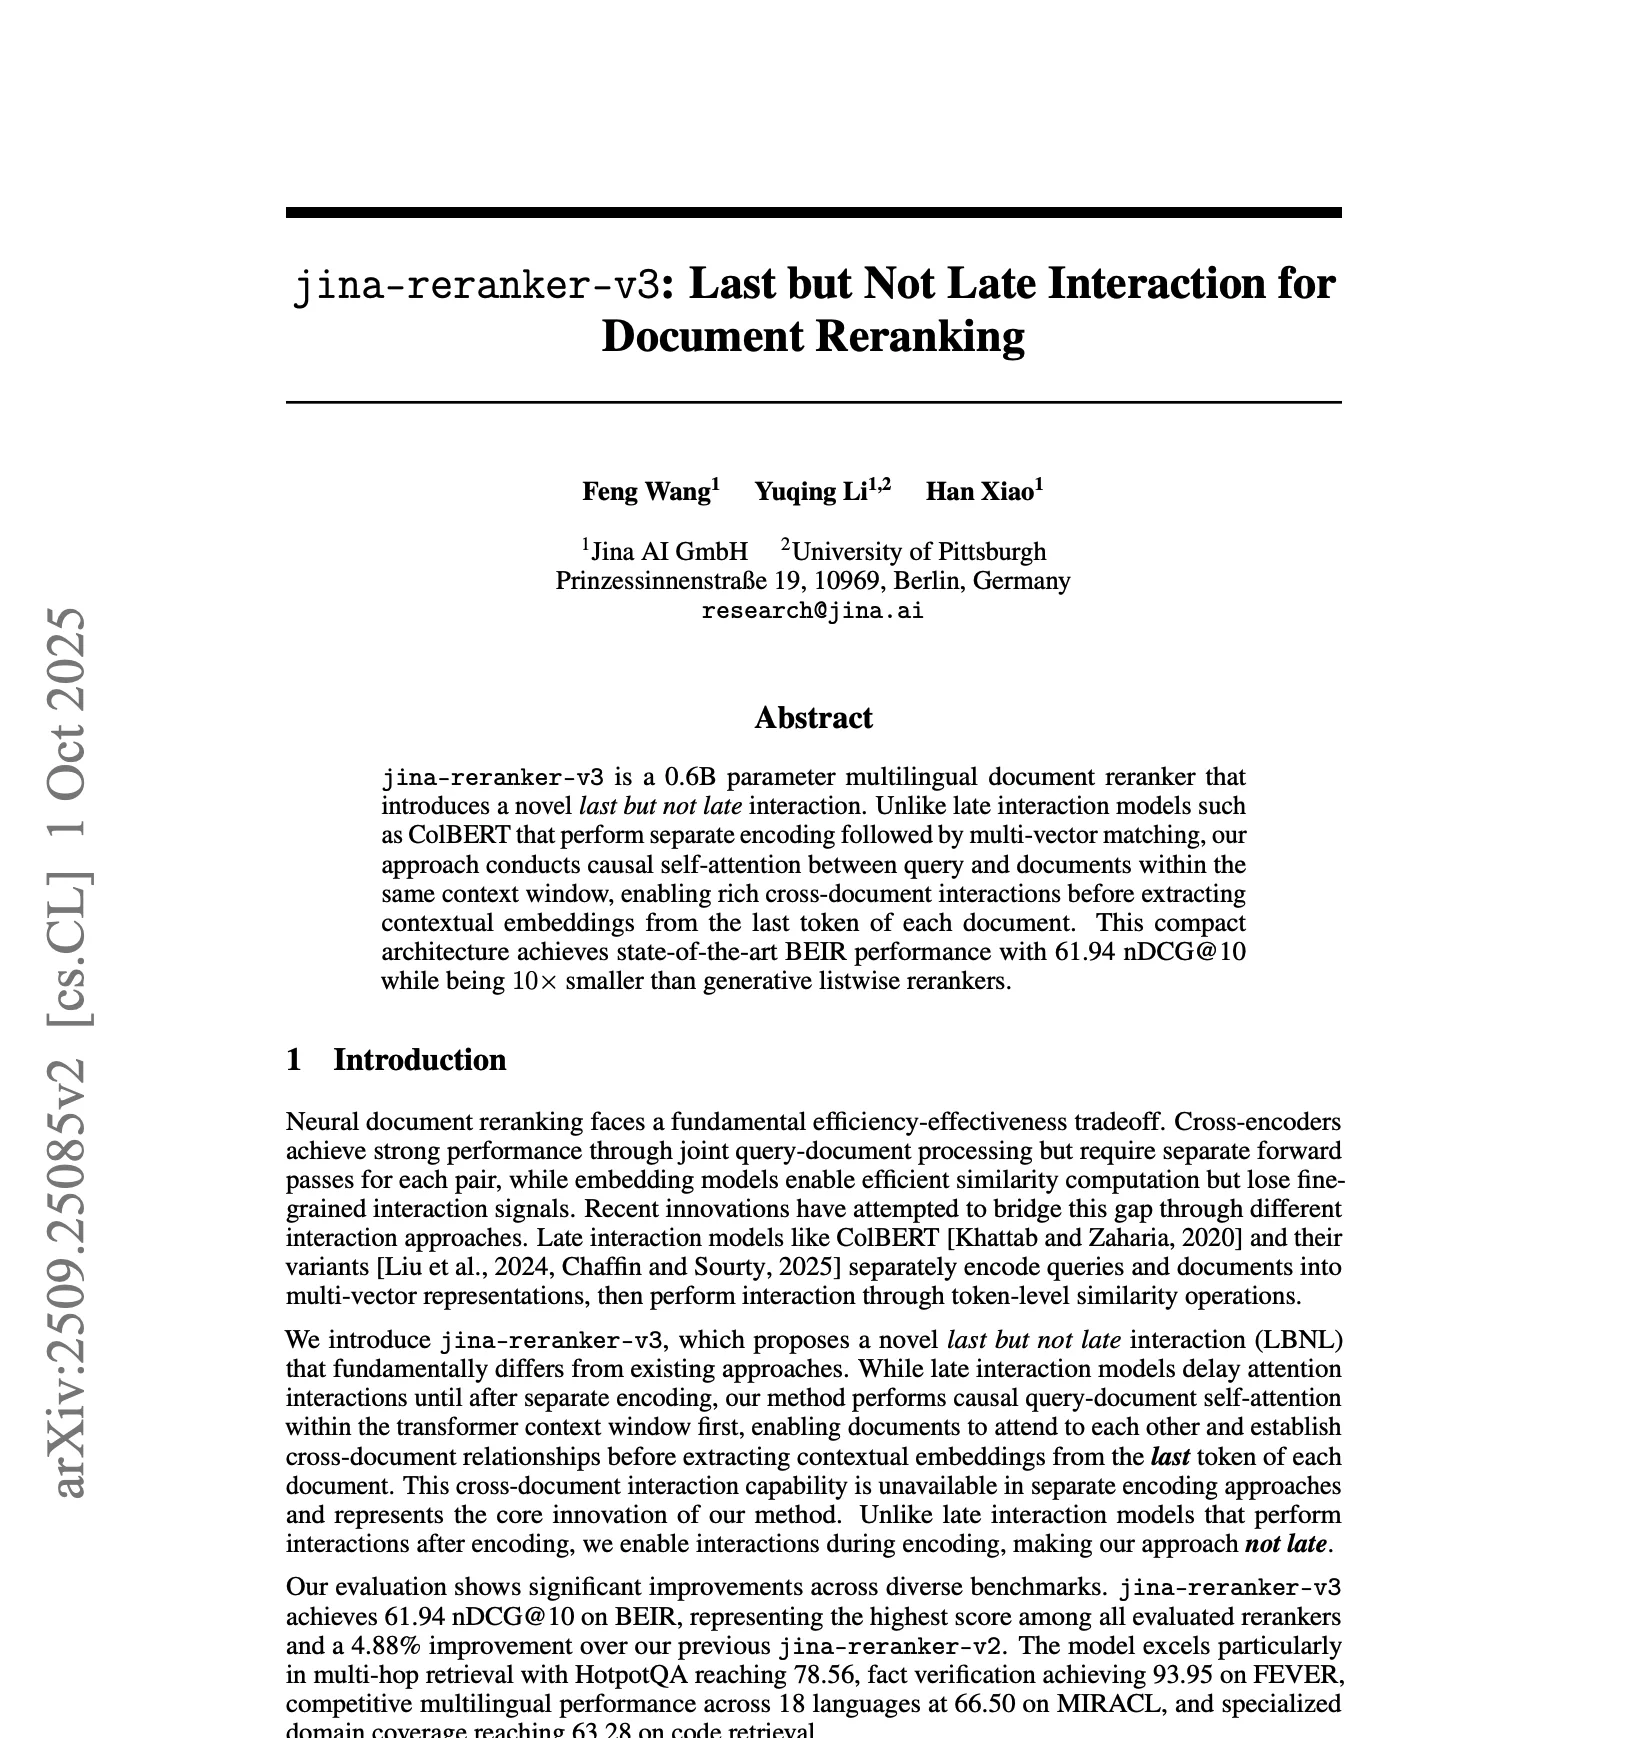
jina-reranker-v3 es un reranker listwise multilingüe de 597M parámetros que introduce la interacción 'last but not late' (LBNL), un cambio de paradigma respecto al scoring de cross-encoder por pares. En lugar de evaluar cada par consulta-documento de forma aislada, procesa simultáneamente una lista completa de documentos candidatos dentro de una única ventana de contexto de 131K tokens, usando atención causal para capturar relaciones entre documentos. Logra un rendimiento BEIR líder (61,94 NDCG{'@'}10) con 2,5× menos parámetros que el competidor más cercano.
Métodos
La innovación central es la arquitectura LBNL. En un cross-encoder estándar, cada par consulta-documento se puntúa de forma independiente. En un modelo de interacción tardía (ColBERT), los documentos se codifican por separado y se comparan token por token. LBNL combina las fortalezas de ambos: la consulta y todos los documentos candidatos comparten una única ventana de atención causal, permitiendo que el modelo preste atención entre documentos y capture señales de relevancia relativa que el scoring por pares pasa por alto. El modelo procesa hasta 16 documentos por pasada hacia adelante (uno positivo y 15 negativos durante el entrenamiento), con cada documento truncado a una longitud fija. Los embeddings se extraen del token final de cada documento mediante Last-Token-Pooling, aprovechando el mecanismo de atención causal para agregar naturalmente información del contexto previo. La ventana de contexto de 131K tokens se habilita mediante embeddings posicionales rotatorios con frecuencias base ajustadas. El entrenamiento usa un currículo progresivo de tres etapas con una pérdida multiobjetivo que combina InfoNCE, pérdida dispersiva (peso 0,45), pérdida de doble correspondencia (peso 0,85) y pérdida de similitud.
Rendimiento
En BEIR, el modelo logra 61,94 NDCG{'@'}10, el más alto entre todos los rerankers evaluados y una mejora del 4,88 % respecto a jina-reranker-v2. Destaca en la recuperación multi-salto (78,56 en HotpotQA) y la verificación de hechos (93,95 en FEVER). El rendimiento multilingüe alcanza 66,50 en MIRACL a lo largo de 18 idiomas, con 78,69 en árabe y 81,06 en tailandés. La recuperación de código alcanza 63,28 en CoIR. Supera al mxbai-rerank-large de 1,5B (61,44) con 2,5× menos parámetros y muestra una mejora del 5,43 % frente a bge-reranker-v2-m3 de la misma escala. El rendimiento es relativamente estable a lo largo de los ordenamientos de documentos: aleatorio (62,54), descendente (61,94), ascendente (61,52), lo que indica un scoring listwise robusto independiente del orden de los candidatos.
Guía
Use la plantilla de prompt estructurada con roles de sistema/usuario/asistente y tokens especiales para la extracción de embeddings. Procese hasta 64 documentos por pasada hacia adelante para colecciones que excedan el contexto de 131K. Es óptimo con documentos ordenados aleatoriamente o por relevancia descendente (la diferencia de rendimiento es <1 %). Aproveche la capacidad de interacción entre documentos para tareas de clasificación comparativa — el diseño listwise del modelo captura relaciones entre candidatos que el scoring por pares pasa por alto. Para aplicaciones multilingües, el modelo ofrece una transferencia zero-shot sólida en 18 idiomas. Implemente procesamiento por lotes para conjuntos grandes de documentos, manteniendo los embeddings de consulta de forma consistente entre lotes. Los embeddings de salida de 256 dimensiones admiten un cálculo de similitud eficiente. Ideal para tareas de razonamiento multi-salto y verificación de hechos. Para producción, use jina-reranker-v3.5 para una inferencia 1,22–1,56× más rápida mediante atención híbrida.