Noticias

Acelere la búsqueda de inteligencia artificial, un token a la vez.

RSS
Presentado
Publicaciones Académicas
arXiv
septiembre 02, 2026
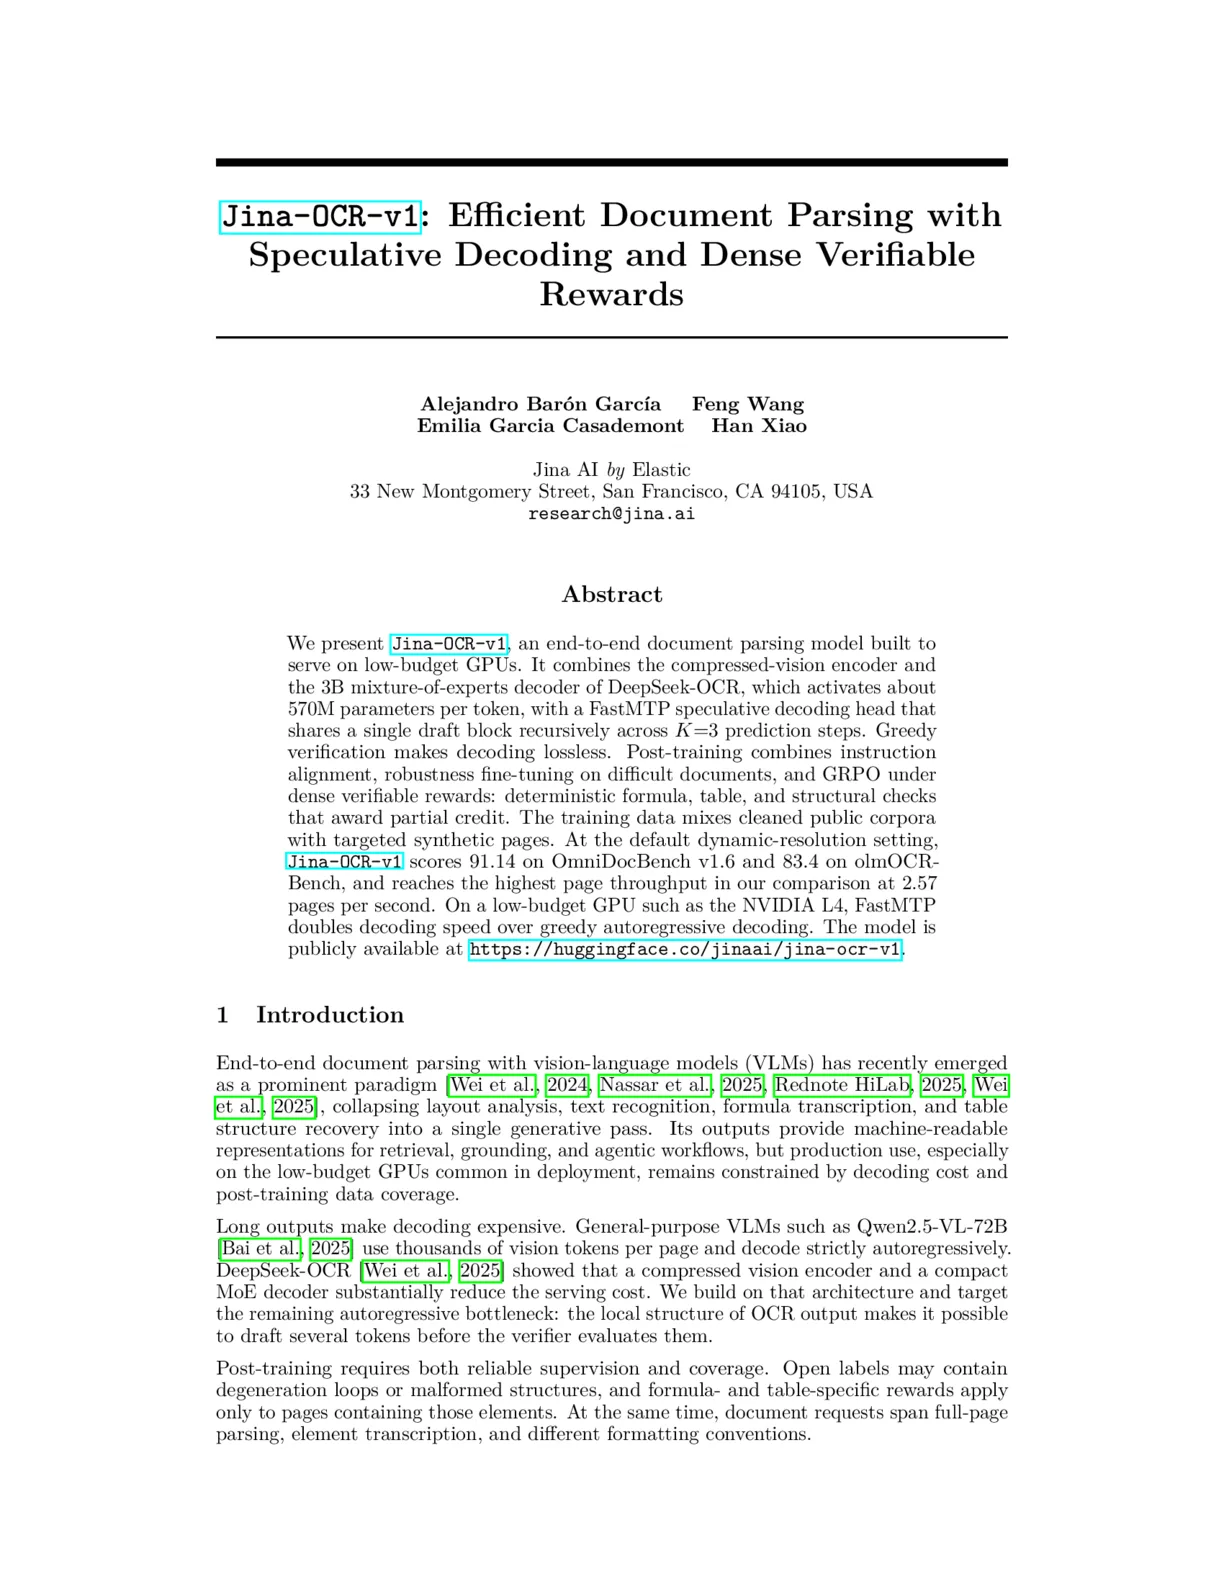
jina-ocr-v1: Efficient Document Parsing with Speculative Decoding and Dense Verifiable Rewards
arXiv
julio 20, 2026
jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation
SIGIR 2026
mayo 11, 2026
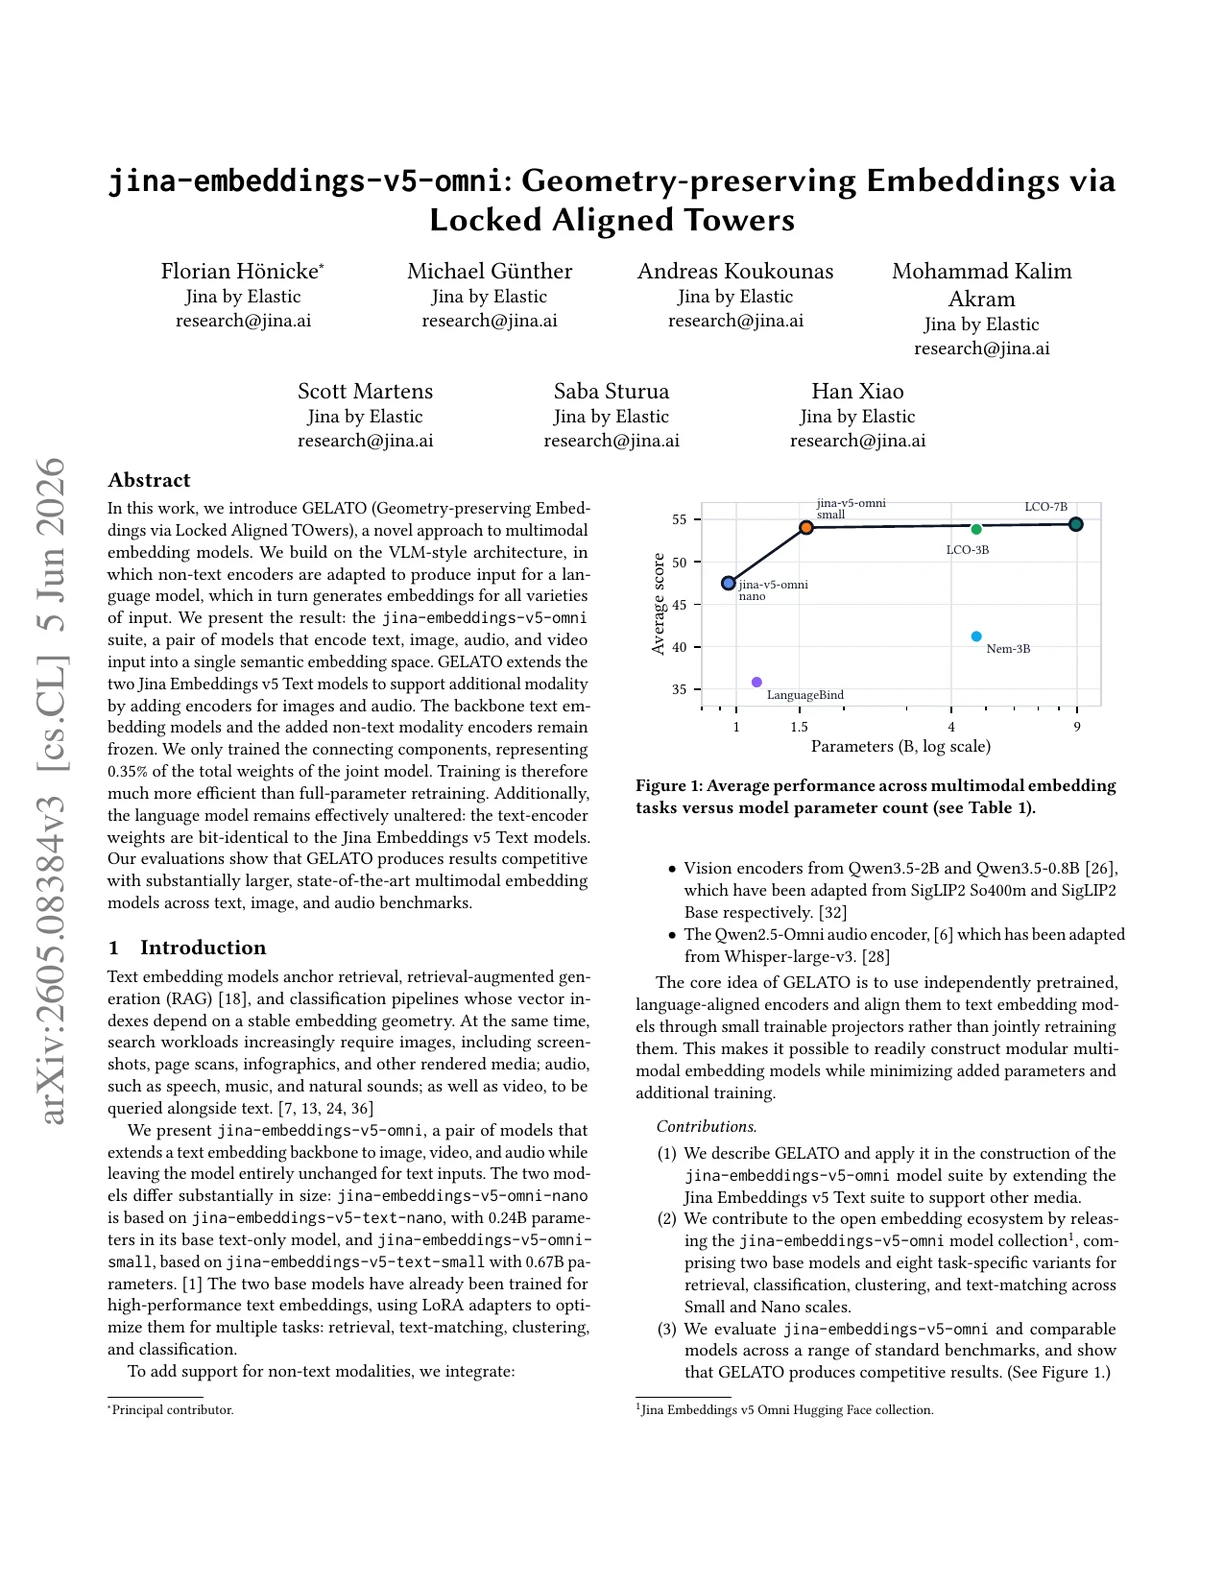
jina-embeddings-v5-omni: Geometry-preserving Embeddings via Locked Aligned Towers
SIGIR 2026
febrero 17, 2026
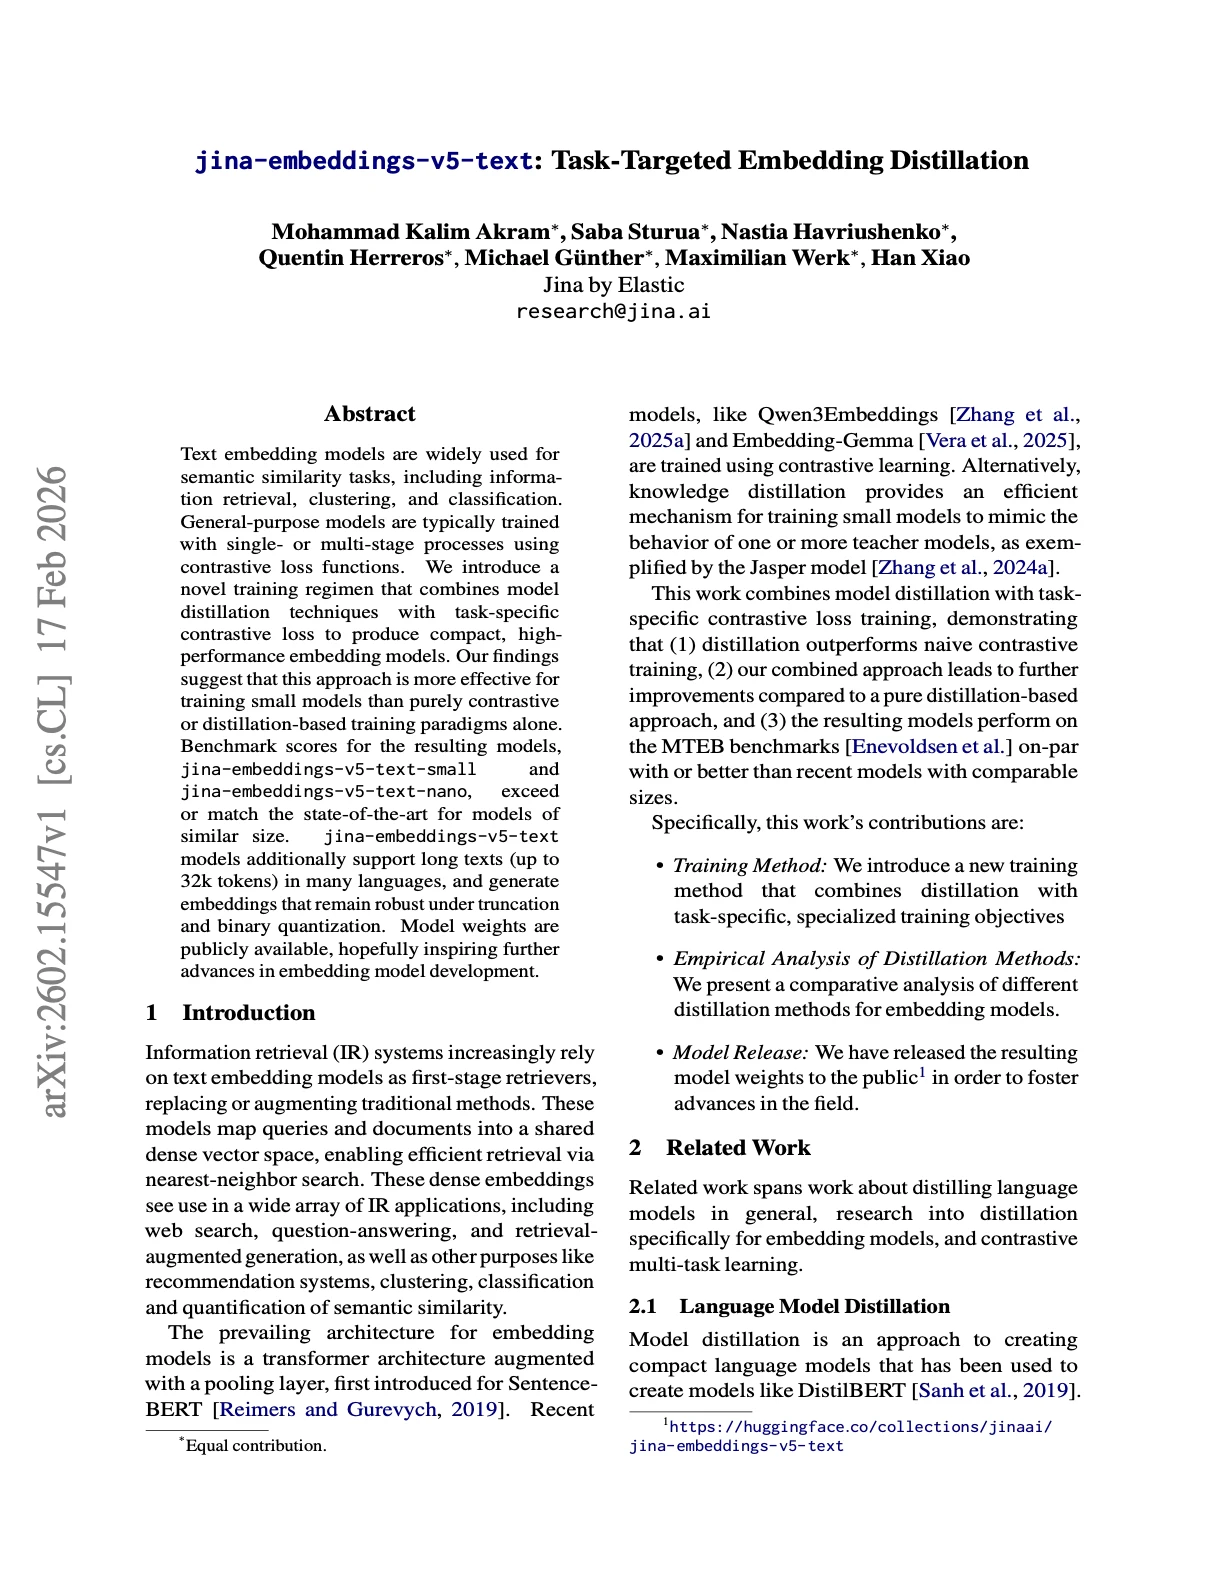
jina-embeddings-v5-text: Task-Targeted Embedding Distillation
ICLR 2026
enero 22, 2026
Embedding Compression via Spherical Coordinates
arXiv
diciembre 29, 2025
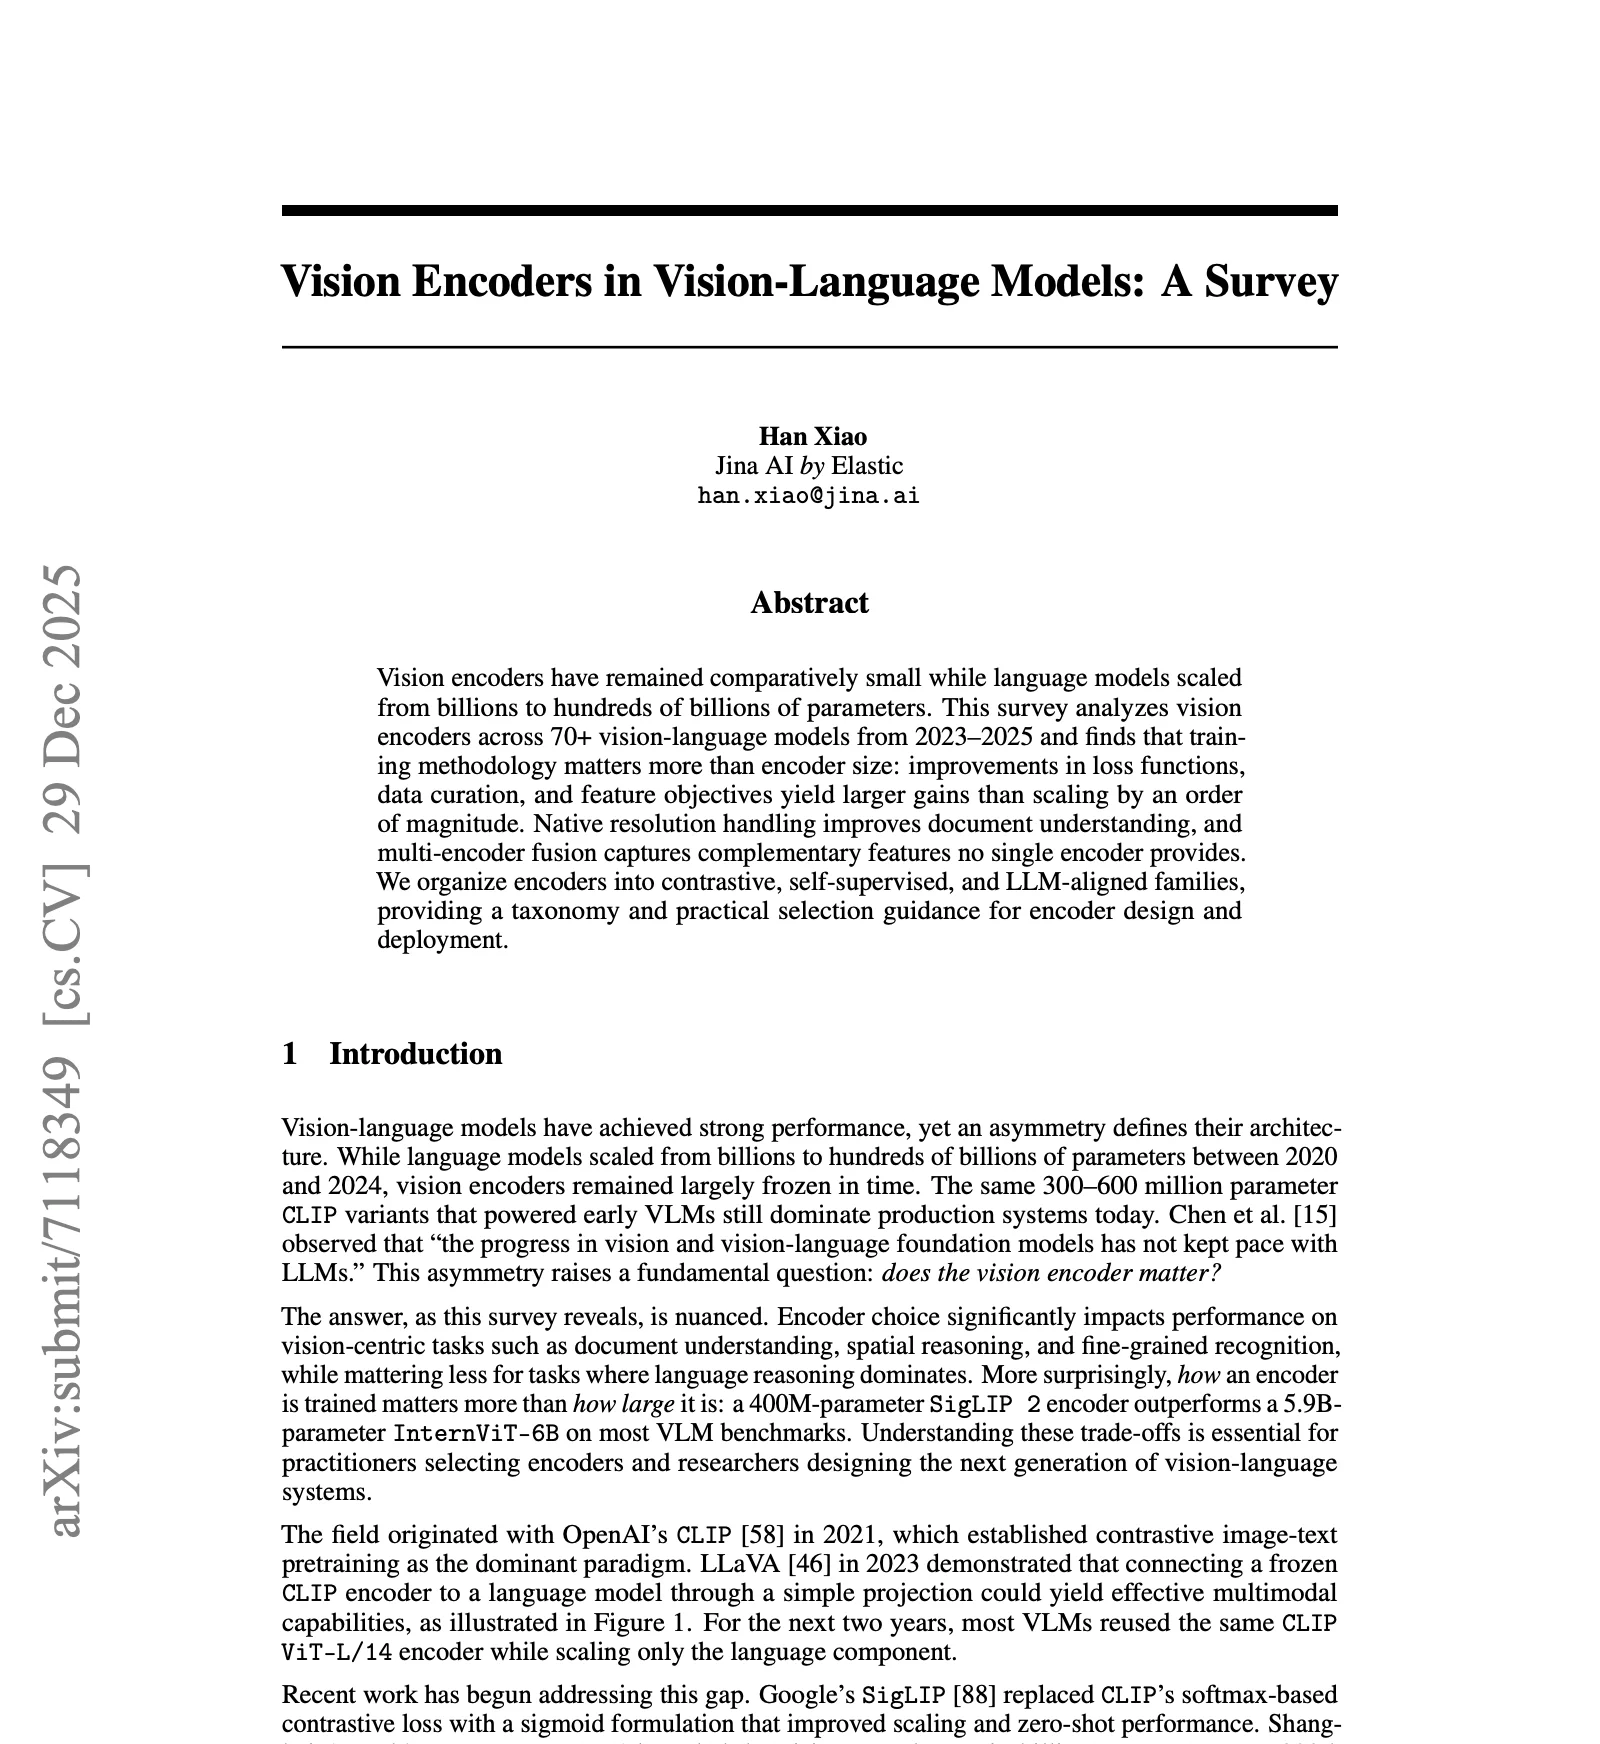
Vision Encoders in Vision-Language Models: A Survey
ICLR 2026
diciembre 04, 2025
Jina-VLM: Small Multilingual Vision Language Model
AAAI 2026
octubre 01, 2025
jina-reranker-v3: Last but Not Late Interaction for Document Reranking
NeurIPS 2025
agosto 31, 2025
Efficient Code Embeddings from Code Generation Models
EMNLP 2025
junio 24, 2025
jina-embeddings-v4: Universal Embeddings for Multimodal Multilingual Retrieval
ICLR 2025
marzo 04, 2025
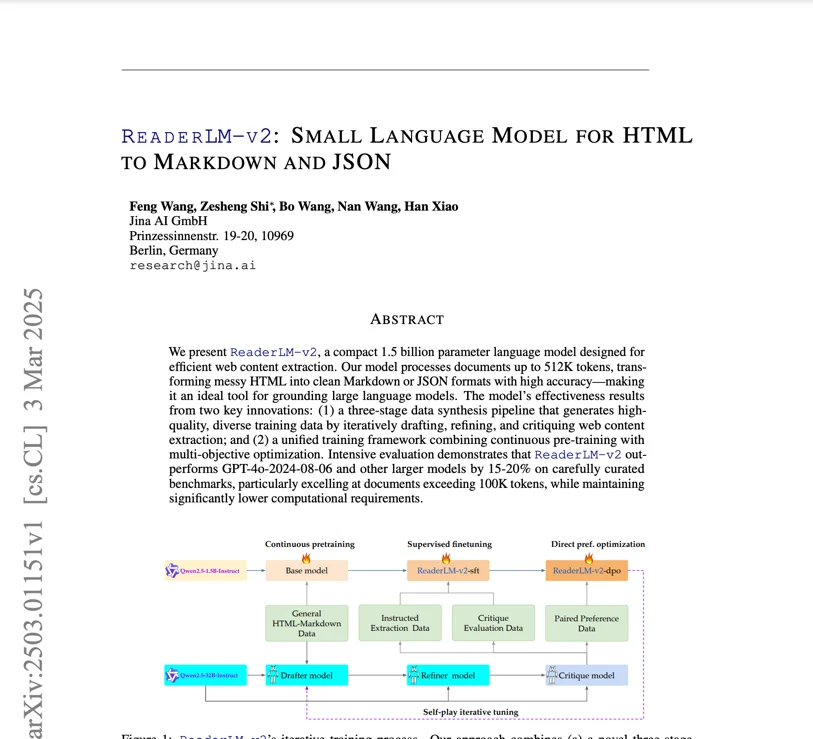
ReaderLM-v2: Small Language Model for HTML to Markdown and JSON
ACL 2025
diciembre 17, 2024
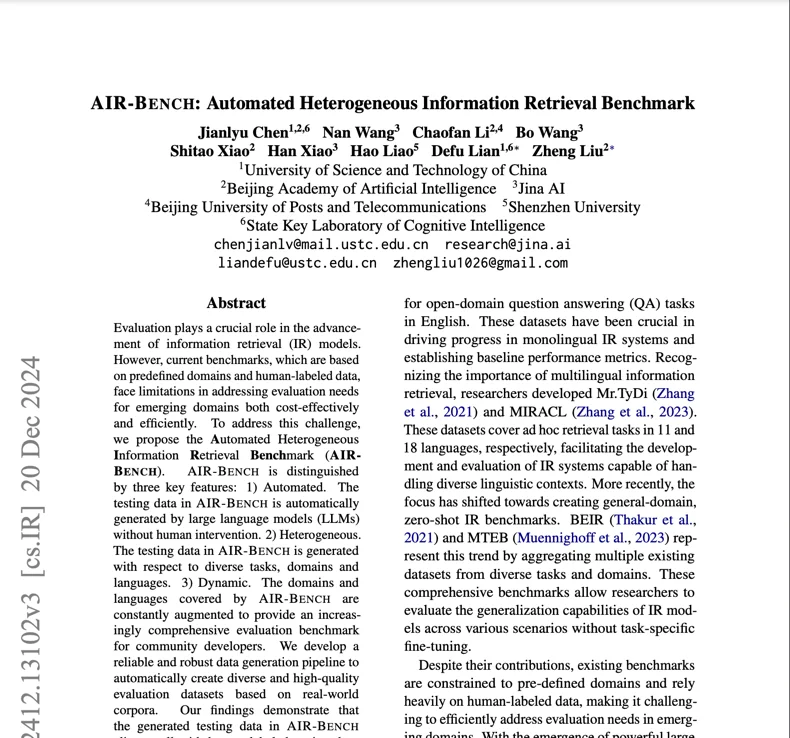
AIR-Bench: Automated Heterogeneous Information Retrieval Benchmark
ICLR 2025
diciembre 12, 2024
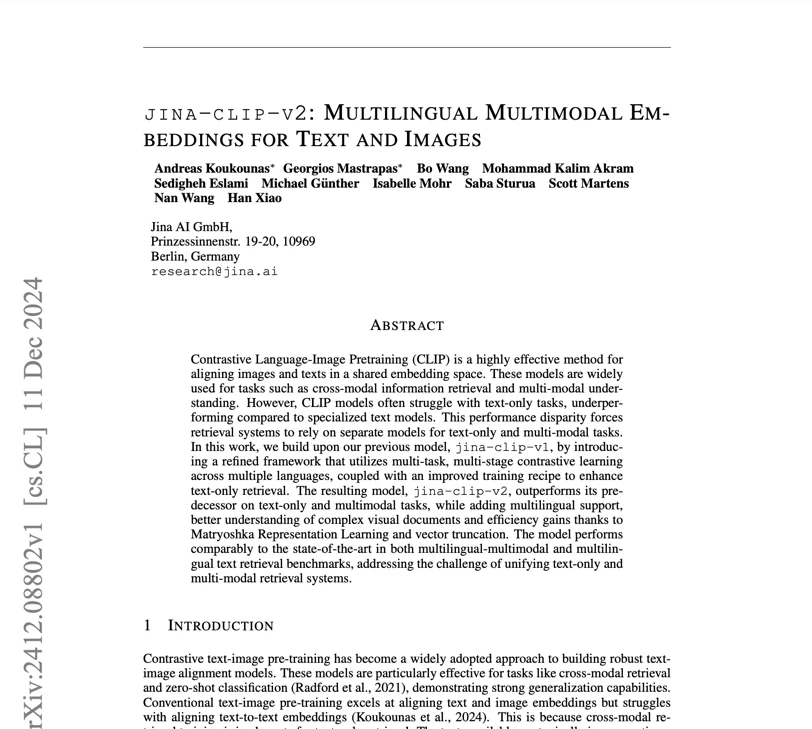
jina-clip-v2: Multilingual Multimodal Embeddings for Text and Images
ECIR 2025
septiembre 18, 2024
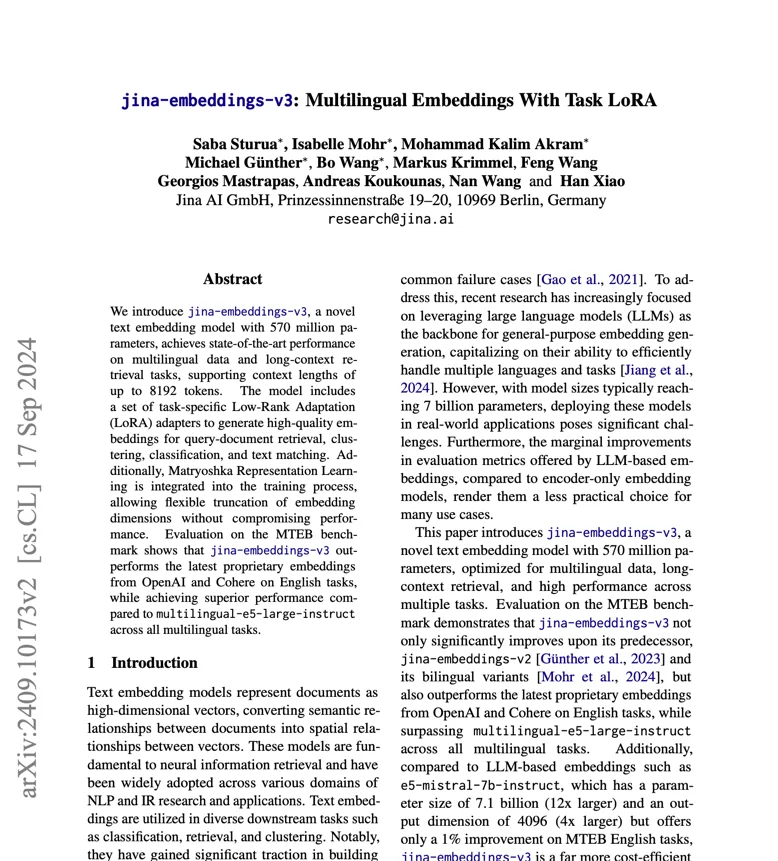
jina-embeddings-v3: Multilingual Embeddings With Task LoRA
SIGIR 2025
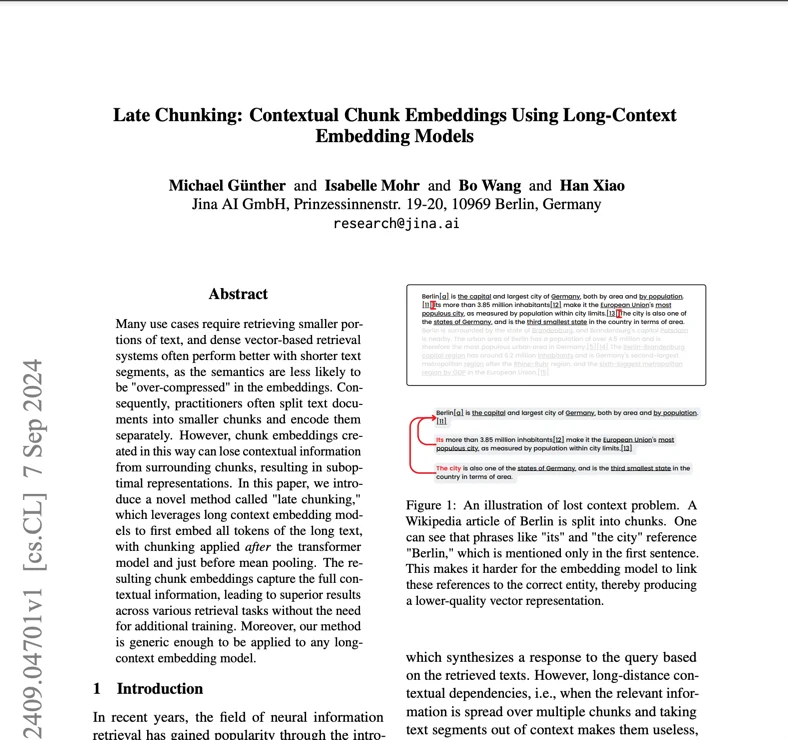
septiembre 07, 2024
Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models
EMNLP 2024
agosto 30, 2024
Jina-ColBERT-v2: A General-Purpose Multilingual Late Interaction Retriever
WWW 2025
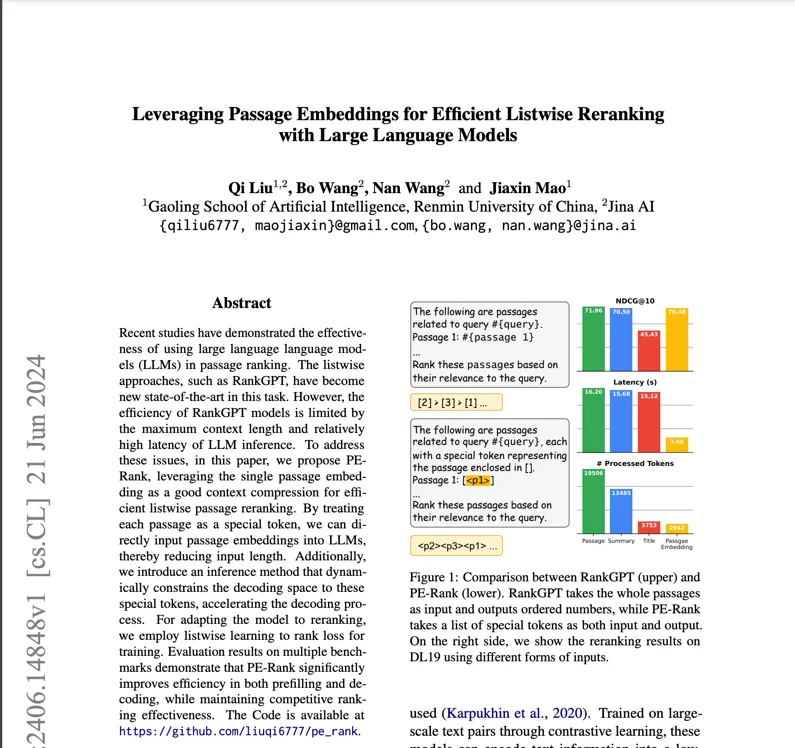
junio 21, 2024
Leveraging Passage Embeddings for Efficient Listwise Reranking with Large Language Models
ICML 2024
mayo 30, 2024
Jina CLIP: Your CLIP Model Is Also Your Text Retriever
arXiv
febrero 26, 2024
Multi-Task Contrastive Learning for 8192-Token Bilingual Text Embeddings
arXiv
octubre 30, 2023
Jina Embeddings 2: 8192-Token General-Purpose Text Embeddings for Long Documents
EMNLP 2023
julio 20, 2023
Jina Embeddings: A Novel Set of High-Performance Sentence Embedding Models
21 publicaciones en total.

septiembre 14, 2026 • 9 minutos de lectura
jina-ocr-v1: Análisis de documentos más rápido en GPU de bajo presupuesto
jina-ocr-v1 es un modelo de lenguaje visual con 3.4 mil millones de parámetros y 570 millones de parámetros activos, que obtiene una puntuación de 91.1 en OmniDocBench v1.6 y 83.4 en olmOCR-Bench.
agosto 03, 2026 • 11 minutos de lectura
jina-reranker-v3.5: Reclasificación listwise más rápida con atención híbrida y auto-destilación
Un Reranker listwise de 0.6B que supera a Qwen3-Reranker-4B en BEIR, realiza el proceso de reranking hasta 1.56 veces más rápido que la v3 y obtiene una mejora de 9.6 en nDCG@10 en recuperación semiestructurada.
mayo 12, 2026 • 7 minutos de lectura
jina-embeddings-v5-omni: Modelos de vectores para texto, imagen, audio y vídeo
Un modelo, cuatro modalidades: texto, imagen, audio y video. Los mejores modelos de Embeddings omni de su clase con 1.6B y 0.9B de parámetros.
marzo 11, 2026 • 7 minutos de lectura
Generación de embeddings de audio a partir de LLM multimodales
Convierte cualquier LLM multimodal en un pequeño modelo de vectores de audio que supera a CLAP con 25 veces menos datos.
marzo 06, 2026 • 6 minutos de lectura
Identificación de modelos de embeddings a partir de valores numéricos brutos
Un transformer diminuto que identifica modelos de embeddings leyendo dígitos numéricos en bruto. Sin ingeniería de características.
febrero 19, 2026 • 7 minutos de lectura
jina-embeddings-v5-text: Nuevos Embeddings Multilingües Pequeños SOTA
Dos modelos de embeddings multilingües de menos de 1B de parámetros con un rendimiento líder en su clase, disponibles en Elastic Inference Service, Llama.cpp y MLX.
diciembre 04, 2025 • 7 minutos de lectura
Jina-VLM: Modelo de Lenguaje de Visión Multilingüe Pequeño
Nuevo modelo de lenguaje de visión de 2B logra SOTA en VQA multilingüe, sin olvido catastrófico en tareas de solo texto.
octubre 03, 2025 • 7 minutos de lectura
Jina Reranker v3: Reranker Listwise de 0.6B para la recuperación multilingüe SOTA
Nuevo reranker listwise de 0.6B parámetros que considera la consulta y todos los documentos candidatos en una sola ventana de contexto.
septiembre 09, 2025 • 11 minutos de lectura
Vectores multimodales en Llama.cpp y GGUF
Hemos incorporado modelos de vectores multimodales a llama.cpp y GGUF, y hemos descubierto algunos problemas sorprendentes en el camino.
septiembre 04, 2025 • 6 minutos de lectura

Jina Code Embeddings: Recuperación de código SOTA a 0.5B y 1.5B
LLM de generación de código → Embeddings de código: los modelos de 0.5B/1.5B alcanzan un rendimiento SOTA en 25 benchmarks de recuperación de código.