Reader
LM-v2
 API Reader
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-gapped
Aperçu
ReaderLM-v2 est un petit modèle de langage de 1,54B paramètres qui transforme du HTML désordonné en Markdown ou en JSON propre avec une grande précision et traite des documents jusqu'à 512K tokens. C'est l'outil idéal pour le grounding des grands modèles de langage : il convertit le contenu web en formats structurés que les LLM peuvent consommer efficacement. Le modèle surpasse Qwen2.5-32B-Instruct et Gemini2-flash-expr sur la conversion HTML vers Markdown, pour une fraction de leur coût.
Méthodes
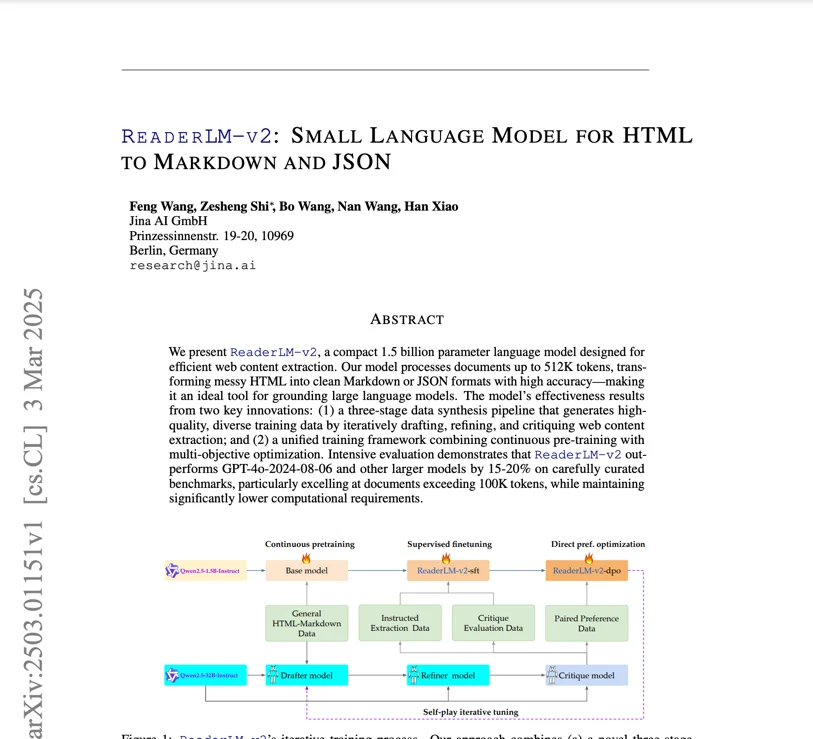
L'efficacité du modèle résulte de deux innovations clés. D'abord, un pipeline de synthèse de données en trois étapes génère des données d'entraînement de haute qualité et diversifiées en ébauchant, affinant et critiquant itérativement l'extraction de contenu web — cette approche par données synthétiques garantit que le modèle voit une grande variété de structures HTML sans annotation manuelle. Ensuite, un cadre d'entraînement unifié combine le pré-entraînement continu avec l'optimisation multi-objectifs, permettant au modèle d'apprendre simultanément la conversion HTML-vers-Markdown et HTML-vers-JSON. L'architecture « shallow-but-wide » à décodage uniquement (28 couches, 1536 dimensions cachées, 12 têtes de requête, 2 têtes KV) est optimisée pour les opérations de copie sélective. Le contexte de 512K tokens est rendu possible par le zigzag-ring-attention. L'entraînement avec perte contrastive réduit significativement les problèmes de dégénérescence.
Performance
Sur les tâches HTML vers Markdown, le modèle atteint un ROUGE-L de 0,84, un score Jaro-Winkler de 0,82 et une distance de Levenshtein de 0,22 — surpassant Qwen2.5-32B-Instruct et Gemini2-flash-expr. Sur les tâches HTML vers JSON, il maintient des performances compétitives avec des scores F1 de 0,81 et un taux de réussite de 98 %. Le modèle traite 67 tokens/s en entrée et 36 tokens/s en sortie sur un GPU T4. Les problèmes de dégénérescence (boucles de tokens, sorties répétitives) sont nettement réduits par l'entraînement avec perte contrastive. La fenêtre de contexte de 512K tokens élimine le besoin de chunking pour la plupart des documents réels.
Conseils
Le modèle est accessible via un notebook Google Colab démontrant la conversion HTML-vers-Markdown, l'extraction JSON et le suivi d'instructions. Pour les tâches HTML-vers-Markdown, saisissez du HTML brut sans préfixes d'instruction. Pour l'extraction JSON, spécifiez le schéma cible dans le prompt. La fonction d'aide create_prompt facilite la création de prompts pour les deux tâches. Le modèle fonctionne sur le palier gratuit GPU T4 de Colab (nécessite vLLM et Triton) mais présente des limites sans prise en charge de bfloat16 ni de Flash Attention 2 ; pour la production, une RTX 3090/4090 est recommandée. Disponible sur AWS SageMaker, Azure et le marketplace GCP. Sous licence CC BY-NC 4.0 pour un usage non commercial. Utilisez ce modèle comme étape de prétraitement dans les pipelines RAG pour convertir le contenu web en Markdown propre avant l'embedding avec jina-embeddings-v5-text-small.