Embeddings
 Licence de recherche Qwen
jina-embeddings-v4
Qwen Research License GGUF
 API Jina
 Hugging Face
 Air-gapped
Aperçu
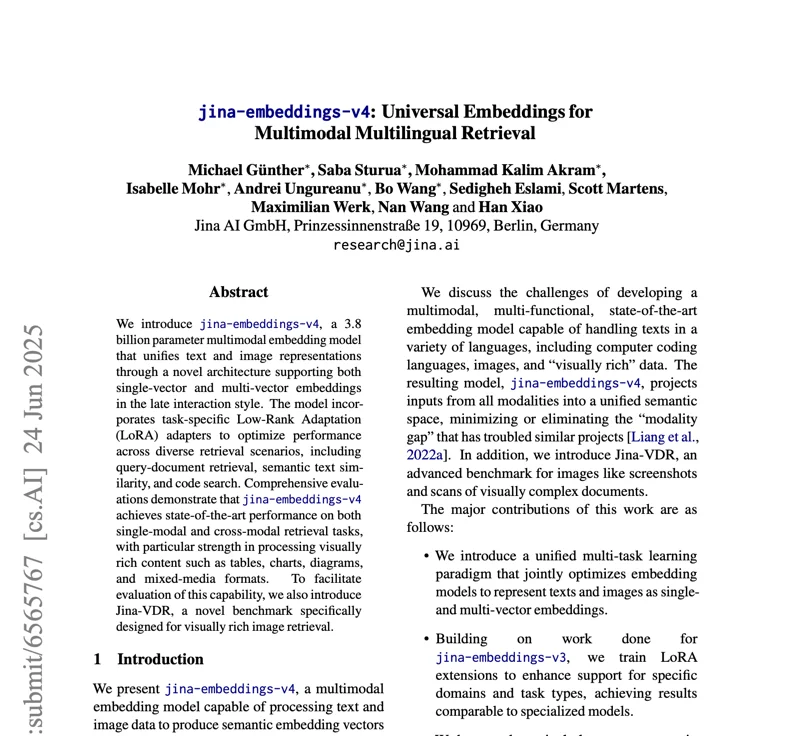
jina-embeddings-v4 est un modèle d'embedding multimodal de 3,8B paramètres qui unifie les représentations texte et image dans une architecture unique. Il prend en charge de manière unique à la fois le mode de sortie mono-vector (dense) et le mode multi-vecteurs (late-interaction/au style ColBERT), permettant aux équipes d'arbitrer entre l'efficacité d'indexation et la précision de récupération sans changer de modèle. Le modèle atteint des performances state-of-the-art sur la récupération de documents visuellement riches, traitant nativement tableaux, graphiques, diagrammes et formats multimédias.
Méthodes
L'architecture combine un grand backbone d'encodeur transformer avec un vision encoder basé sur Qwen2.5-VL, traitant le texte (jusqu'à 32K tokens) et les images (768×28×28 patches) à travers des couches d'attention partagées. Trois adaptateurs LoRA spécifiques à chaque tâche (60M paramètres chacun) spécialisent le modèle pour : la récupération asymétrique requête-document, la similarité sémantique de texte et la recherche de code. La conception de double sortie est l'innovation clé : le modèle peut produire un unique vecteur dense de 2048 dimensions (pour un indexage ANN rapide avec troncature Matryoshka à 128 dimensions) ou un ensemble de vecteurs de 128 dimensions au niveau des tokens pour le scoring late-interaction. L'entraînement a utilisé un cursus en deux étapes : pré-entraînement contrastif conjoint sur des paires texte-image et texte-texte, suivi d'un entraînement des adaptateurs LoRA spécifiques à chaque tâche. Le late chunking est pris en charge pour les documents dépassant la fenêtre de contexte de 32K tokens. La Qwen Research License s'applique.
Performance
Sur JinaVDR (Visual Document Retrieval), le modèle marque 72,19 en moyenne, contre 64,50 pour ColPali-v1.2. Sur ViDoRe, il atteint 84,11 en moyenne (90,17 en mode multi-vector) contre 83,90 pour ColPali. La récupération cross-modal atteint 84,11 sur le benchmark CLIP, dépassant jina-clip-v2 (81,12) et nllb-clip-large-siglip (83,19). Scores de récupération de texte : 55,97 sur MTEB-en, 66,49 sur MMTEB, 67,11 sur LongEmbed (contre 55,66 pour jina-embeddings-v3). La similarité sémantique atteint 85,89 sur STS anglais et 72,70 sur STS multilingue. La récupération de code obtient 71,59 sur CoIR. L'alignement cross-modal atteint une similarité cosinus de 0,71 (contre 0,15 pour OpenAI CLIP). Le mode multi-vector surpasse de façon constante le mode single-vector sur les tâches visuellement riches ; le mode single-vector offre des performances efficaces pour la récupération de texte standard.
Conseils
Choisissez le mode de sortie selon votre pipeline : mono-vector pour l'indexage ANN à grande échelle (troncature Matryoshka à 128–512 dimensions disponible), multi-vector pour le re-classement des candidats top-k sur des documents visuellement riches. Sélectionnez l'adaptateur LoRA via le paramètre de tâche de l'API : 'retrieval' pour la recherche requête-document, 'text-matching' pour la similarité sémantique, 'code' pour la récupération de code. Pour les documents dépassant 32K tokens, utilisez `late_chunking. Le surcoût de 60M paramètres par adaptateur LoRA est négligeable (<2 % d'augmentation mémoire) et les trois adaptateurs peuvent être chargés simultanément. Le modèle est sous licence Qwen Research License (usage non commercial sans licence commerciale). Pour les déploiements de production, utilisez des GPU compatibles CUDA ; le modèle est disponible via Jina API, AWS, Azure et marketplaces GCP. Pour les charges de travail uniquement textuelles, jina-embeddings-v5-text-small` offre une meilleure précision par paramètre à une fraction du coût de calcul.