Embeddings
jina-embeddings-v5-omni-nano
 GGUF
 MLX
 Elastic Inference Service
 API Jina
 AWS SageMaker
 Hugging Face
 MacOS
 Air-gapped
Aperçu
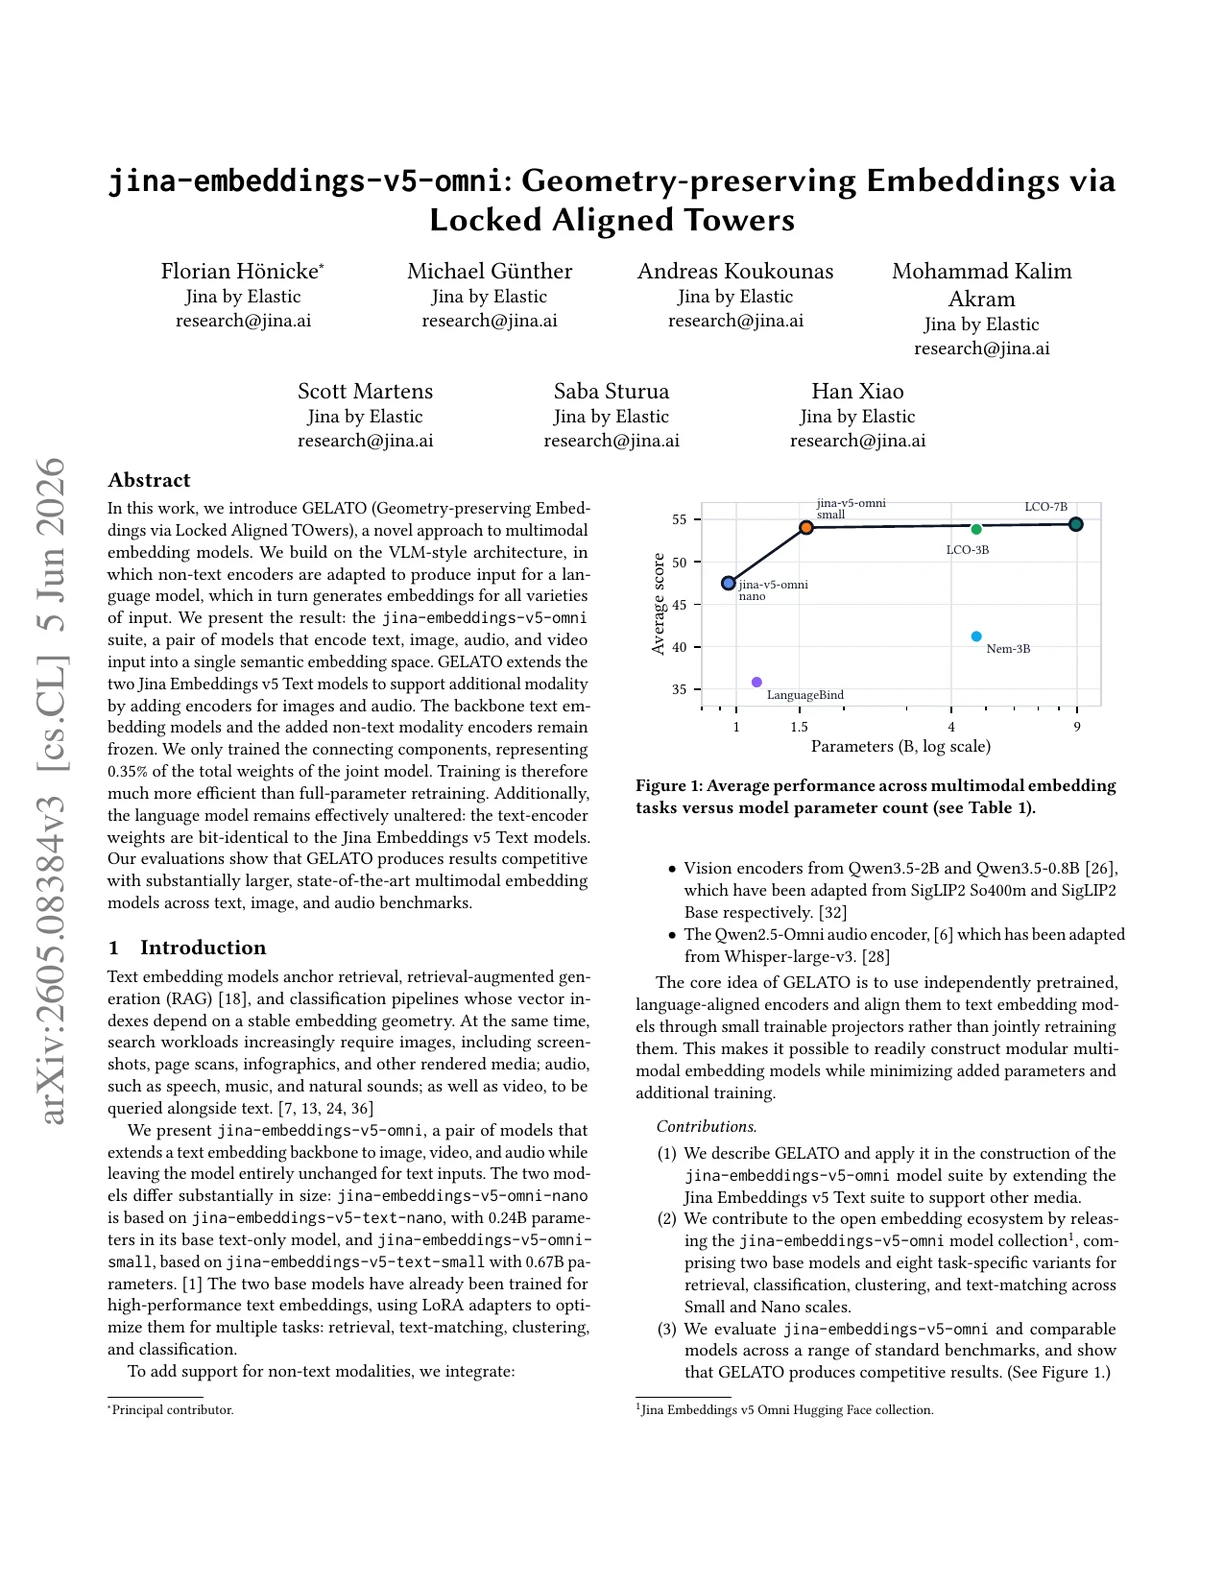
jina-embeddings-v5-omni-nano est un modèle d'embeddings multimodal d'environ 1,04B de paramètres qui accepte du texte, des images, de la vidéo et de l'audio, produisant des embeddings dans un espace vectoriel partagé. C'est la variante compacte de la famille v5-omni, conçue pour le matériel edge et grand public où un GPU n'est pas disponible. Les sorties texte seul sont bit-identiques à jina-embeddings-v5-text-nano, ce qui en fait une mise à niveau drop-in du texte seul vers le multimodal, sans re-indexation.
Méthodes
Le modèle étend jina-embeddings-v5-text-nano de capacités multimodales via une troisième étape d'entraînement. Le backbone texte EuroBERT-210M et les quatre adaptateurs LoRA spécifiques aux tâches sont figés ; seuls les projecteurs cross-modal sont nouvellement entraînés. Un vision encoder SigLIP2 Base traite les images et la vidéo (32 frames échantillonnés uniformément par vidéo). Un audio encoder Whisper-large-v3 traite l'entrée audio. Les pages PDF sont rendues en images et traitées via le chemin visuel. L'entraînement utilise une perte contrastive avec des négatifs durs cross-modal pour aligner les représentations visuelles et audio sur l'espace d'embedding de texte existant. L'espace de sortie de 768 dimensions prend en charge la troncature Matryoshka jusqu'à 32 dimensions. La fenêtre de contexte de 8K tokens couvre l'entrée texte ; les entrées image et audio sont traitées via leurs encodeurs respectifs.
Performance
La performance texte seul est bit-identique à jina-embeddings-v5-text-nano (65,5 de moyenne MMTEB au niveau tâche, 71,0 MTEB en anglais). La performance multimodale est légèrement inférieure à jina-embeddings-v5-omni-small en raison de l'espace d'embedding de 768 dimensions (contre 1024) et du backbone texte plus petit, mais elle maintient un fort alignement cross-modal sur la récupération texte-image, texte-audio et texte-vidéo. Le modèle est optimisé pour le CPU et le matériel edge, où le modèle omni-small plus grand ne peut pas s'exécuter efficacement. La qualité de récupération cross-modal est compétitive pour sa classe de taille.
Conseils
Même modèle d'utilisation que jina-embeddings-v5-omni-small : sélectionnez l'adaptateur LoRA approprié (retrieval, text-matching, clustering, classification) et passez directement des URL d'images, des URL de fichiers audio, des URL de fichiers vidéo ou des URL de PDF via l'API — le modèle achemine chaque modalité via l'encodeur approprié. Formats audio pris en charge : WAV, MP3, FLAC, OGG, M4A, Opus. Les entrées vidéo sont traitées comme 32 frames échantillonnés uniformément. Mélangez les modalités librement au sein d'un seul batch ; l'espace d'embedding est partagé entre toutes les modalités. Utilisez la similarité cosinus pour la comparaison. La troncature Matryoshka de 768 à 32 dimensions est prise en charge. Les embeddings texte seul sont compatibles drop-in avec jina-embeddings-v5-text-nano — aucune re-indexation n'est nécessaire lors de la mise à niveau. Pour les déploiements serveurs nécessitant une précision supérieure, utilisez jina-embeddings-v5-omni-small (1024 dimensions, backbone plus grand).