Embeddings
jina-embeddings-v5-text-small
 GGUF
 MLX
 Elastic Inference Service
 API Jina
 AWS SageMaker
 Hugging Face
 Air-gapped
Aperçu
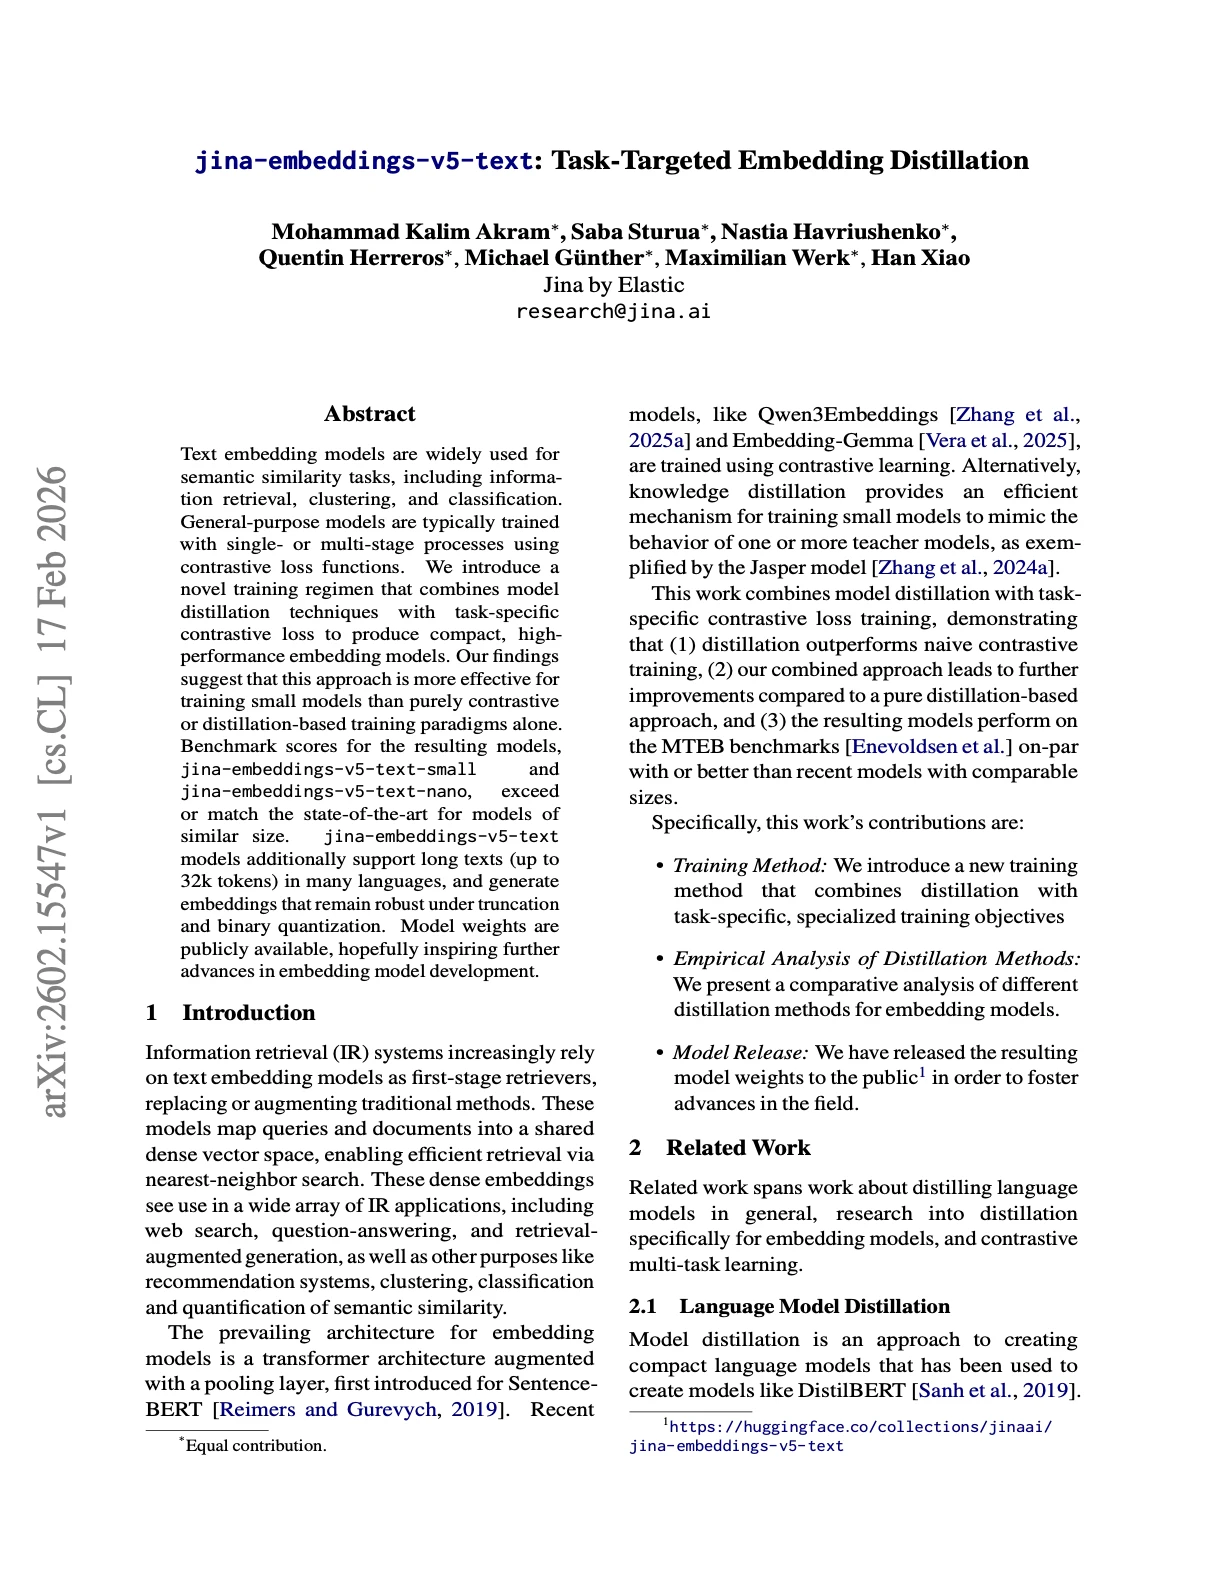
jina-embeddings-v5-text-small est un modèle d'embeddings de texte multilingue de 677M paramètres construit sur le backbone Qwen3-0,6B-Base. Il prend en charge un contexte de 32K tokens, produit des embeddings de 1024 dimensions avec troncature Matryoshka jusqu'à 32 dimensions et atteint la meilleure moyenne MTEB parmi tous les modèles avec moins de 1B de paramètres. C'est le modèle d'embeddings par défaut de l'API Jina et la recommandation principale pour les pipelines RAG de production.
Méthodes
Le modèle est construit sur Qwen3-0,6B-Base, un modèle de langage multilingue pré-entraîné sur 119 langues. Il emploie le Last-Token-Pooling pour générer des embeddings. L'entraînement suit un régime en deux étapes : (1) la distillation d'embeddings depuis Qwen3-Embedding-4B (un maître de 4B paramètres) transfère des représentations d'embedding de haute qualité à l'élève de 677M ; (2) une perte contrastive spécifique aux tâches affine le modèle sur la récupération, la correspondance de texte, le regroupement et la classification. Geometric Orthogonal Regularization (GOR) garantit que les embeddings restent robustes sous quantification binaire avec une perte de performance minimale. Matryoshka Representation Learning permet la troncature des dimensions de 1024 à 32 tout en préservant une forte qualité de récupération au-dessus de 256 dimensions. La fenêtre de contexte de 32K est rendue possible par des embeddings de position rotatifs aux fréquences de base ajustées, et le modèle a été entraîné en supplément sur des données de contexte long pour une récupération de documents longs robuste.
Performance
Sur MMTEB (multilingue), le modèle atteint 67,0 de moyenne (niveau tâche) et 58,9 de moyenne (niveau type), le plus élevé parmi tous les modèles avec moins de 1B de paramètres. Scores au niveau tâche : classification 71,3, regroupement 53,4, classification de paires 82,9, reranking 65,7, récupération 64,9, STS 78,9. Sur MTEB en anglais, il atteint 71,7 de moyenne, dépassant Qwen3-0,6B avec instructions (70,5) et jina-embeddings-v3 (65,7). Spécifique à la récupération : 64,88 sur MTEB-M, 66,84 sur RTEB, 56,67 sur BEIR, 66,39 sur LongEmbed. Fait notable : le modèle surpasse son maître 4B Qwen3-Embedding-4B en classification de paires (42,0 vs. 26,8 sur MMTEB) tout en étant 6× plus petit, démontrant que la distillation combinée à un entraînement contrastif spécifique aux tâches peut dépasser la performance du maître sur des tâches données.
Conseils
Sélectionnez l'adaptateur LoRA approprié : 'retrieval' pour la recherche asymétrique query-document (préfixer les requêtes par 'Query:' et les passages par 'Document:'), 'text-matching' pour la similarité symétrique (préfixe 'Document:' pour les deux entrées), 'clustering' pour regrouper des documents liés, 'classification' pour la catégorisation et l'analyse de sentiment. La troncature Matryoshka à 256–512 dimensions convient à l'indexation contrainte en stockage ; utilisez les 1024 dimensions complètes pour le reranking. La quantification binaire est prise en charge avec une perte de performance minimale. La fenêtre de contexte de 32K traite les documents longs nativement sans chunking. Utilisez la similarité cosinus pour comparer les embeddings. Disponible via l'API Jina AI, Hugging Face (Sentence Transformers, vLLM) et des variantes quantifiées pour llama.cpp. Pour les charges multimodales, utilisez plutôt jina-embeddings-v5-omni-small.