Reranker
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 API Jina
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-gapped
Aperçu
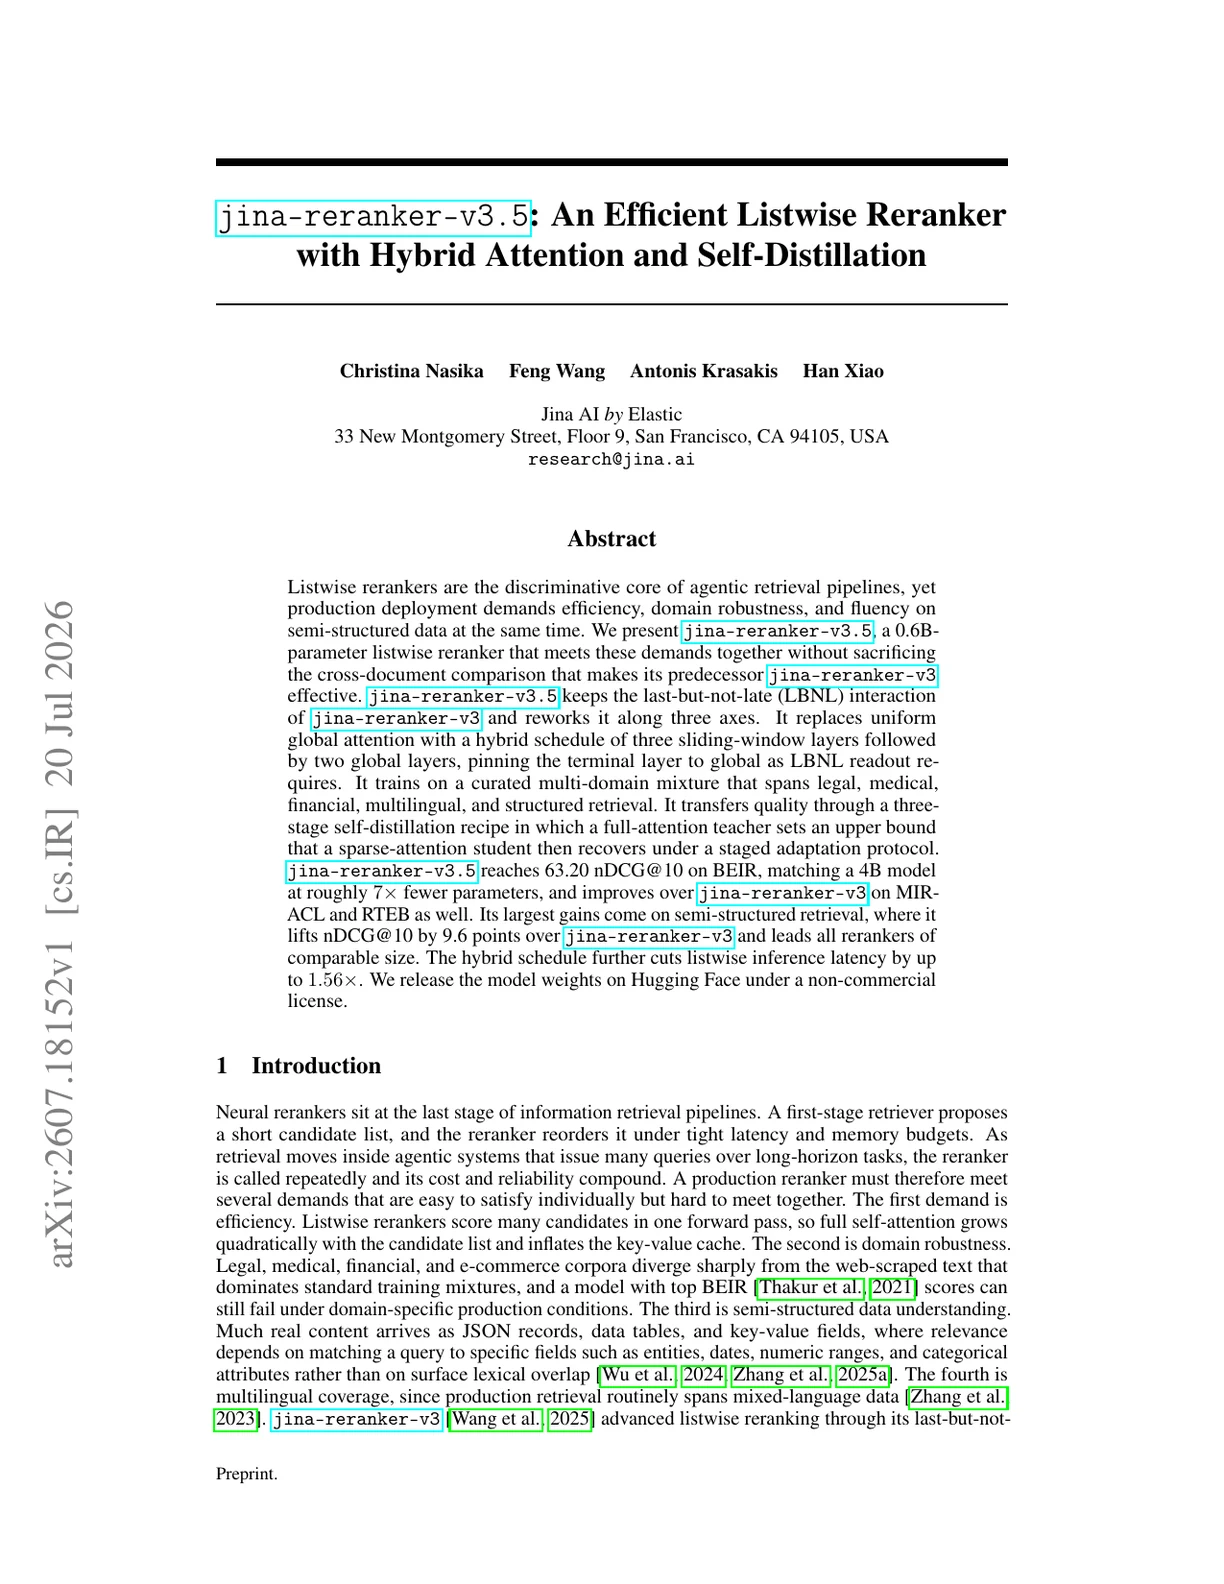
jina-reranker-v3.5 est un reranker listwise de 0,6B paramètres qui égale les modèles de 4B paramètres avec environ 7× moins de paramètres. Il introduit un calendrier d'attention hybride (trois couches de fenêtre glissante + deux couches globales) apparié à une recette d'auto-distillation en trois étapes qui transfère la qualité d'un enseignant à attention complète à un élève à attention dispersée. C'est un remplacement direct (drop-in) de jina-reranker-v3, conservant le même schéma d'API tout en améliorant l'efficacité et la couverture des domaines.
Méthodes
L'architecture conserve la conception listwise LBNL de jina-reranker-v3 : la requête et tous les documents candidats partagent une unique fenêtre de contexte, et les embeddings sont lus du dernier token de chaque document. L'innovation clé est le calendrier d'attention hybride. Au lieu d'une attention globale uniforme à chaque couche, le modèle utilise trois couches d'attention en fenêtre glissante (restreignant l'attention de chaque position à une fenêtre locale) suivies de deux couches d'attention globale. La couche terminale est verrouillée sur l'attention globale parce que le mécanisme de lecture LBNL exige que le dernier token prenne en compte le contexte complet. L'entraînement procède en trois étapes : (1) un modèle enseignant à attention complète est entraîné sur un mélange multidomaine curé couvrant le juridique, le médical, le financier, le multilingue et la recherche structurée ; (2) un élève à attention dispersée est initialisé à partir de l'enseignant et ajusté par adaptation progressive, en augmentant graduellement la proportion d'étapes d'entraînement utilisant le calendrier hybride ; (3) un passe final de distillation où l'élève apprend à reproduire les distributions de classement douces de l'enseignant, récupérant plus de 97 % de la qualité de classement de l'enseignant tout en exécutant le chemin d'inférence à attention dispersée, moins coûteux.
Performance
Sous un protocole unifié top-100 avec jina-embeddings-v5-text-small comme récupérateur de premier stade, le modèle obtient 63,20 NDCG{'@'}10 sur BEIR, 74,11 sur MIRACL, 70,95 sur RTEB et 48,3 sur Struct-IR, améliorant jina-reranker-v3 (62,10 / 72,20 / 68,01 / 38,7) sur chaque axe. Son score BEIR devance le Qwen3-Reranker de 4B (62,28) avec environ 7× moins de paramètres. Les gains relatifs par rapport à v3 incluent +1,10 BEIR, +2,6 % MIRACL, +4,3 % RTEB (avec de fortes avancées en recherche juridique) et +24,8 % sur le classement de données structurées (Struct-IR). L'inférence listwise tourne 1,22×–1,56× plus vite que v3 des contextes courts aux longs (A100, FlashAttention-2). Le mélange d'entraînement multidomaine produit des améliorations particulièrement fortes sur les données semi-structurées (tableaux, JSON, XML) et les corpus de domaine spécifique.
Conseils
jina-reranker-v3.5 est un remplacement direct de jina-reranker-v3 : le schéma de requête ne change pas, donc changer la chaîne du modèle ne requiert aucune modification de code. Il classe une requête contre la liste complète de candidats en un seul appel — transmettez les documents via le point de terminaison standard de rerank et utilisez top_n pour limiter les résultats renvoyés, ou réglez return_embeddings pour aussi récupérer les embeddings de documents. Le modèle est particulièrement fort sur le classement de données structurées, la recherche juridique et dans d'autres domaines spécifiques, et les collections multilingues. Sa conception à attention hybride maintient une latence faible sur les longues listes de candidats. La fenêtre de contexte de 131K tokens supporte les très longs documents sans découpage. Disponible sous CC-BY-NC-4.0 sur Hugging Face ; contactez Jina AI pour un usage commercial. Pour les déploiements isolés (air-gapped) ou sur place, des poids quantifiés sont disponibles. Associez avec jina-embeddings-v5-text-small ou jina-embeddings-v4 comme récupérateur de premier stade.