Reranker
jina-reranker-v3
 GGUF
 MLX
 Elastic Inference Service
 API Jina
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-gapped
Aperçu
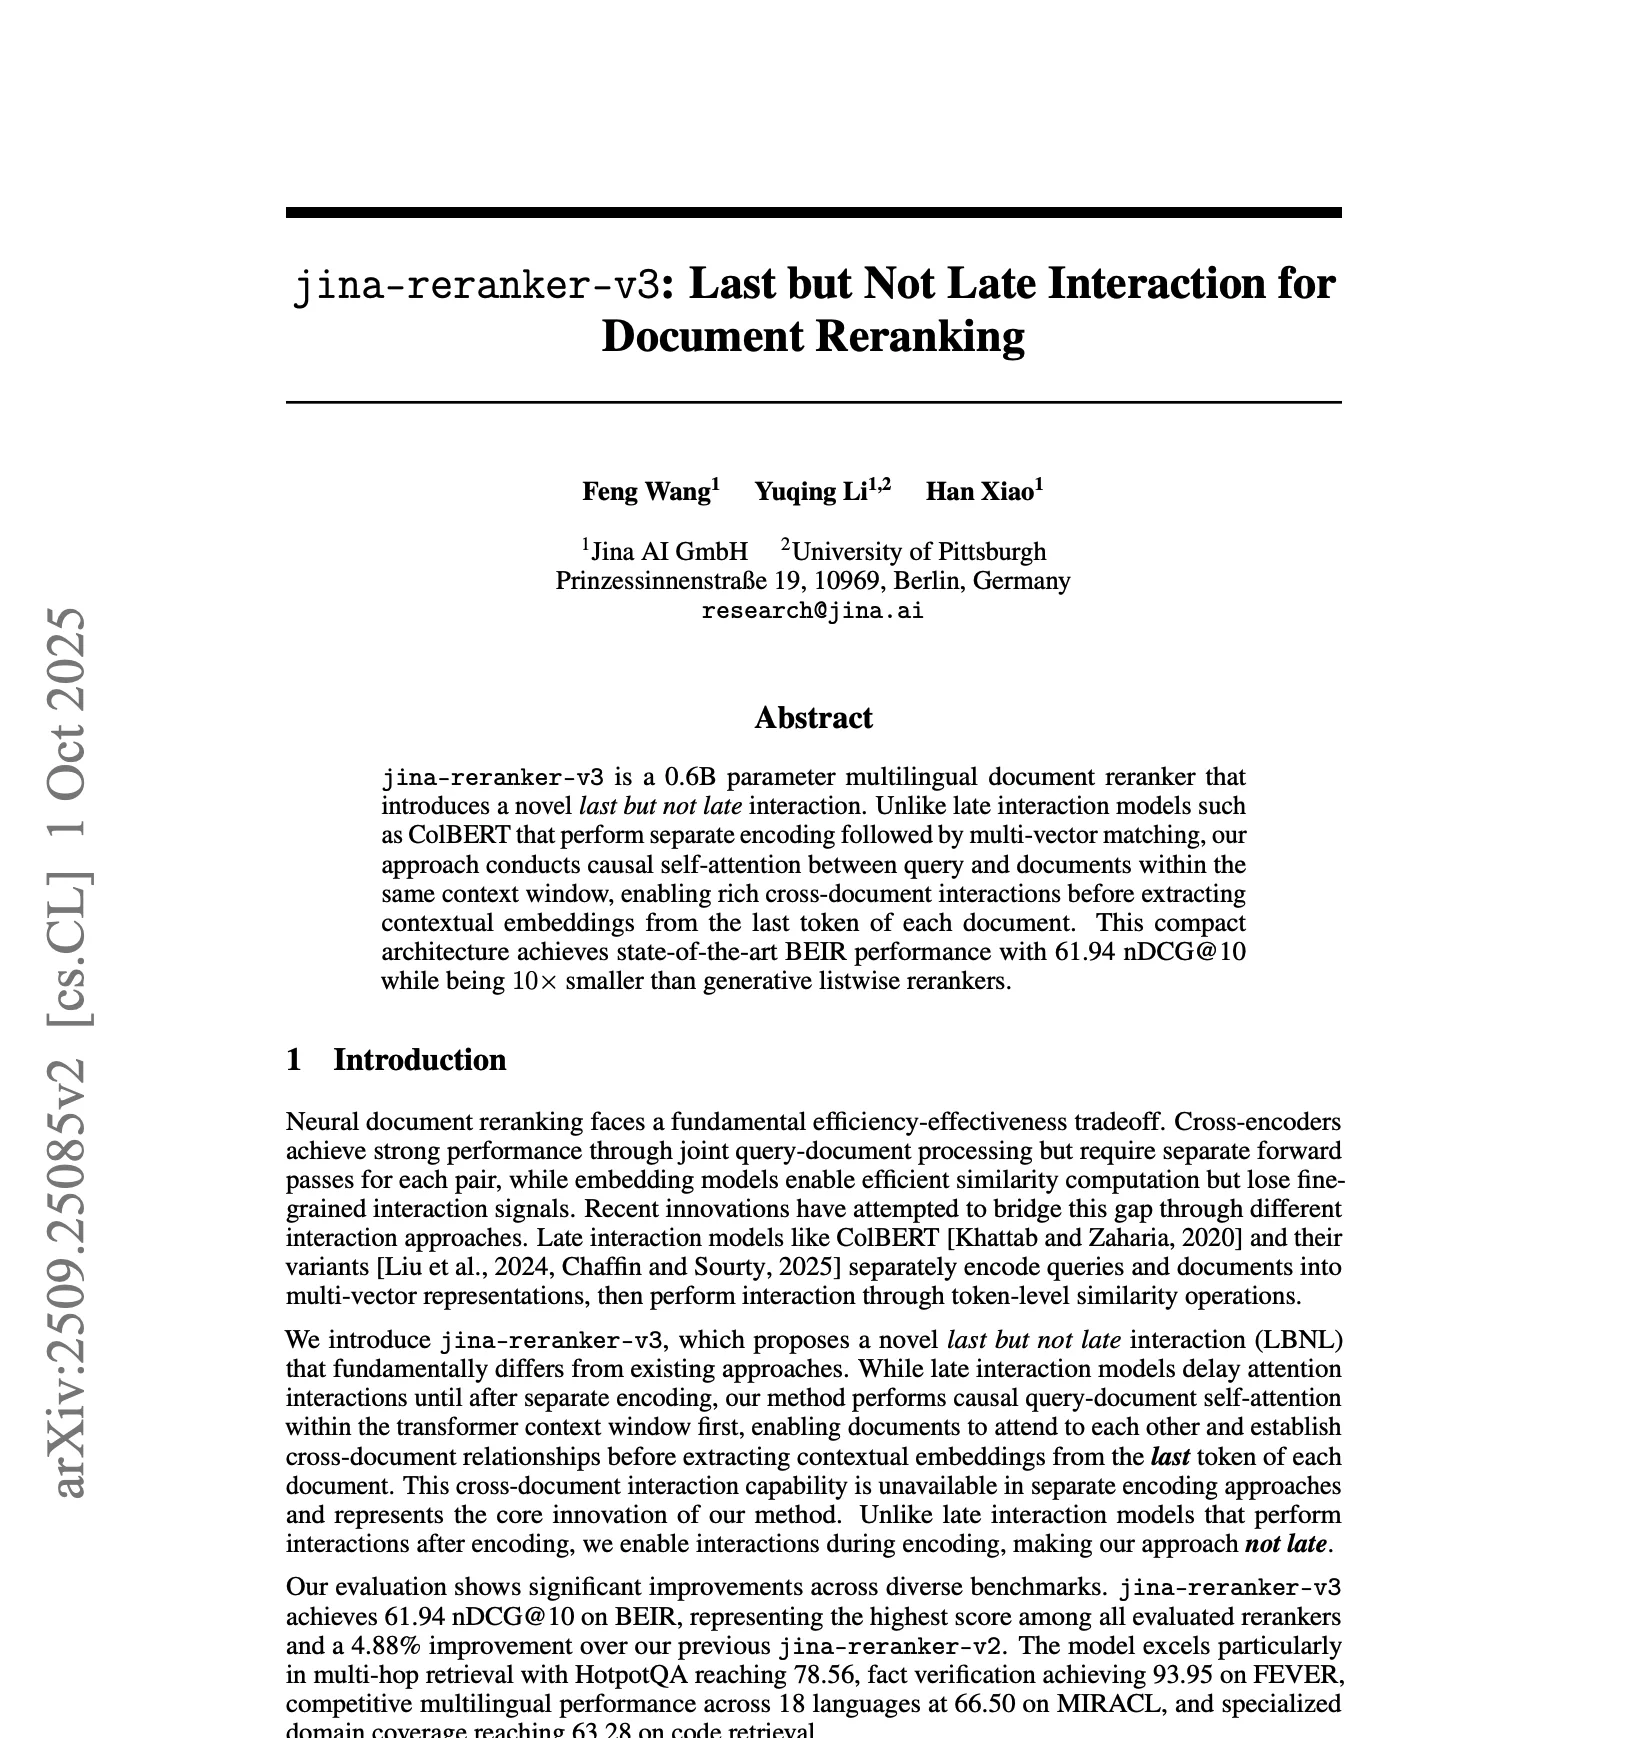
jina-reranker-v3 est un reranker listwise multilingue de 597M paramètres qui introduit l'interaction « last but not late » (LBNL), un changement de paradigme par rapport au scoring par paires de cross-encodeur. Au lieu d'évaluer chaque paire requête-document de façon isolée, il traite simultanément une liste entière de documents candidats au sein d'une unique fenêtre de contexte de 131K tokens, en utilisant l'attention causale pour capturer les relations inter-documents. Il atteint une performance BEIR de pointe (61,94 NDCG{'@'}10) avec 2,5× moins de paramètres que le concurrent le plus proche.
Méthodes
L'innovation centrale est l'architecture LBNL. Dans un cross-encodeur standard, chaque paire requête-document est scorée de manière indépendante. Dans un modèle à late-interaction (ColBERT), les documents sont encodés séparément et appariés token par token. LBNL combine les forces des deux : la requête et tous les documents candidats partagent une unique fenêtre d'attention causale, permettant au modèle de prêter attention d'un document à l'autre et de capturer les signaux de pertinence relative que le scoring par paires rate. Le modèle traite jusqu'à 16 documents par passe avant (un positif et 15 négatifs pendant l'entraînement), chaque document étant tronqué à une longueur fixe. Les embeddings sont extraits du dernier token de chaque document via le Last-Token-Pooling, exploitant le mécanisme d'attention causale pour agréger naturellement l'information du contexte précédent. La fenêtre de contexte de 131K tokens est rendue possible par des encodings positionnels rotatifs avec des fréquences de base ajustées. L'entraînement utilise un curriculum progressif en trois étapes avec une perte multi-objectif combinant InfoNCE, perte dispersive (poids 0,45), perte de double appariement (poids 0,85) et perte de similarité.
Performance
Sur BEIR, le modèle atteint 61,94 NDCG{'@'}10, le plus élevé parmi tous les rerankers évalués et une amélioration de 4,88 % par rapport à jina-reranker-v2. Il excelle dans la recherche multi-sauts (78,56 sur HotpotQA) et la vérification de faits (93,95 sur FEVER). Le rendement multilingue atteint 66,50 sur MIRACL sur 18 langues, avec 78,69 en arabe et 81,06 en thaï. La recherche de code atteint 63,28 sur CoIR. Il surpasse le mxbai-rerank-large de 1,5B (61,44) avec 2,5× moins de paramètres et montre une amélioration de 5,43 % face à bge-reranker-v2-m3 de la même échelle. Le rendement est relativement stable à travers les ordonnements de documents : aléatoire (62,54), décroissant (61,94), croissant (61,52) — indiquant un scoring listwise robuste indépendant de l'ordonnancement des candidats.
Conseils
Utilisez le gabarit de prompt structuré avec les rôles système/utilisateur/assistant et des jetons spéciaux pour l'extraction des embeddings. Traitez jusqu'à 64 documents par passage en avant pour les collections dépassant le contexte de 131K. Optimal avec des documents ordonnés aléatoirement ou par pertinence décroissante (la différence de performance est <1 %). Exploitez la capacité d'interaction inter-documents pour les tâches de classement comparatif — la conception listwise du modèle capture les relations entre candidats que le scoring par paires rate. Pour les applications multilingues, le modèle offre un transfert zero-shot solide sur 18 langues. Implémentez le traitement par lots pour les grands volumes de documents, en maintenant les embeddings de requête de manière cohérente entre les lots. Les embeddings de sortie à 256 dimensions soutiennent un calcul de similarité efficace. Idéal pour les tâches de raisonnement multi-sauts et de vérification de faits. Pour la production, utilisez jina-reranker-v3.5 pour une inférence 1,22–1,56× plus rapide via l'attention hybride.