Actualités

Accélérez la recherche IA, un token à la fois.

RSS
Mis en exergue
Publications académiques
arXiv
septembre 02, 2026
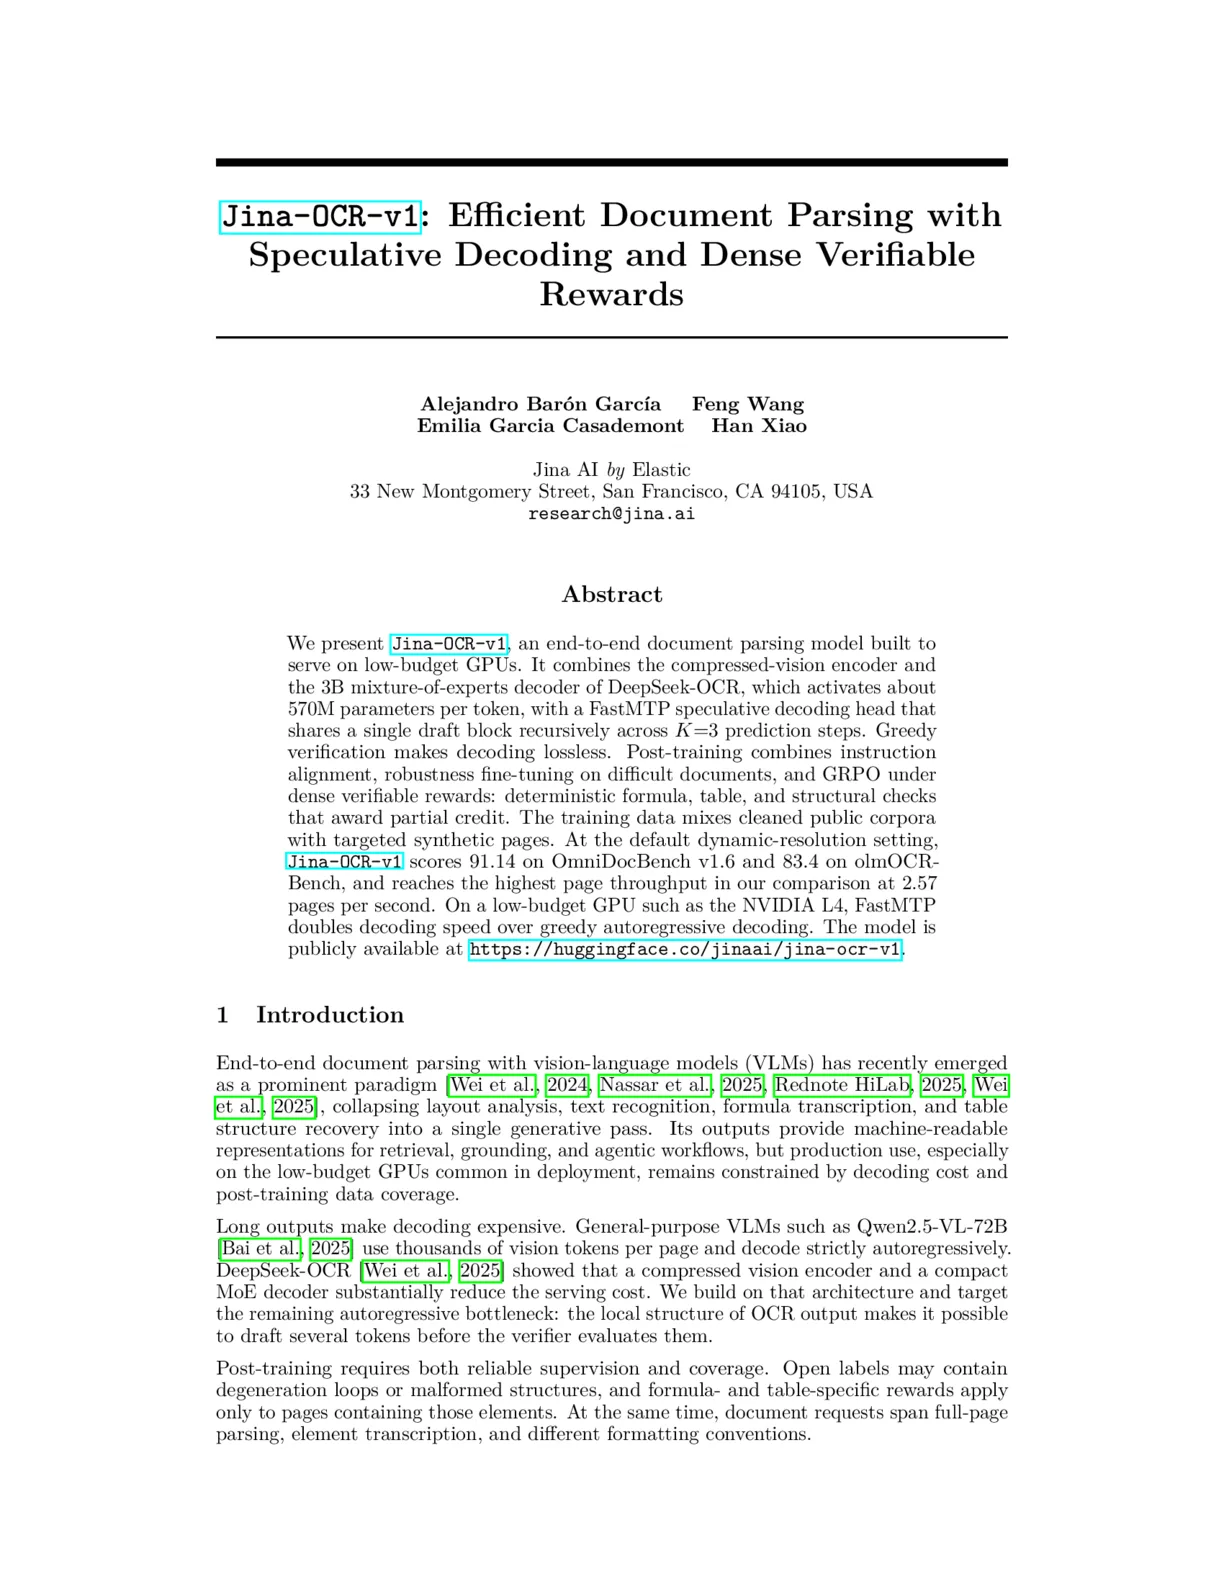
jina-ocr-v1: Efficient Document Parsing with Speculative Decoding and Dense Verifiable Rewards
arXiv
juillet 20, 2026
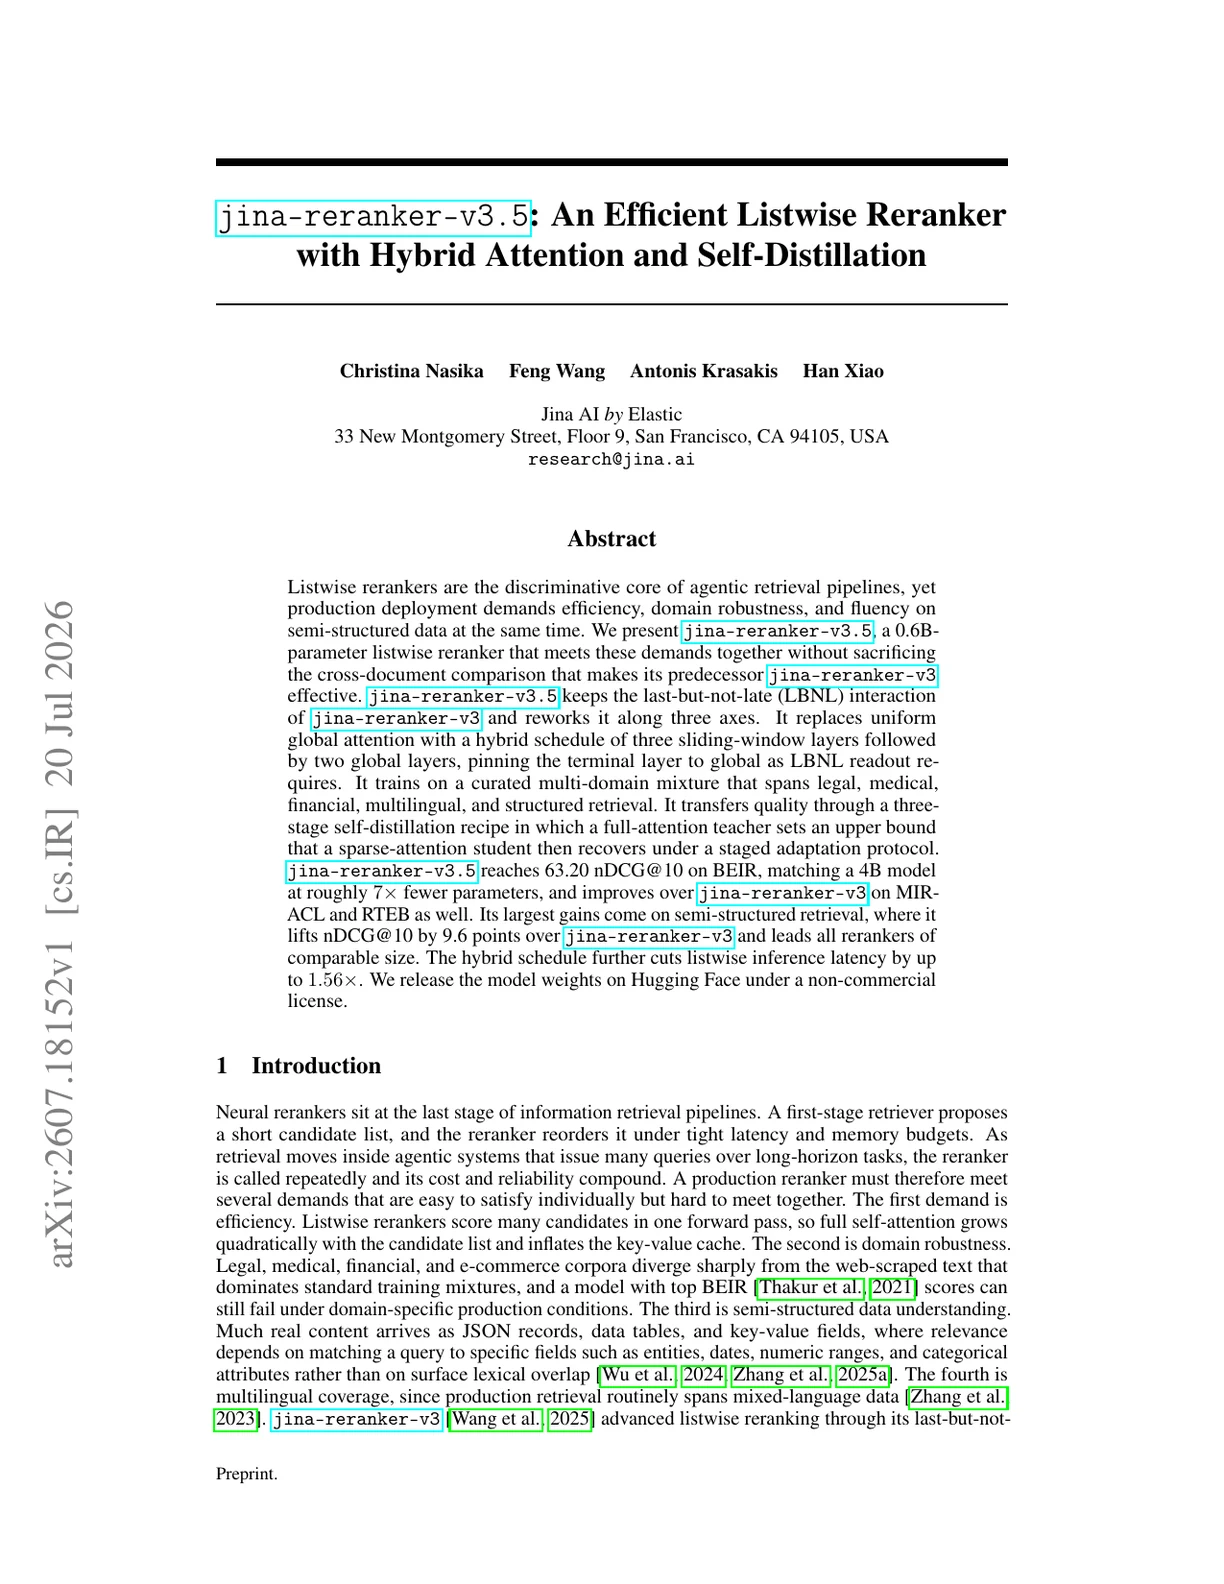
jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation
SIGIR 2026
mai 11, 2026
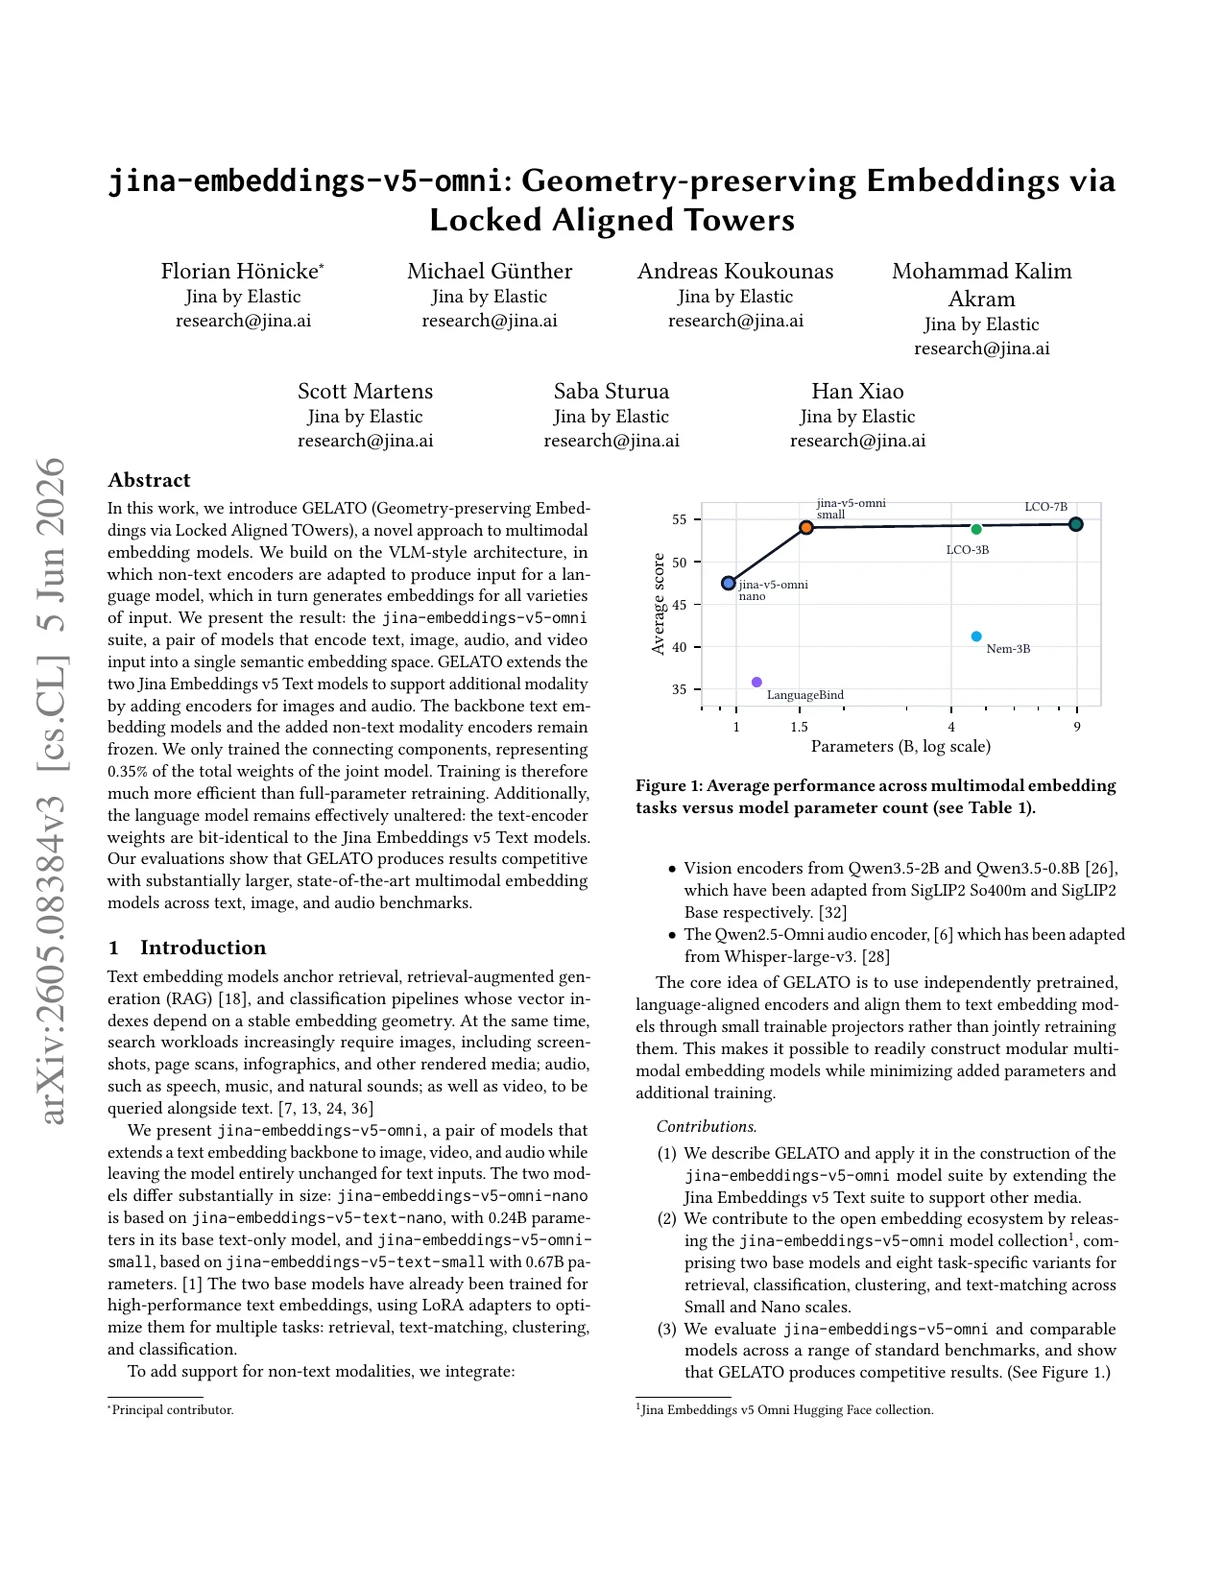
jina-embeddings-v5-omni: Geometry-preserving Embeddings via Locked Aligned Towers
SIGIR 2026
février 17, 2026
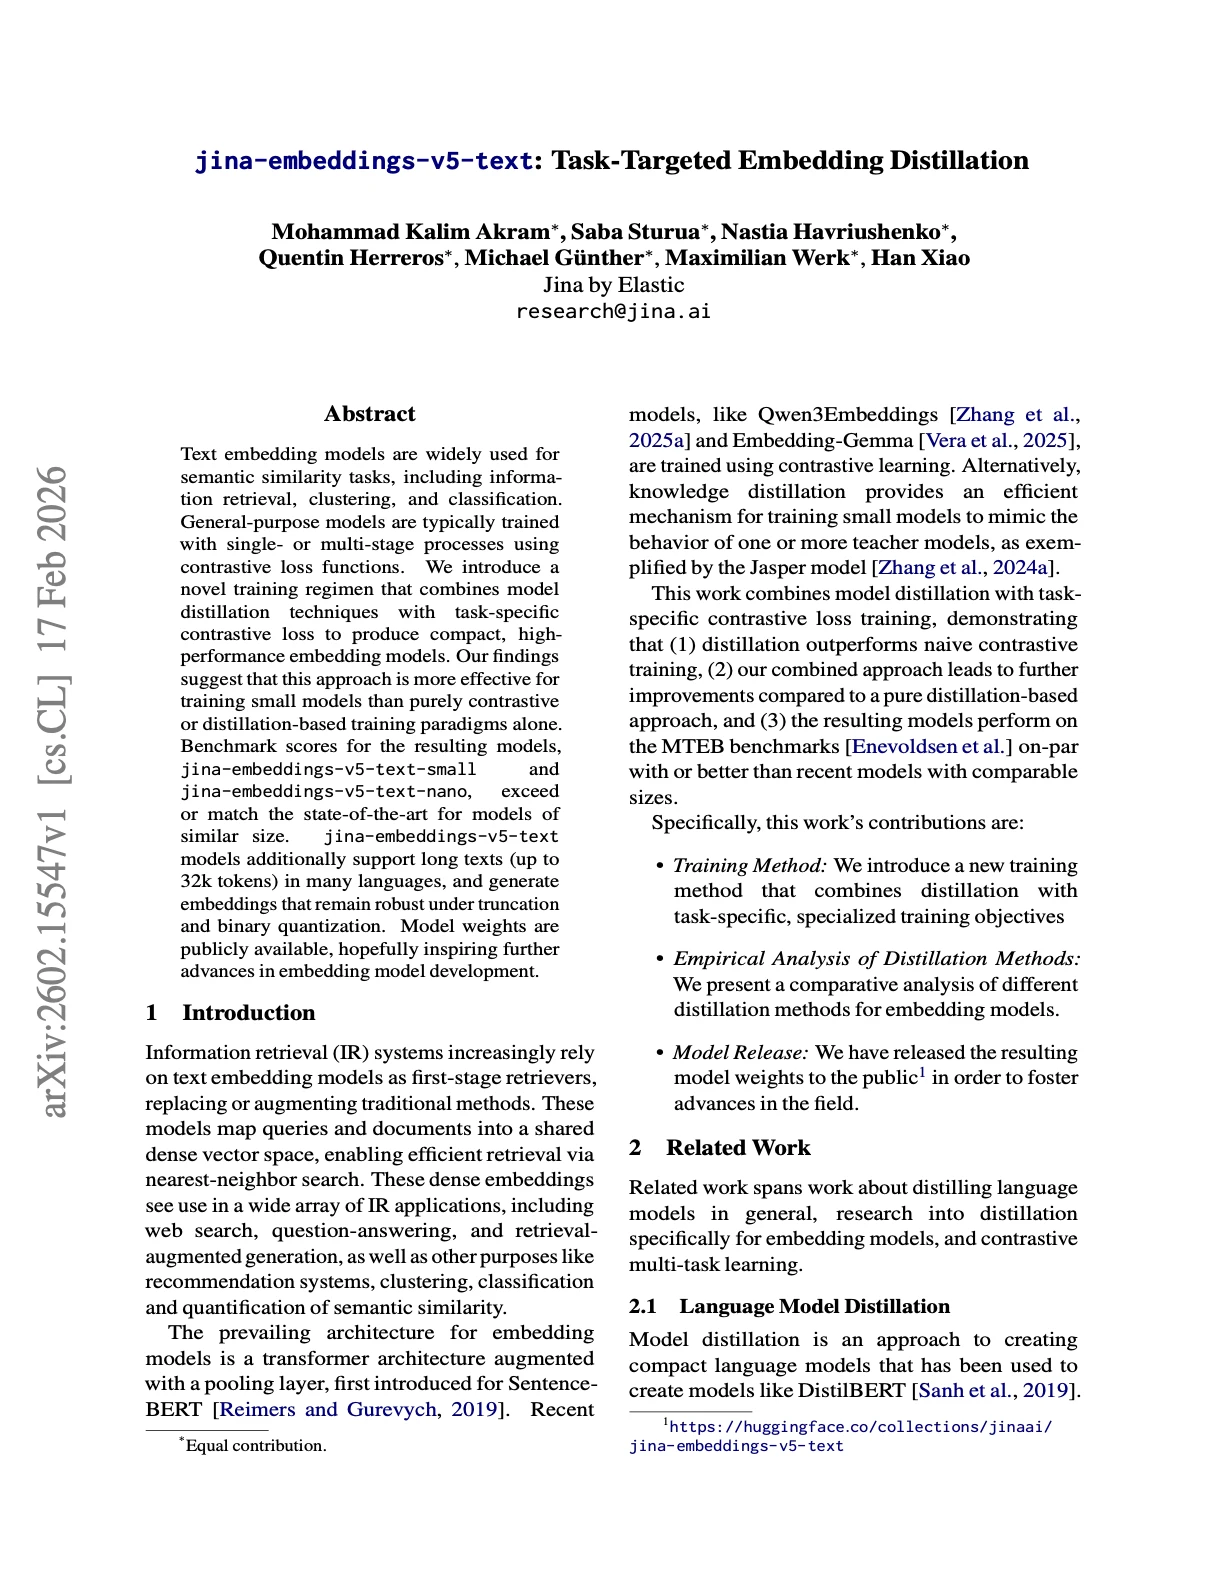
jina-embeddings-v5-text: Task-Targeted Embedding Distillation
ICLR 2026
janvier 22, 2026
Embedding Compression via Spherical Coordinates
arXiv
décembre 29, 2025
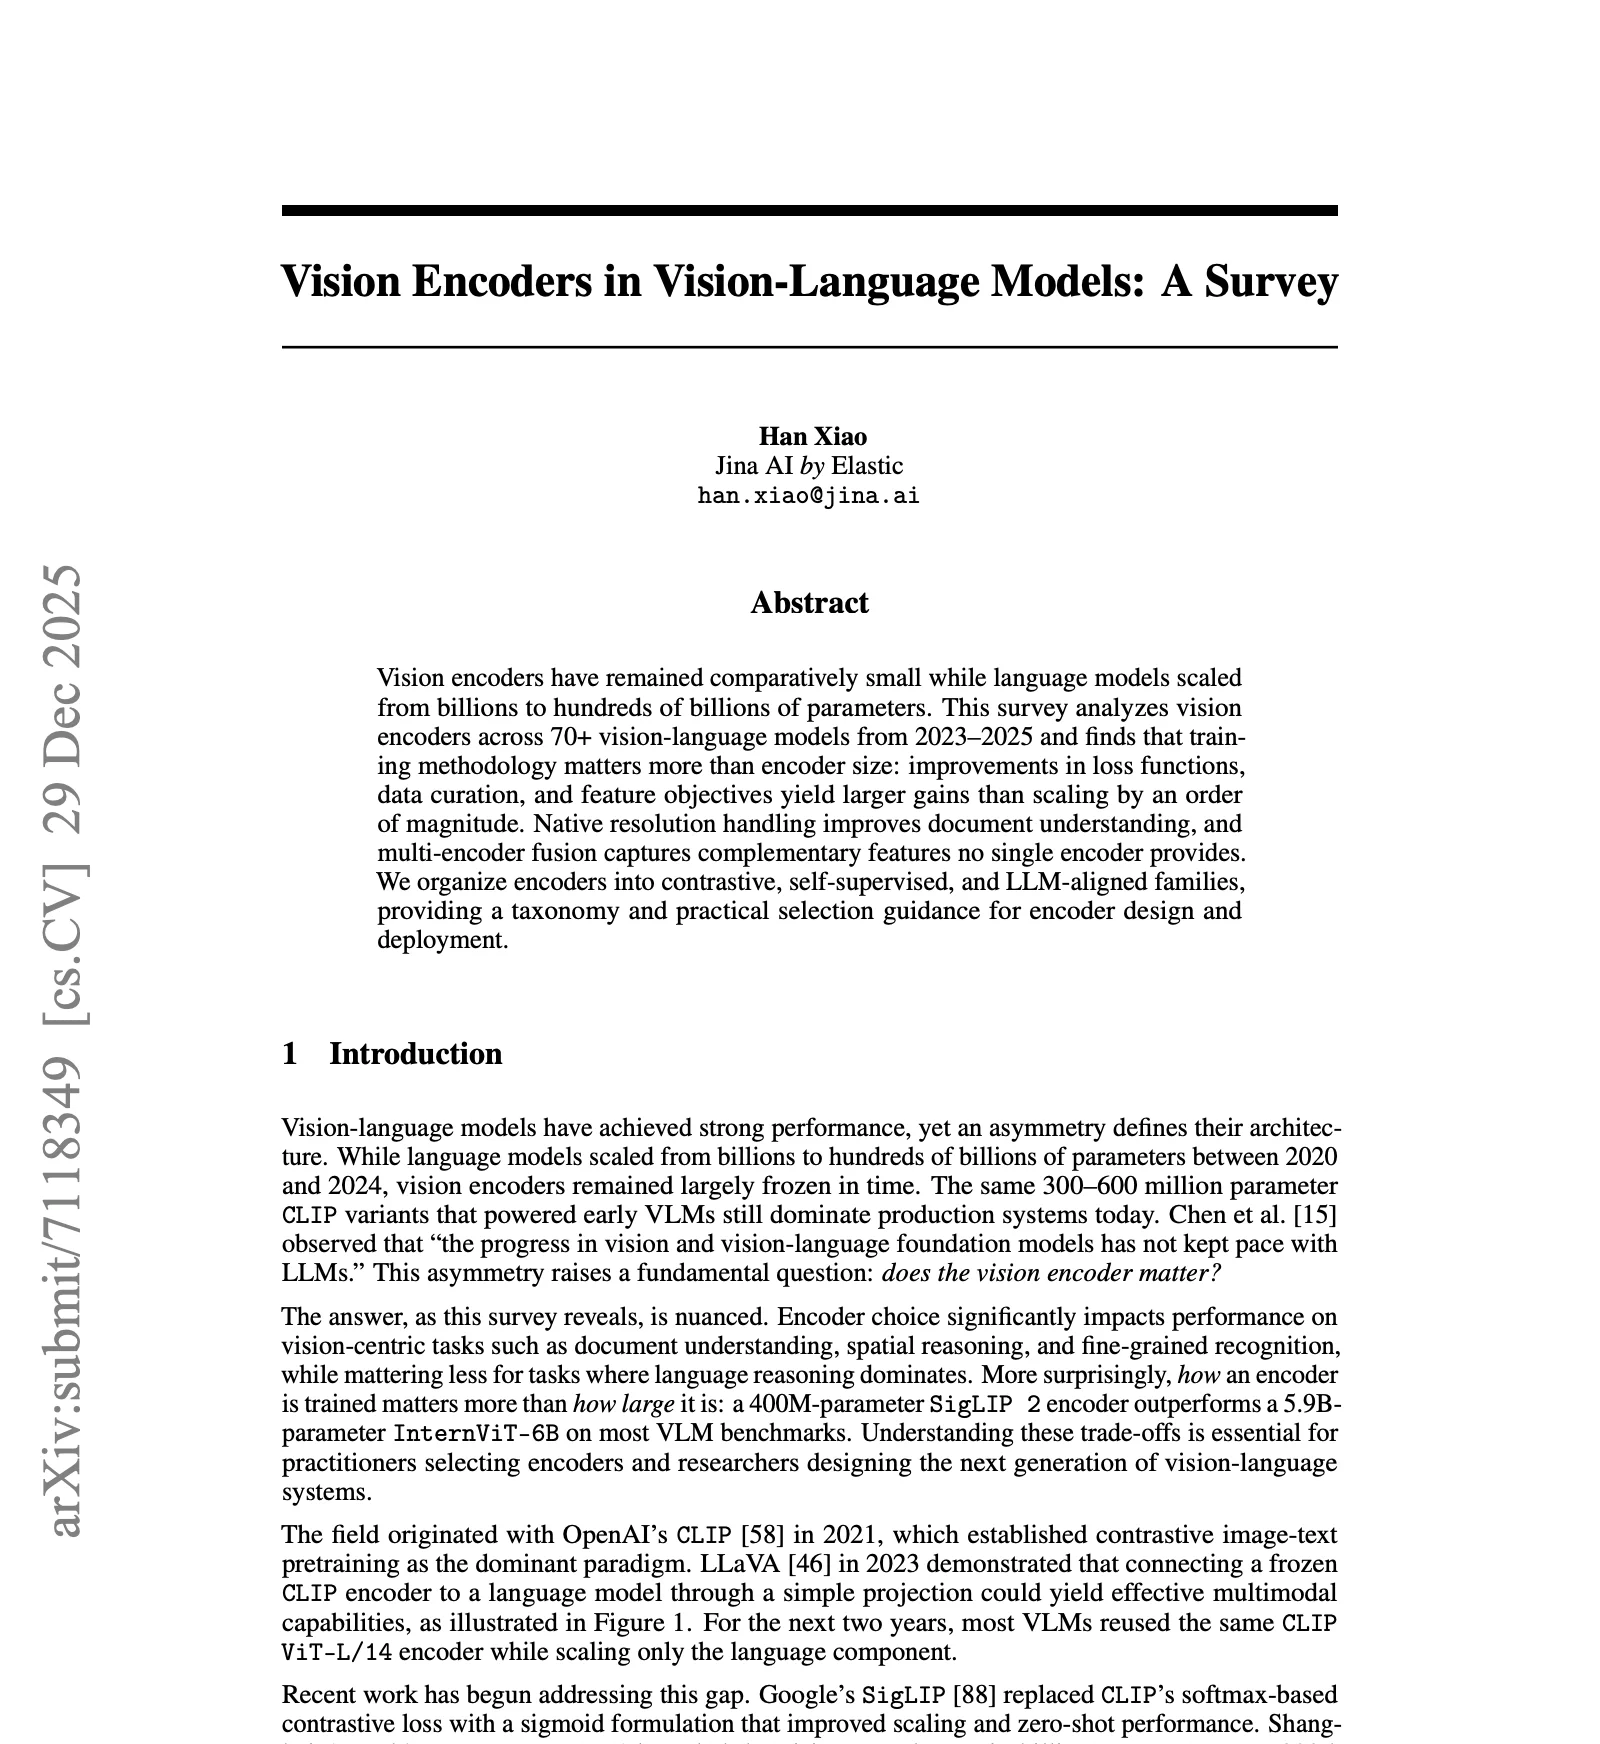
Vision Encoders in Vision-Language Models: A Survey
ICLR 2026
décembre 04, 2025
Jina-VLM: Small Multilingual Vision Language Model
AAAI 2026
octobre 01, 2025
jina-reranker-v3: Last but Not Late Interaction for Document Reranking
NeurIPS 2025
août 31, 2025
Efficient Code Embeddings from Code Generation Models
EMNLP 2025
juin 24, 2025
jina-embeddings-v4: Universal Embeddings for Multimodal Multilingual Retrieval
ICLR 2025
mars 04, 2025
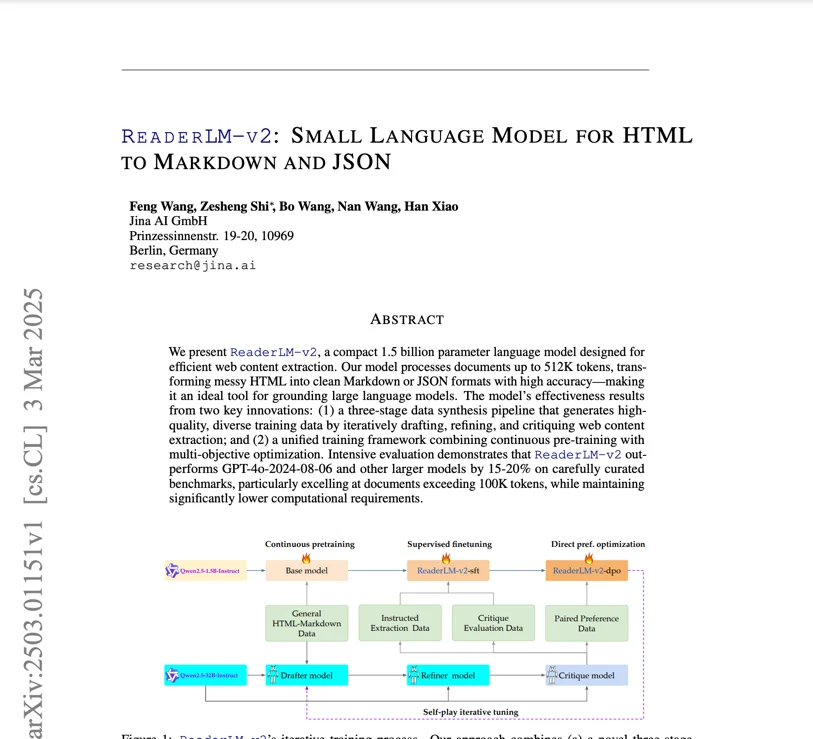
ReaderLM-v2: Small Language Model for HTML to Markdown and JSON
ACL 2025
décembre 17, 2024
AIR-Bench: Automated Heterogeneous Information Retrieval Benchmark
ICLR 2025
décembre 12, 2024
jina-clip-v2: Multilingual Multimodal Embeddings for Text and Images
ECIR 2025
septembre 18, 2024
jina-embeddings-v3: Multilingual Embeddings With Task LoRA
SIGIR 2025
septembre 07, 2024
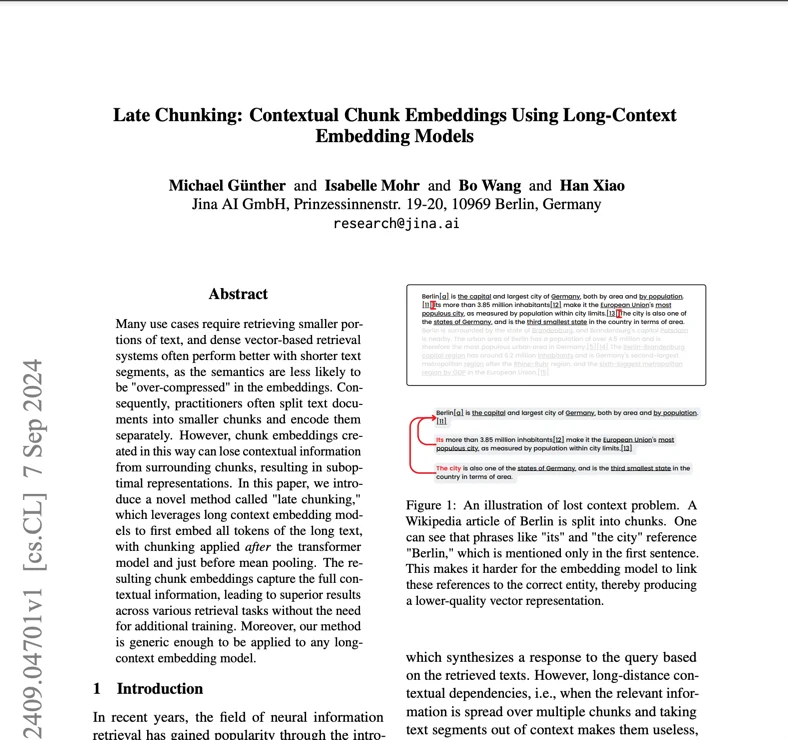
Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models
EMNLP 2024
août 30, 2024
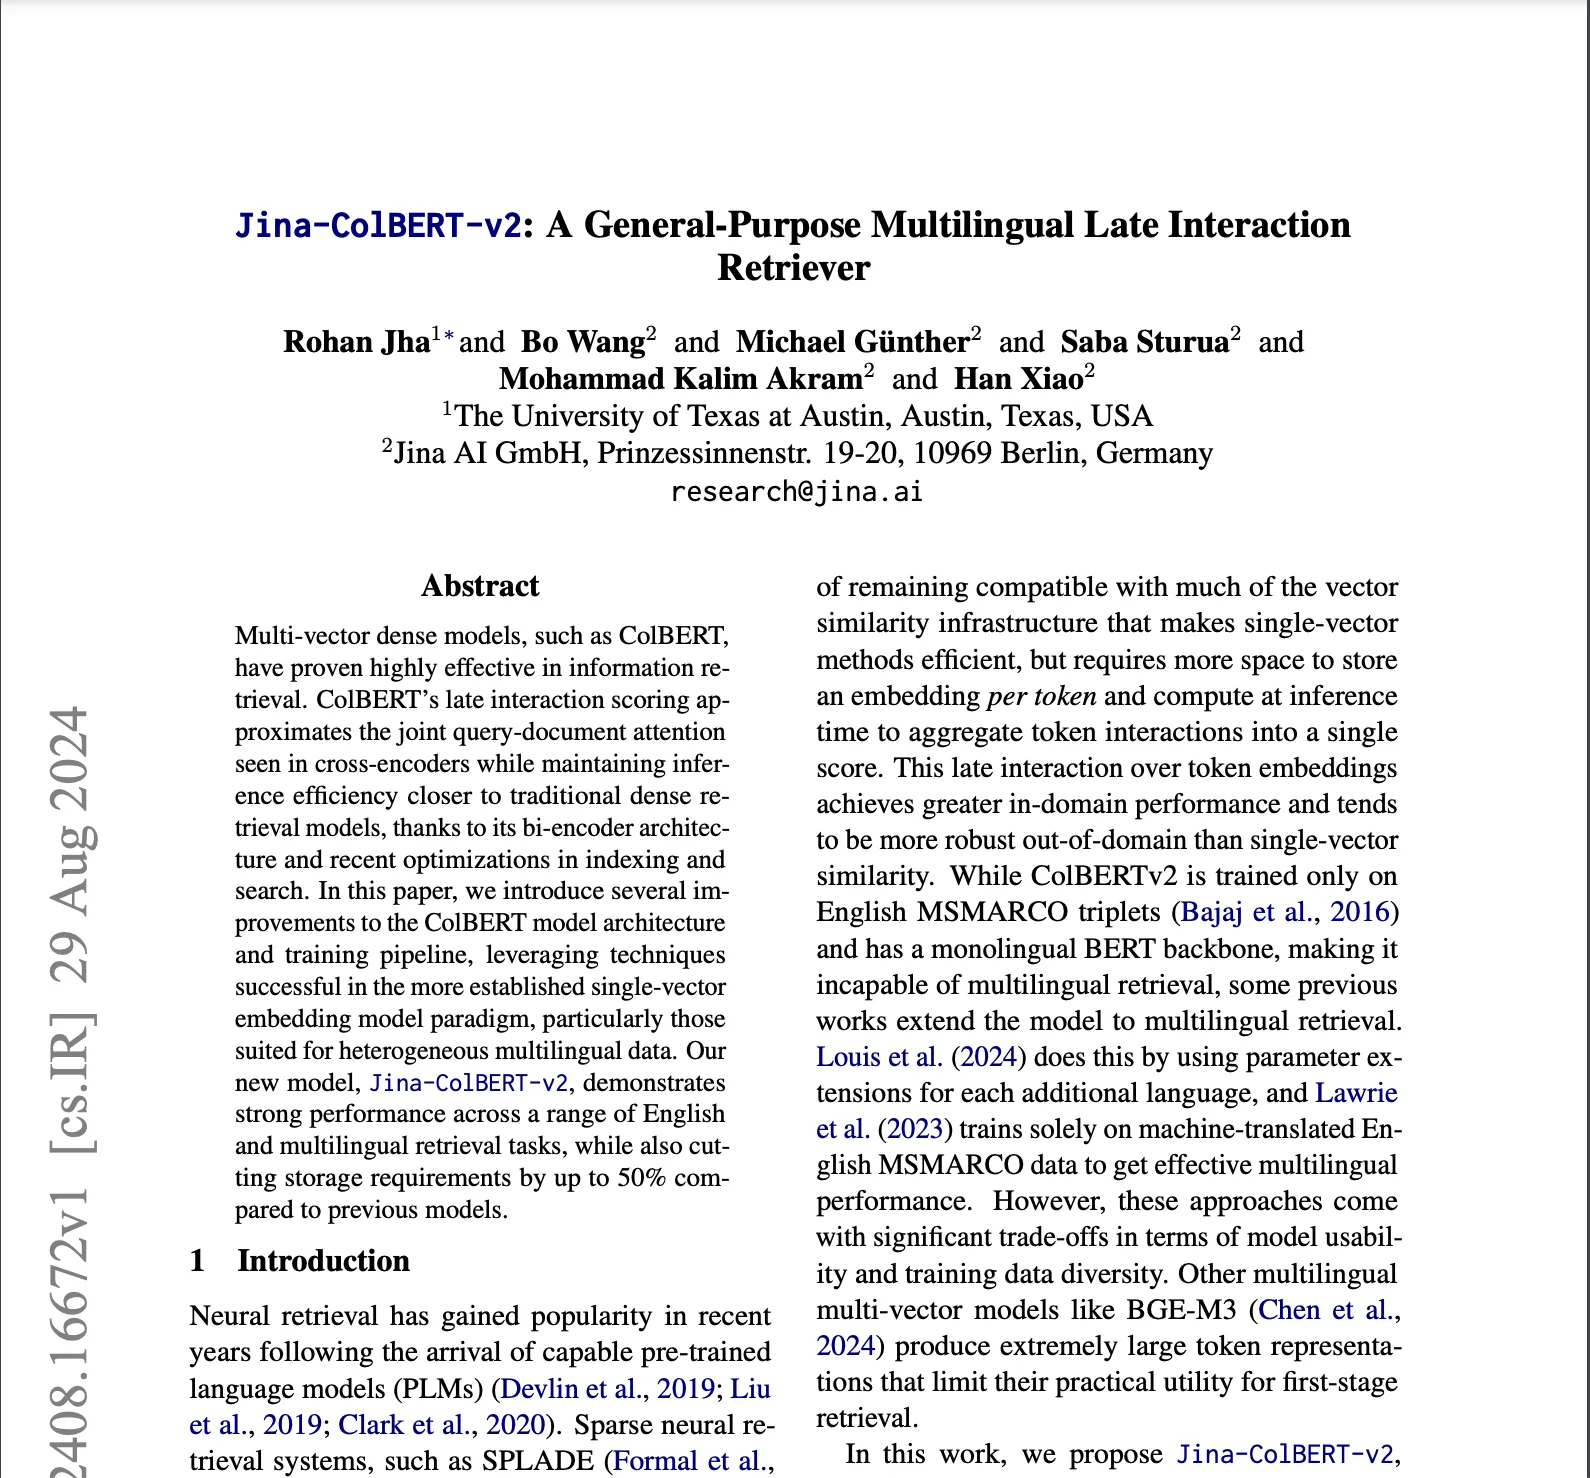
Jina-ColBERT-v2: A General-Purpose Multilingual Late Interaction Retriever
WWW 2025
juin 21, 2024
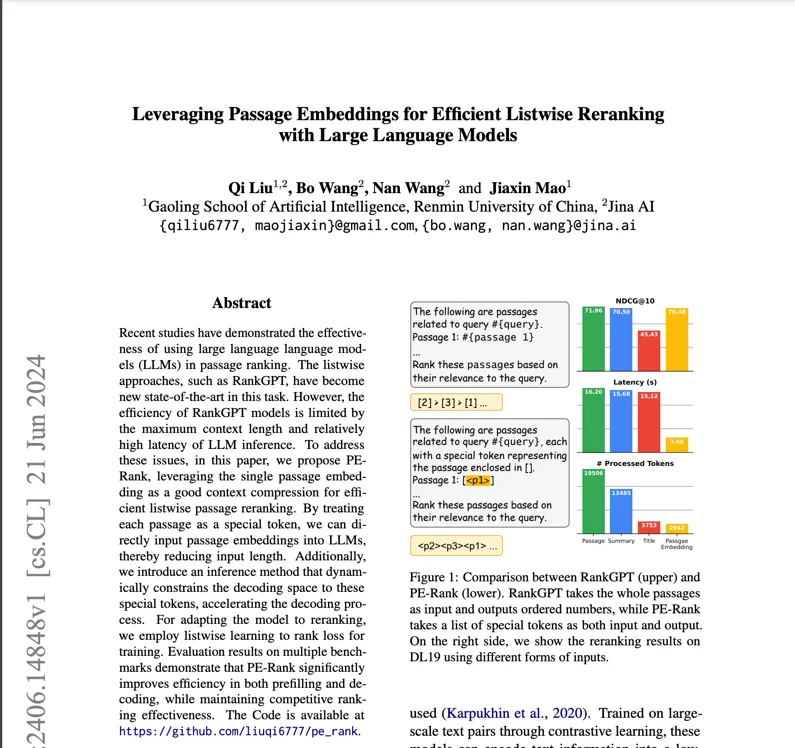
Leveraging Passage Embeddings for Efficient Listwise Reranking with Large Language Models
ICML 2024
mai 30, 2024
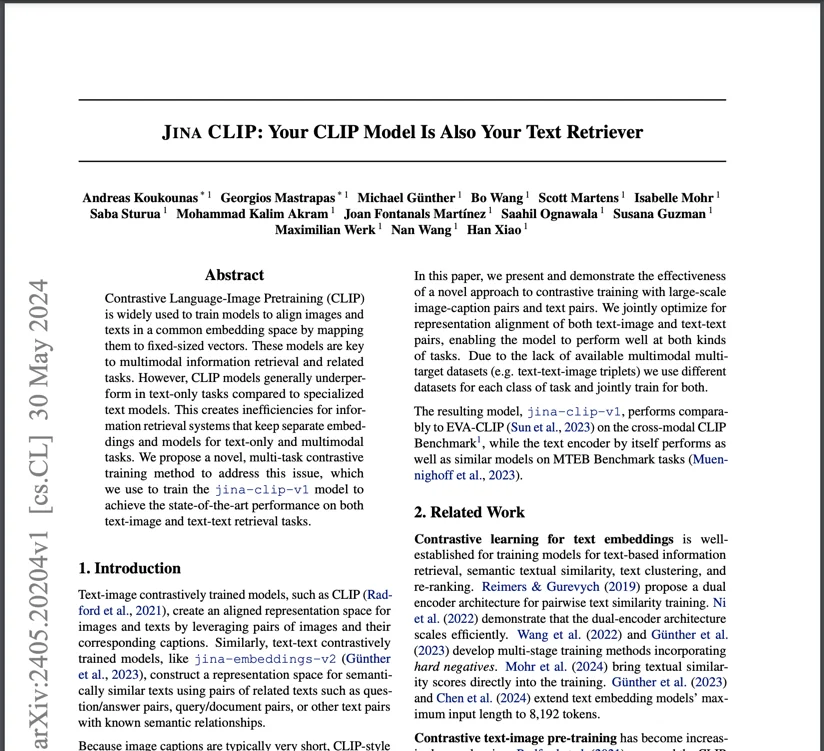
Jina CLIP: Your CLIP Model Is Also Your Text Retriever
arXiv
février 26, 2024
Multi-Task Contrastive Learning for 8192-Token Bilingual Text Embeddings
arXiv
octobre 30, 2023
Jina Embeddings 2: 8192-Token General-Purpose Text Embeddings for Long Documents
EMNLP 2023
juillet 20, 2023
Jina Embeddings: A Novel Set of High-Performance Sentence Embedding Models
21 publications au total.

septembre 14, 2026 • 9 minutes lues
jina-ocr-v1 : Analyse de documents plus rapide sur des GPU à budget limité
jina-ocr-v1 est un modèle vision-langage doté de 3,4 milliards de paramètres et de 570 millions de paramètres actifs, obtenant un score de 91,1 sur OmniDocBench v1.6 et de 83,4 sur olmOCR-Bench.
août 03, 2026 • 11 minutes lues
jina-reranker-v3.5 : Reclassement par liste plus rapide avec attention hybride et autodistillation
Un reranker listwise de 0,6 milliard de paramètres qui surpasse le Qwen3-Reranker-4B sur le benchmark BEIR, offre une vitesse de reranking jusqu'à 1,56 fois plus rapide que la v3, et gagne 9,6 points de nDCG@10 sur la recherche semi-structurée.
mai 12, 2026 • 7 minutes lues
jina-embeddings-v5-omni : Modèles vectoriels pour le texte, l'image, l'audio et la vidéo
Un modèle, quatre modalités : texte, image, audio, vidéo. Des modèles d'embeddings omni de premier ordre en 1,6B et 0,9B.
mars 11, 2026 • 7 minutes lues
Bootstrapping d'embeddings audio à partir de LLM multimodaux
Transformez n'importe quel LLM multimodal en un petit modèle de plongements audio qui surpasse CLAP avec 25 fois moins de données.
mars 06, 2026 • 6 minutes lues
Identifier les modèles d'embeddings à partir de valeurs numériques brutes
Un minuscule transformer qui identifie les modèles d'embeddings par empreinte numérique en lisant des chiffres bruts. Sans ingénierie de caractéristiques.
février 19, 2026 • 7 minutes lues
jina-embeddings-v5-text : Nouveaux Embeddings multilingues de petite taille SOTA
Deux modèles de plongements (embeddings) multilingues de moins de 1 milliard de paramètres offrant des performances de premier ordre, disponibles sur Elastic Inference Service, Llama.cpp et MLX.
décembre 04, 2025 • 7 minutes lues
Jina-VLM : Petit modèle de langage visuel multilingue
Nouveau modèle de langage de vision 2B atteint SOTA sur VQA multilingue, sans oubli catastrophique sur les tâches textuelles uniquement.
octobre 03, 2025 • 7 minutes lues
Jina Reranker v3 : 重排器 Listwise de 0,6B pour une récupération multilingue SOTA
Nouveau réorganisateur listwise de 0,6 milliard de paramètres qui prend en compte la requête et tous les documents candidats dans une seule fenêtre contextuelle.
septembre 09, 2025 • 11 minutes lues
Les Embeddings multimodaux dans Llama.cpp et GGUF
Nous avons intégré les 向量模型 multimodaux à llama.cpp et GGUF, et découvert quelques problèmes surprenants en cours de route.
septembre 04, 2025 • 6 minutes lues

Jina Code Embeddings : Recherche de code SOTA à 0,5B et 1,5B
Génération de LLM de code → Vecteurs modèles de code : les modèles 0.5B/1.5B atteignent une performance SOTA sur 25 benchmarks de récupération de code.