


Reader
Convertissez une URL en entrée compatible avec LLM en ajoutant
r.jina.ai au début.API Reader
Convertissez une URL en entrée compatible avec LLM en ajoutant
r.jina.ai au début.globe_book
Utilisez
r.jina.ai pour lire une URL et récupérer son contenutravel_explore
Utilisez
s.jina.ai pour rechercher sur le Web et obtenir le SERP
Ajoutez
mcp.jina.ai comme serveur MCP pour appeler nos API depuis n'importe quel LLMcurl "https://r.jina.ai/https://www.example.com"jina-ocr-v1 : analyse de documents plus rapide sur des GPU économiques
Un analyseur de documents à mélange d'experts, de 3,4B paramètres, dont seulement 570M sont actifs par token. Il lit une image de page et restitue, en un seul passage, du Markdown avec texte, formules, tableaux et ordre de lecture.
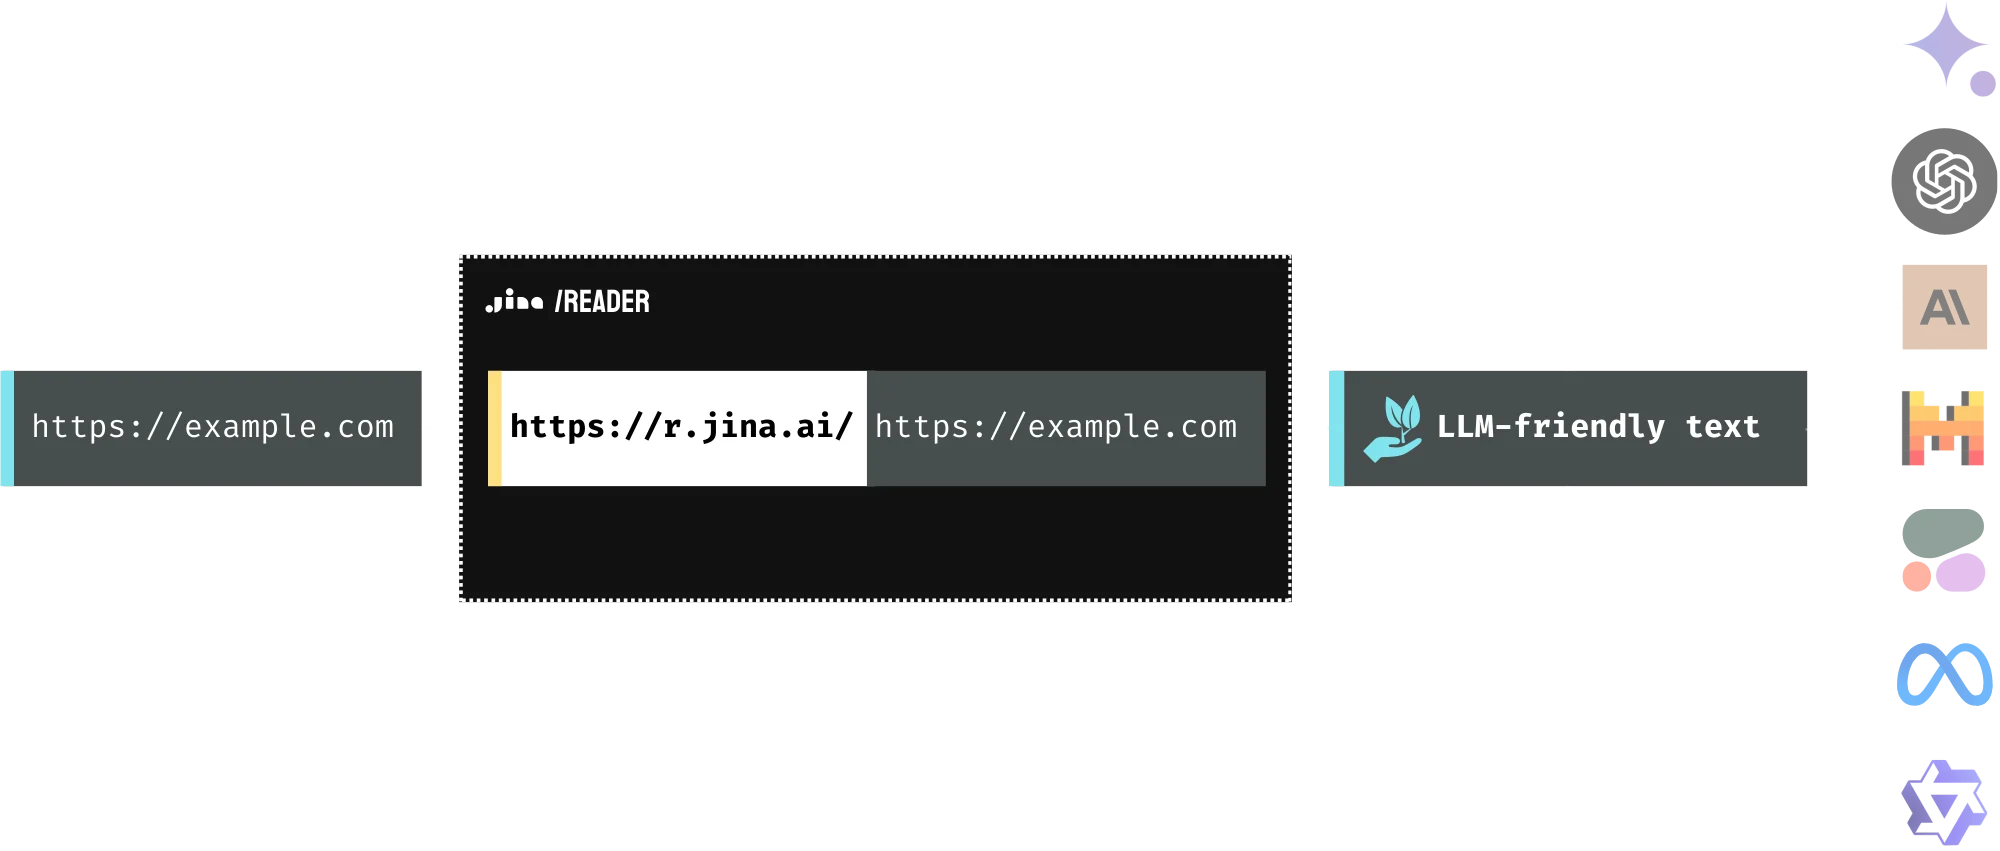
Alimenter les LLM en informations web est une étape importante du grounding, mais elle peut s'avérer délicate. La méthode la plus simple consiste à extraire le code HTML brut de la page web, puis à l'injecter dans le modèle. Cependant, cette opération peut être complexe et souvent bloquée, et le code HTML brut est encombré d'éléments superflus tels que des balises et des scripts. L'API Reader résout ces problèmes en extrayant le contenu principal d'une URL et en le convertissant en un texte propre et compatible avec les LLM, garantissant ainsi des données de haute qualité pour vos systèmes d'agents et RAG. L'API Reader est une infrastructure de développement : elle convertit une URL que vous fournissez en un texte compatible avec les LLM afin que vous puissiez créer vos propres systèmes de recherche, RAG et d'agents. Ce n'est pas un moteur de recherche grand public : elle n'indexe ni ne classe le web pour vous ; vous contrôlez les URL traitées et êtes responsable de l'utilisation des résultats.
HTML brut
Sortie du Reader
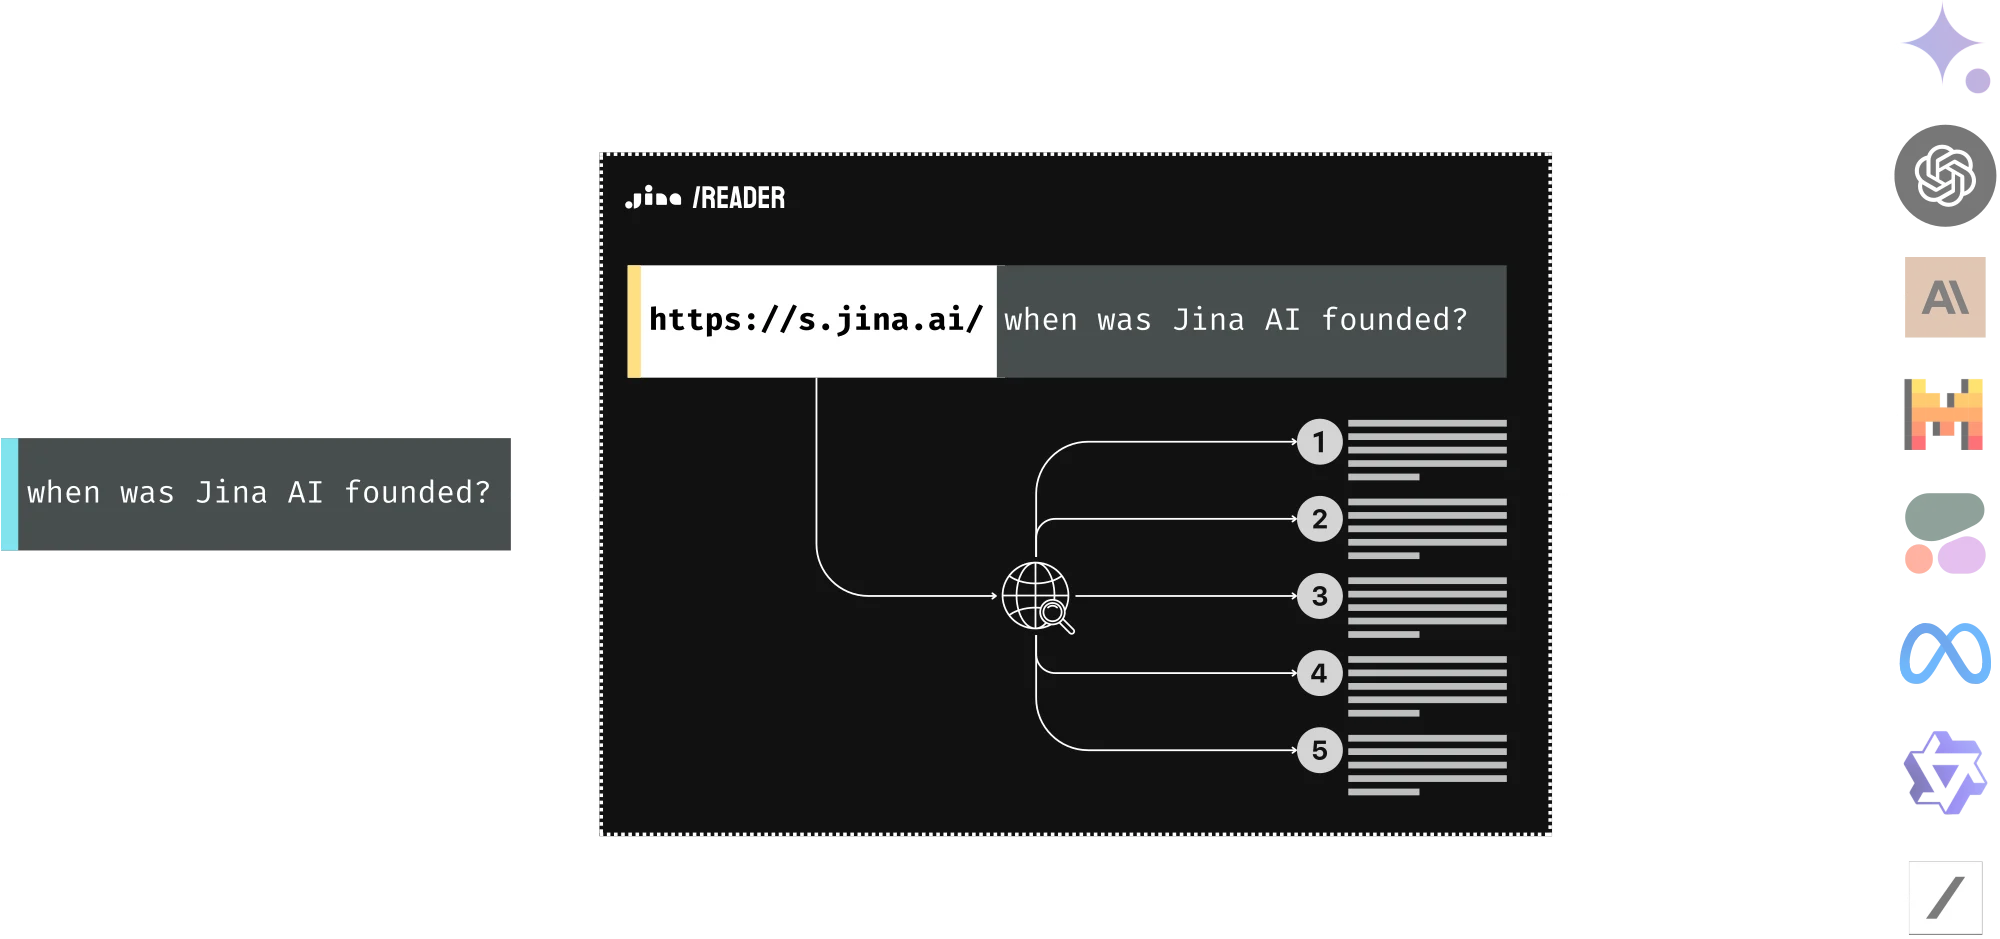
Reader peut être utilisé comme API SERP. Il vous permet d'alimenter votre LLM avec le contenu derrière la page des résultats du moteur de recherche. Faites précéder votre requête de
https://s.jina.ai/?q= : Reader effectuera une recherche sur le Web et renverra les cinq premiers résultats avec leurs URL et leur contenu, le tout dans un texte clair et adapté au LLM. De cette façon, vous pouvez toujours maintenir votre LLM à jour, améliorer sa factualité et réduire les hallucinations.info À noter que, contrairement à la démo présentée ci-dessus, en pratique vous ne recherchez pas la question d'origine sur le Web pour le grounding. Le plus souvent, on réécrit la question d'origine ou l'on utilise des questions à plusieurs sauts. On lit les résultats récupérés, puis on génère des requêtes supplémentaires pour recueillir plus d'informations si nécessaire avant d'arriver à une réponse finale.
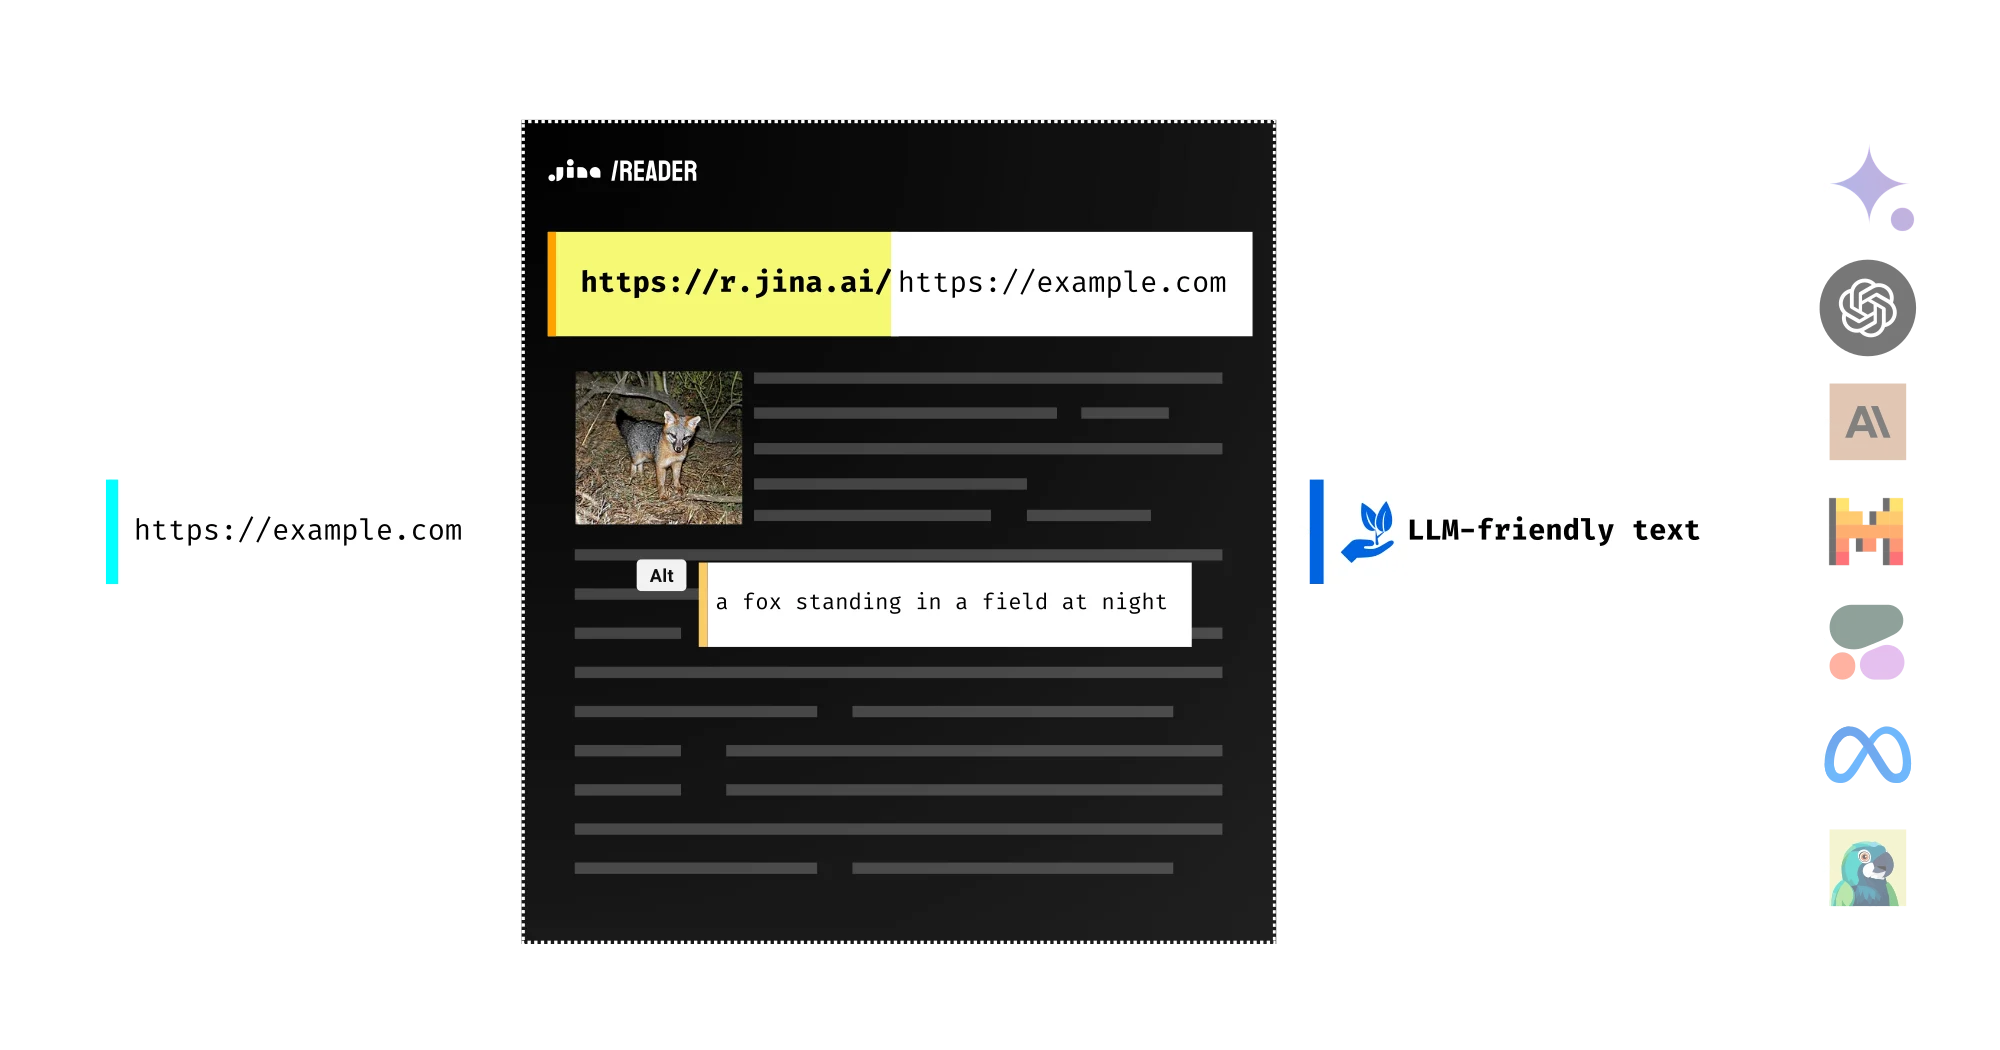
Les images de la page Web sont automatiquement légendées à l'aide d'un modèle de vision-langage dans le Reader, puis représentées par des balises alt d'image dans la sortie. Cela donne à votre LLM en aval juste assez d'indices pour intégrer ces images dans ses processus de raisonnement et de synthèse. Cela signifie que vous pouvez poser des questions sur les images, en sélectionner des spécifiques ou même transmettre leurs URL à un VLM plus puissant pour une analyse plus approfondie !
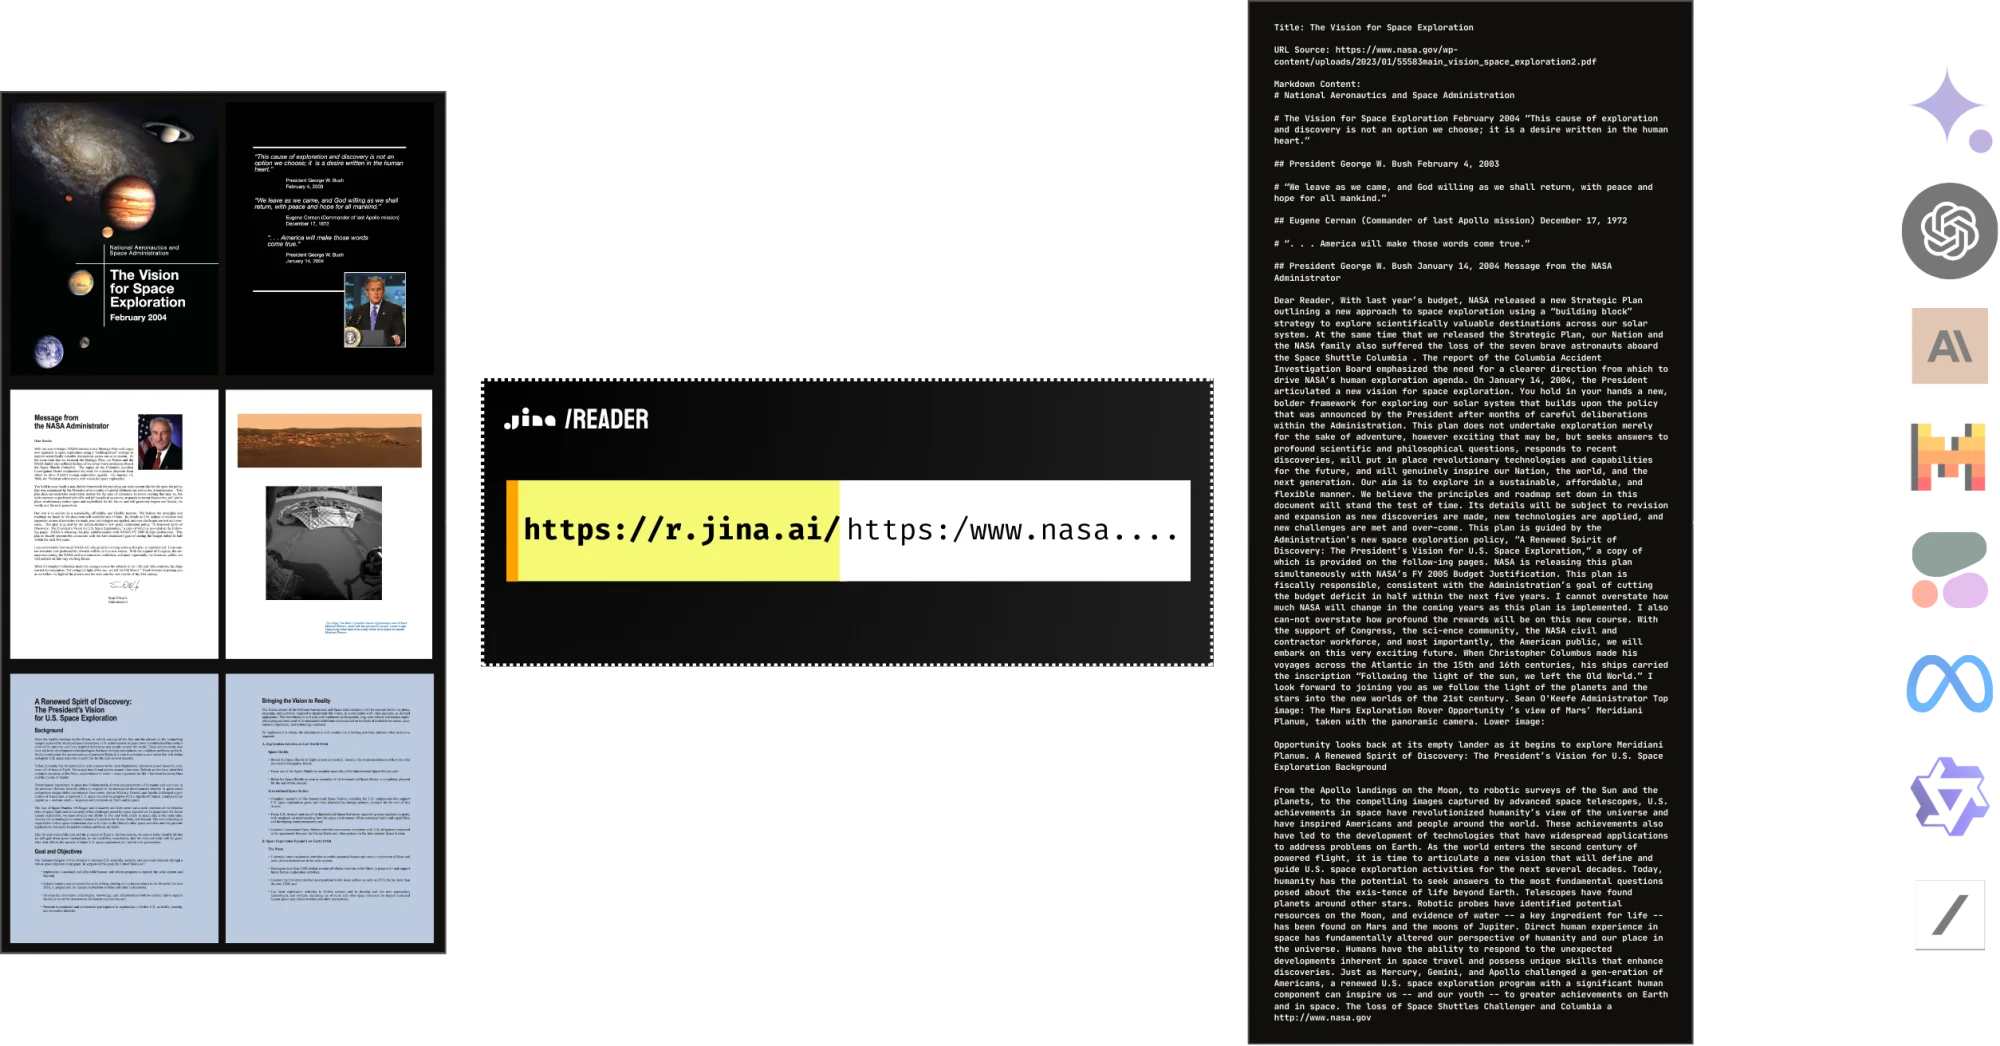
Oui, Reader prend en charge nativement la lecture de PDF. Il est compatible avec la plupart des PDF, y compris ceux contenant de nombreuses images, et il est ultra-rapide ! En combinaison avec un LLM, vous pouvez facilement créer une IA ChatPDF ou d'analyse de documents en un rien de temps.
Le meilleur ? C'est gratuit !
L'API Reader est disponible gratuitement et offre une limite de débit et une tarification flexibles. Construite sur une infrastructure évolutive, elle offre une grande accessibilité, un traitement fortement concurrent et une fiabilité élevée. Nous nous efforçons d'être votre solution de Grounding préférée pour vos LLM.
Limite de débit
Les limites de débit sont suivies de deux manières : RPM (requêtes par minute) et TPM (tokens par minute). Les limites sont appliquées par IP ou clé API et se déclenchent dès que l'un des deux seuils, RPM ou TPM, est atteint. Lorsque vous fournissez une clé API dans l'en-tête de la requête, nous suivons les limites de débit par clé plutôt que par adresse IP.
| Produit | Point de terminaison de l'API | Descriptionarrow_upward | Sans clé APIkey_off | Avec clé API gratuitekey | Avec clé API payantekey | Avec clé API Premiumkey | Latence moyenne | Comptage de l'utilisation des tokens | Méthode HTTP | |
|---|---|---|---|---|---|---|---|---|---|---|
| API Reader | https://r.jina.ai | Convertir l'URL en texte compatible LLM | 20 RPM | 500 RPM | 500 RPM | trending_up5000 RPM | 7.9s | Compter le nombre de tokens dans la réponse de sortie. | GET/POST | |
| API Reader | https://s.jina.ai | Rechercher sur le web et convertir les résultats en texte compatible LLM | block | 100 RPM | 100 RPM | trending_up1000 RPM | 2.5s | Chaque demande coûte un nombre fixe de tokens, à partir de 10 000 tokens | GET/POST | |
| API Embeddings | https://api.jina.ai/v1/embeddings | Convertir du texte/des images en vecteurs de longueur fixe | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart dépend de la taille de l'entrée help | Compter le nombre de tokens dans la demande d'entrée. | POST | |
| API Reranker | https://api.jina.ai/v1/rerank | Classer les documents selon la requête | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart dépend de la taille de l'entrée help | Compter le nombre de tokens dans la demande d'entrée. | POST |


Pas de panique ! Chaque nouvelle clé API inclut 10 millions de tokens gratuits !
Tarification de l'API
La tarification de l'API repose sur l'utilisation des tokens. Une seule clé API vous donne accès à tous les produits Search Foundation.

Avec l'API Jina Search Foundation
Le moyen le plus simple d'accéder à tous nos produits. Rechargez vos tokens au fur et à mesure.
key
verified_user
Rechargez cette clé API avec plus de tokens
Veuillez saisir la clé API correcte pour recharger.
speed
Comprendre la limite de débit
Les limites de débit plafonnent le nombre de requêtes (RPM) et de tokens (TPM) envoyés à une API par minute et par adresse IP ou clé API. Retrouvez le détail des limites par produit et par palier ci-dessous.
keyboard_arrow_down

Quels sont les coûts associés à l’utilisation de l’API Reader ?
keyboard_arrow_down
Comment fonctionne l'API Reader ?
keyboard_arrow_down
L'API Reader est-elle open source ?
keyboard_arrow_down
Quelle est la latence typique de l’API Reader ?
keyboard_arrow_down
Pourquoi utiliser l'API Reader plutôt que de scraper la page moi-même ?
keyboard_arrow_down
L'API Reader prend-elle en charge plusieurs langues ?
keyboard_arrow_down
L'API Reader respecte-t-elle les contrôles d'accès des sites web ?
keyboard_arrow_down
L'API Reader peut-elle extraire le contenu des fichiers PDF ?
keyboard_arrow_down
L'API Reader peut-elle traiter le contenu multimédia des pages Web ?
keyboard_arrow_down
Est-il possible d'utiliser l'API Reader sur des fichiers HTML locaux ?
keyboard_arrow_down
L'API Reader met-elle en cache le contenu ?
keyboard_arrow_down
Puis-je utiliser l'API Reader pour accéder au contenu derrière une authentification ?
keyboard_arrow_down
Puis-je utiliser l'API Reader pour accéder au PDF sur arXiv ?
keyboard_arrow_down
Comment fonctionne la légende d’image dans Reader ?
keyboard_arrow_down
Quelle est l’évolutivité du Reader ? Puis-je l’utiliser en production ?
keyboard_arrow_down
Quelle est la limite de débit de l’API Reader ?
keyboard_arrow_down
Qu'est-ce que ReaderLM ? Comment puis-je l'utiliser ?
keyboard_arrow_down
Comment extraire des données structurées à partir de pages web ?
keyboard_arrow_down
Le Reader contourne-t-il activement la protection anti-robots des sites web ?
keyboard_arrow_down
Le passage d'une clé API gratuite à une clé payante me donnera-t-il accès à davantage de sites web ?
keyboard_arrow_down
Puis-je exécuter Reader au sein de ma propre infrastructure ?
keyboard_arrow_down
Limite de débit
Les limites de débit sont suivies de deux manières : RPM (requêtes par minute) et TPM (tokens par minute). Les limites sont appliquées par IP ou clé API et se déclenchent dès que l'un des deux seuils, RPM ou TPM, est atteint. Lorsque vous fournissez une clé API dans l'en-tête de la requête, nous suivons les limites de débit par clé plutôt que par adresse IP.
| Produit | Point de terminaison de l'API | Descriptionarrow_upward | Sans clé APIkey_off | Avec clé API gratuitekey | Avec clé API payantekey | Avec clé API Premiumkey | Latence moyenne | Comptage de l'utilisation des tokens | Méthode HTTP | |
|---|---|---|---|---|---|---|---|---|---|---|
| API Reader | https://r.jina.ai | Convertir l'URL en texte compatible LLM | 20 RPM | 500 RPM | 500 RPM | trending_up5000 RPM | 7.9s | Compter le nombre de tokens dans la réponse de sortie. | GET/POST | |
| API Reader | https://s.jina.ai | Rechercher sur le web et convertir les résultats en texte compatible LLM | block | 100 RPM | 100 RPM | trending_up1000 RPM | 2.5s | Chaque demande coûte un nombre fixe de tokens, à partir de 10 000 tokens | GET/POST | |
| API Embeddings | https://api.jina.ai/v1/embeddings | Convertir du texte/des images en vecteurs de longueur fixe | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart dépend de la taille de l'entrée help | Compter le nombre de tokens dans la demande d'entrée. | POST | |
| API Reranker | https://api.jina.ai/v1/rerank | Classer les documents selon la requête | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart dépend de la taille de l'entrée help | Compter le nombre de tokens dans la demande d'entrée. | POST |
Questions courantes liées à l'API
code
Puis-je utiliser la même clé API pour toutes les API Jina ?
keyboard_arrow_down
code
Puis-je surveiller l’utilisation des tokens de ma clé API ?
keyboard_arrow_down
code
Que dois-je faire si j'oublie ma clé API ?
keyboard_arrow_down
code
Les clés API expirent-elles ?
keyboard_arrow_down
code
Puis-je transférer des tokens entre des clés API ?
keyboard_arrow_down
code
Puis-je révoquer ma clé API ?
keyboard_arrow_down
code
Pourquoi la première requête de certains modèles est-elle lente ?
keyboard_arrow_down
code
Mes données API sont-elles utilisées pour entraîner vos modèles ?
keyboard_arrow_down
code
Quelles sont les limites de débit des API Jina ?
keyboard_arrow_down
code
Existe-t-il des limites de taille de lot pour les API ?
keyboard_arrow_down
code
Les API Jina sont-elles la même chose que les modèles Jina au sein d'Elastic ?
keyboard_arrow_down
Questions courantes liées à la facturation
attach_money
La facturation repose-t-elle sur le nombre de phrases ou de requêtes ?
keyboard_arrow_down
attach_money
Un essai gratuit est-il proposé aux nouveaux utilisateurs ?
keyboard_arrow_down
attach_money
Les tokens sont-ils facturés pour les requêtes ayant échoué ?
keyboard_arrow_down
attach_money
Quels moyens de paiement sont acceptés ?
keyboard_arrow_down
attach_money
Peut-on obtenir une facture pour les achats de tokens ?
keyboard_arrow_down
attach_money
Comment puis-je acheter une licence commerciale plutôt que des tokens API ?
keyboard_arrow_down
attach_money
Puis-je payer par facture ou bon de commande plutôt que par carte ?
keyboard_arrow_down
attach_money
J'ai payé, mais mon solde ou ma limite de débit n'a pas changé. Que dois-je vérifier ?
keyboard_arrow_down
attach_money
Comment puis-je annuler, arrêter le rechargement automatique ou supprimer un mode de paiement enregistré ?
keyboard_arrow_down
