Reader
LM-v2
 API del Reader
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-gapped
Panoramica
ReaderLM-v2 è un piccolo modello di linguaggio da 1,54B parametri che trasforma HTML disordinato in Markdown o JSON pulito con alta precisione, elaborando documenti fino a 512K token. È lo strumento ideale per il grounding degli LLM: convertire il contenuto web in formati strutturati che i LLM possano consumare in modo efficiente. Supera Qwen2.5-32B-Instruct e Gemini2-flash-expr nei task da HTML a Markdown, girando a una frazione del loro costo.
Metodi
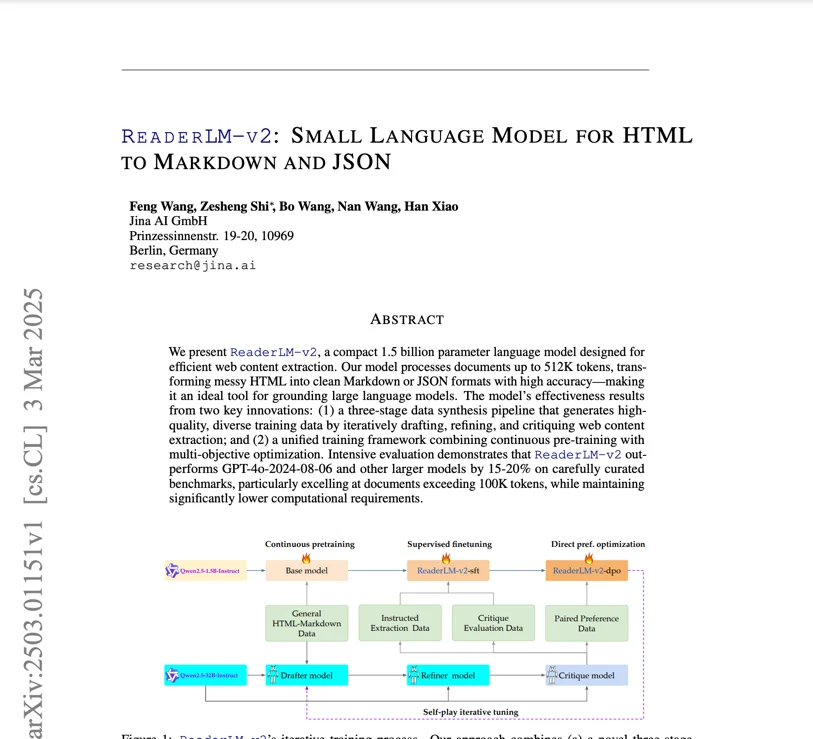
L'efficacia del modello deriva da due innovazioni chiave. In primo luogo, una pipeline di sintesi dei dati in tre fasi genera dati di addestramento di alta qualità e diversificati redigendo, rifinando e criticando in modo iterativo l'estrazione di contenuti web — questo approccio sintetico garantisce che il modello veda una vasta varietà di strutture HTML senza richiedere annotazione manuale. In secondo luogo, un framework di addestramento unificato combina il pre-addestramento continuo con l'ottimizzazione multi-obiettivo, consentendo al modello di imparare simultaneamente la conversione da HTML a Markdown e da HTML a JSON. L'architettura decoder-only 'shallow-but-wide' (28 layer, 1536 dimensioni nascoste, 12 query head, 2 KV head) è ottimizzata per le operazioni di copia selettiva. Il contesto di 512K token è reso possibile dal zigzag-ring-attention. L'addestramento con perdita contrastiva riduce significativamente i problemi di degenerazione.
Prestazioni
Nei task da HTML a Markdown, il modello raggiunge ROUGE-L 0,84, Jaro-Winkler 0,82 e una distanza di Levenshtein di 0,22, superando Qwen2.5-32B-Instruct e Gemini2-flash-expr. Nei task da HTML a JSON mantiene prestazioni competitive, con F1 di 0,81 e il 98% di pass rate. Su una GPU T4 elabora 67 token/s in input e 36 token/s in output. L'addestramento con perdita contrastiva riduce significativamente i problemi di degenerazione (loop di token, output ripetitivo). La finestra di contesto di 512K token elimina la necessità di chunking sulla maggior parte dei documenti reali.
Buone pratiche
Il modello è accessibile tramite un notebook Google Colab che dimostra la conversione da HTML a Markdown, l'estrazione JSON e l'instruction-following. Per i task da HTML a Markdown, inserisci HTML grezzo senza istruzioni di prefisso. Per l'estrazione JSON, specifica lo schema target nel prompt. La funzione helper create_prompt facilita la creazione di prompt per entrambi i task. Il modello funziona sul livello gratuito T4 GPU di Colab (richiede vllm e triton) ma ha limiti senza supporto bfloat16 o Flash Attention 2; per la produzione è consigliata la RTX 3090/4090. Disponibile su AWS SageMaker, Azure e marketplace GCP. Concesso in licenza sotto CC BY-NC 4.0 per uso non commerciale. Usa questo modello come passo di pre-elaborazione nelle pipeline RAG per convertire i contenuti web in Markdown pulito prima dell'embedding con jina-embeddings-v5-text-small.