Embeddings
 Licenza Apache 2.0
jina-clip-v1
Apache-2.0 API di Jina
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 Air-gapped
Panoramica
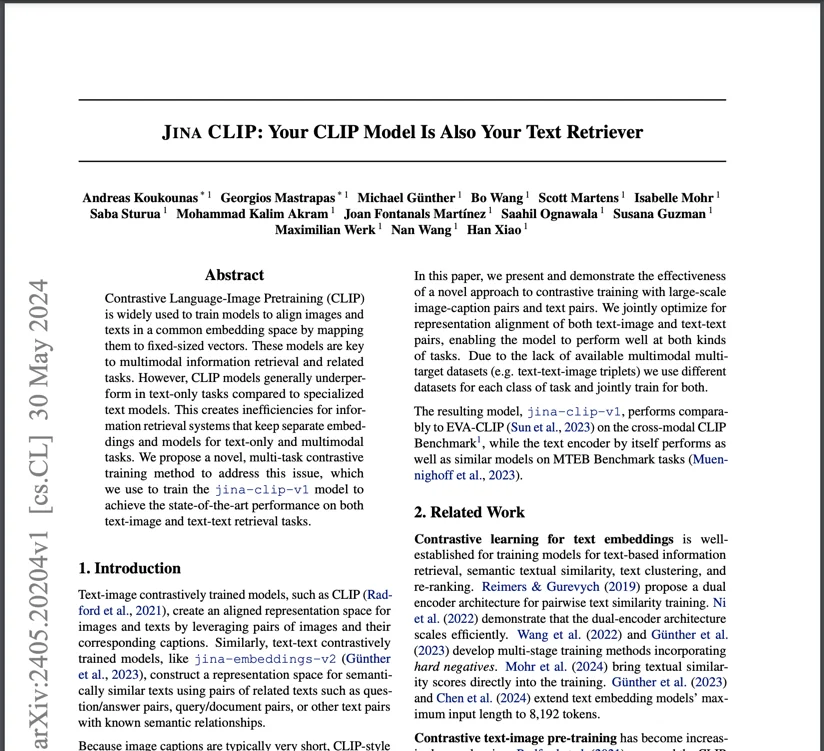
jina-clip-v1 è un modello di embedding multimodale da 223M parametri che raggiunge prestazioni state-of-the-art sia nella retrieval testo-testo che testo-immagine — un primato nella famiglia CLIP. A differenza dei modelli CLIP standard, che sacrificano la retrieval solo testo per l'allineamento cross-modale, jina-clip-v1 usa l'addestramento contrastivo multi-task per mantenere prestazioni forti su tutte le combinazioni di retrieval. Supporta un contesto testuale di 12.288 token, circa 160× il limite di 77 token del CLIP originale.
Metodi
L'architettura combina un encoder testuale Jina BERT v2 adattato (12.288 token grazie ad ALiBi) con l'encoder di immagine EVA-02 della Beijing Academy for AI. L'innovazione chiave è il metodo di addestramento contrastivo multi-task: il modello viene addestrato simultaneamente su (1) coppie immagine-descrizione per l'allineamento cross-modale, (2) coppie testo-testo per preservare la qualità della retrieval solo testo e (3) descrizioni testuali più lunghe delle immagini generate da IA per migliorare la robustezza a diverse lunghezze di testo. Una fase finale usa tripletti di testo con negativi difficili per affinare la distinzione semantica. Questo approccio multi-task previene l'oblio catastrofico della retrieval solo testo che affligge l'addestramento CLIP standard. L'encoder di immagine elabora tile di 224×224 pixel, con ogni tile che consuma 1.000 token di capacità di elaborazione.
Prestazioni
Nella retrieval solo testo, il modello raggiunge un aumento di prestazioni del 165% rispetto ad OpenAI CLIP (0,429 contro 0,162 su MTEB). Per i task di immagine: 2% in più nella retrieval testo-immagine (0,899), 6% nella retrieval immagine-testo (0,803) e 12% in quella immagine-immagine (0,916). Nella classificazione visiva zero-shot (CIFAR-100) supera il CLIP standard. Le prestazioni cross-modali su Flickr8k/30k e MSCOCO Captions sono competitive con quelle di modelli unimodali specializzati. Il contesto testuale di 12.288 token è un grande vantaggio per la retrieval di documenti testuali lunghi affiancati a immagini. Nel 2026, jina-clip-v2 rimpiazza questo modello con supporto a 89 lingue ed elaborazione di immagini 512×512.
Buone pratiche
Il modello elabora le immagini in tile di 224×224 pixel; ogni tile consuma 1.000 token. Un'immagine di 750×500 pixel richiede 12 tile (12.000 token). Il testo richiede circa 1,1 token per parola. Pianifica i budget di token di conseguenza per query multimodali. Il modello supporta attualmente solo l'inglese — per applicazioni multilingue usa jina-clip-v2. È disponibile tramite la Jina Embeddings API e come release open source su Hugging Face con licenza Apache 2.0. Per ambienti di produzione, le opzioni di deploy su AWS Marketplace e Azure offrono infrastruttura ottimizzata. Usa la similarità coseno per il confronto cross-modale. Per nuovi progetti multimodali, preferisci jina-clip-v2 (89 lingue, immagini 512×512, supporto MRL) o jina-embeddings-v4 (contesto 32K, modalità multi-vettore, supporto codice).