Elastic
Jina AI
Modelli
API
keyboard_arrow_down
Reader
Converti qualsiasi URL in Markdown per un migliore ancoraggio dei LLM.
Embeddings
Embeddings multimodali e multilingue.
Reranker
Reranker per massimizzare la pertinenza dei risultati di ricerca.
MCP
terminal
CLI
article
llms.txt
smart_toy
Agenti
data_object
Schema
menu_book
Documenti
Login
login
Embeddings
copyright CC BY-NC 4.0
open_in_new Post di rilascio

jina-code-embeddings-0.5b

Embeddings di codice efficienti da modelli di generazione di codice
Licenza
copyright CC-BY-NC-4.0
Data di rilascio
calendar_month
2025-09-01
Ingresso
abc
Testo (codice)
arrow_forward
Produzione
more_horiz
Vettore
Dimensioni Matryoshka help_outline
64
128
256
512
896
Dettagli del modello
Parametri: 494M
Lunghezza del token di input: 32K
Dimensione di uscita: 896
Modello base help_outline
open_in_new
Qwen2.5-Coder-0.5B
Lingue addestrate help_outline
1 lingue
Lingue supportate help_outline
29 lingue
Quantizzazioni help_outline
GGUF
Modelli correlati
link
jina-code-embeddings-1.5b
link
jina-embeddings-v2-base-code
Attività supportate
translate NL→Codice
help_center Q&A tecnico
sync_alt Codice→Codice
description Codice→NL
auto_fix_high Completamento
Disponibile tramite
API di Jina
AWS SageMaker
Microsoft Azure
Google Cloud
Hugging Face
Air-gapped
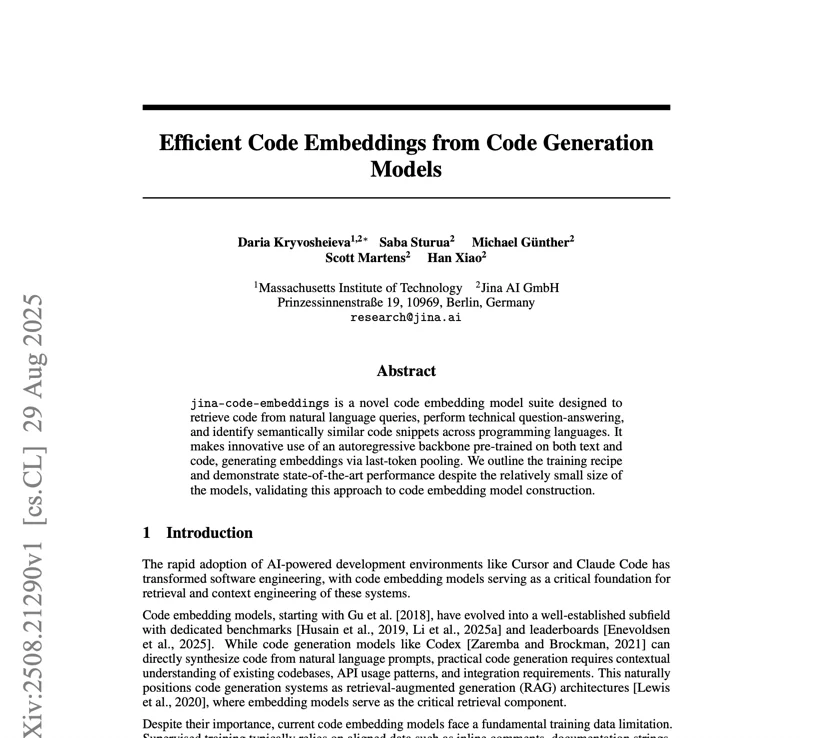
Grafico I/O

Codice

jina-code-embeddings

Attività

Vettore

Frontiera di Pareto help_outline
workspace_premium
CoIR
MTEB Code
chevron_leftchevron_right
30M100M300M1B3.0B10B40506070bge-base-en-v1.5bge-m3bge-small-en-v1.5CodeRankEmbedCodeSage-baseCodeSage-largeCodeSage-large-v2CodeSage-smallCodeXEmbed-7BContrievere5-base-v2e5-mistral-7b-instructe5-small-v2granite-embedding-engli…granite-embedding-small…gte-base-en-v1.5gte-modernbert-basegte-Qwen2-1.5B-instructjina-embeddings-v3jina-embeddings-v4modernbert-embed-baseNV-Embed-v2SFR-Embedding-2_RSFR-Embedding-Code-2B_RSFR-Embedding-Code-400M…snowflake-arctic-embed-…UniXcoderjina-code-embeddings-0.…Parametri (log)nDCG@10
Questo modello
Sulla frontiera
Jina AI
Altri
CoIR
73.94
Parametri
494M
Classifica per punteggio
1 / 31
Frontiera di Pareto
Sulla
Distribuzione dei valorihelp_outline
AUC 0.8538
Corpus
Coppie di traduzione
Ricerca documentale
Codice
Attività
nl2code.passage
nl2code.query
nl2code.query → nl2code.passage
qa.passage
qa.query
qa.query → qa.passage
0.7330.000.200.400.600.80
Correlate18.5%
Negativo difficile2.3%
Non correlate1.1%
Soglie consigliate
FPR 0.1 · 0.544
FPR 0.01 · 0.733
FPR 0.001 · 0.813
FPR 0.0001 · 0.889
bilanciata · 0.427
AUC
0.8538
Soglia del rumore
0.809
Crollo del richiamo
0.160
Coppie misurate
119 / 11k
Componenti del vettorehelp_outline
-0.210.010.23
σ 0.0334 · 213k valori
Geometria dell'embeddinghelp_outline
0896
Media per dimensione, passa il cursore per l'intervallo
Rumore di fondo
0.329
Dim. effettive
55 / 896
Scegli i modelli da confrontare
Pubblicazioni (1)
NeurIPS 2025
agosto 31, 2025
Efficient Code Embeddings from Code Generation Models

Panoramica

jina-code-embeddings-0.5b è un modello di embedding del codice da 494M parametri che mappa il codice di programmazione e le query in linguaggio naturale in uno spazio semantico condiviso di 896 dimensioni. Supporta finestre di contesto di 32K token, abilitando la retrieval di intere funzioni e di più file, e usa l'apprendimento delle rappresentazioni Matryoshka per una dimensionalità flessibile (64–896). Raggiunge prestazioni state-of-the-art nella retrieval del codice per la sua dimensione, superando modelli con 3 volte i parametri.

Metodi

Il modello è basato su un backbone transformer autoregressivo pre-addestrato su corpora di linguaggio naturale e codice. Invece del pooling bidirezionale usato dai modelli di embedding tradizionali, estrae gli embedding tramite Last-Token-Pooling dalla posizione finale della sequenza. Questo è un insight architettonico chiave: l'attenzione causale del modello autoregressivo si concentra naturalmente sull'intero contesto di input, e l'obiettivo di pre-addestramento per la generazione di codice produce rappresentazioni semantiche ricche che si trasferiscono bene alla retrieval. L'addestramento usa una ricetta in due fasi: (1) pre-addestramento contrastivo su coppie codice-testo su larga scala (descrizioni in linguaggio naturale abbinate a implementazioni di codice) e (2) fine-tuning supervisionato su dataset di retrieval del codice curati, con mining di negativi difficili. La lunghezza di contesto di 32K è abilitata tramite embedding posizionali rotazionali con frequenza di base calibrata.

Prestazione

Il modello raggiunge una media generale del 78,41% e una media MTEB Code del 78,72% sui benchmark standard di retrieval del codice. Punteggi degni di nota: 96,77% su HumanEval, 89,01% su MBPP, 98,31% su WikiSQL, 99,70% su CodeChefXLang, 90,37% su CodeTransOceanContest (codice-a-codice), 85,73% su COIR-CodeSearchNet (NL2Code), 95,98% su Doc2Code e 91,04% su StackOverflowQA. Supera Qwen3-Embedding-0,6B e modelli più grandi, inclusi jina-embeddings-v4 (74,11%) e gemini-embedding-001 (77,38%), nei task specifici del codice. Con 494M parametri, supera diversi modelli da 3 a 5 volte la sua dimensione, dimostrando che l'approccio a backbone autoregressivo offre un'alta qualità semantica per parametro.

Orientamento

Usa sempre i prefissi di istruzione specifici per il task appropriati: nl2code per la ricerca da linguaggio naturale a codice, code2code per la similarità codice-a-codice, code2nl per codice-a-linguaggio-naturale, techqa per le Q&A tecniche e code2completion per la completazione del codice. Per codebase grandi, implementa il chunking ai confini di funzione o di classe per restare entro il limite di 32K token. La troncatura Matryoshka a 128 o 256 dimensioni è adatta all'indicizzazione ad alto throughput; usa le 896 dimensioni complete per il re-ranking dei candidati principali. Usa la similarità coseno per il confronto degli embedding. La batch size ottimale è 512, la lunghezza di sequenza 512 token. Il modello è ottimizzato per Python, JavaScript, Java, PHP, Go e Ruby ma supporta 30+ lingue. Per pipeline RAG sul codice, abbina jina-reranker-v3.5 come seconda fase per massimizzare la precisione sui top-50 candidati.

Blog che menzionano questo modello
ottobre 03, 2025 • 7 minuti letti
Jina Reranker v3: Reranker Listwise da 0.6B per il recupero multilingue SOTA
Nuovo *reranker* *listwise* da 0.6 miliardi di parametri che considera la query e tutti i documenti candidati in una singola finestra di contesto.
Jina AI
Light blue background with stylized text in the center, composed of small dots or squares, evoking a modern and minimalistic
settembre 04, 2025 • 6 minuti letti
Jina Code Embeddings: Recupero di codice SOTA a 0,5B e 1,5B
LLM per la generazione di codice → Embeddings di codice: i modelli da 0,5B/1,5B raggiungono prestazioni SOTA su 25 benchmark di recupero del codice.
Jina AI
Green "Code Embeddings" text displayed in a LED dot style on a black background, evoking a futuristic and technological atmos
Lingua / tema attuale
Search Foundation
Reader
Embeddings
Reranker
Ottieni la chiave API Jina
Limite di velocità
Chi siamo
Notizie
Scarica il logo Jina
open_in_new
Scarica il logo Elastic
open_in_new
Stato dell'API
Elastic © 2026.SicurezzaTermini & CondizioniPrivacyGestisci i cookieNon vendere né condividere le mie informazioni personali
Questo sito web e tutti i contenuti, software, prodotti e servizi ad esso associati sono destinati esclusivamente all'uso professionale. Non è previsto né raccomandato alcun utilizzo da parte dei consumatori.