Embeddings
jina-embeddings-v5-omni-small
 GGUF
 MLX
 Elastic Inference Service
 API di Jina
 AWS SageMaker
 Hugging Face
 MacOS
 Air-gapped
Panoramica
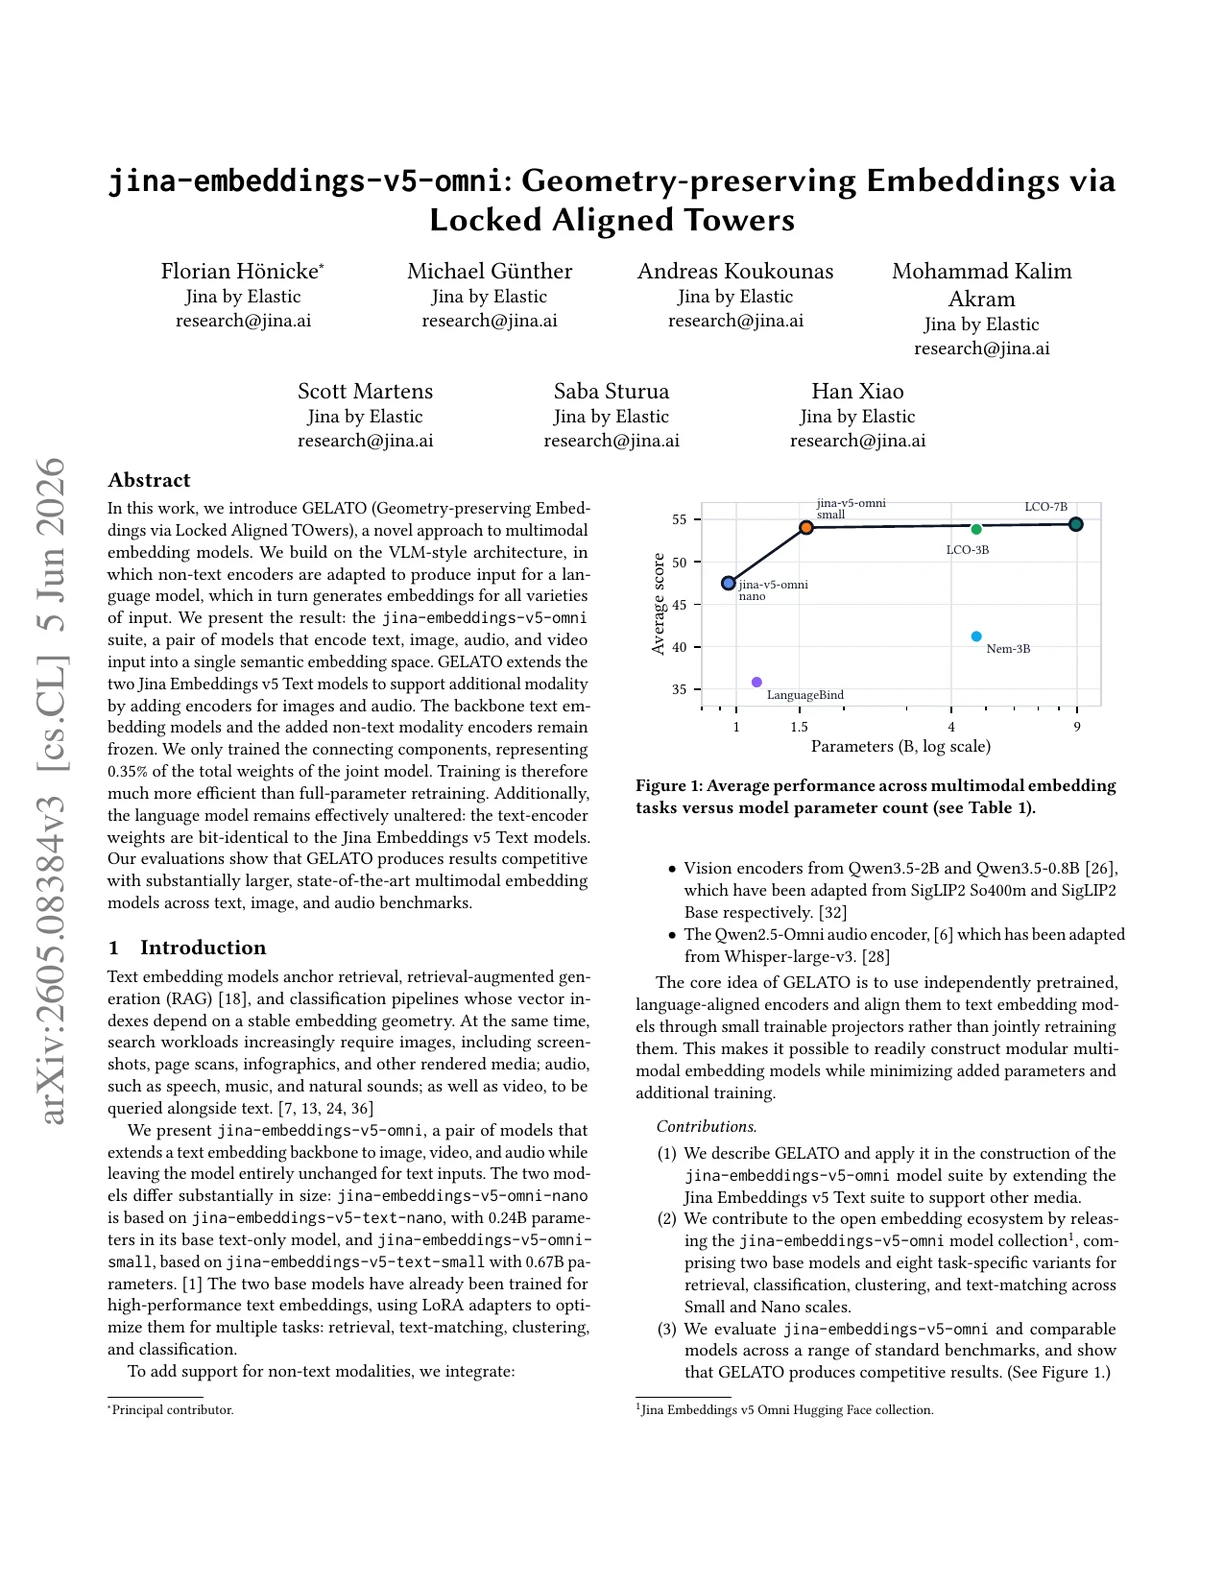
jina-embeddings-v5-omni-small è un modello di embedding multimodale di circa 1,74B parametri che accetta testo, immagini, video, audio e PDF, producendo embedding in uno spazio vettoriale condiviso di 1024 dimensioni. È il modello di embedding predefinito dell'API Jina e offre il miglior compromesso accuratezza-efficienza tra i modelli di embedding multimodali di Jina. Le uscite solo testo sono bit-identiche a jina-embeddings-v5-text-small, abilitando una migrazione senza interruzioni da testo solo a multimodale senza reindicizzazione.
Metodi
Il modello viene addestrato in una terza fase che estende jina-embeddings-v5-text-small. Durante l'addestramento multimodale, il backbone testuale Qwen3-0,6B-Base e i quattro adattatori LoRA specifici per il task vengono congelati; vengono addestrati solo i proiettori cross-modale. Un vision encoder SigLIP2 Large gestisce immagini e video (32 frame campionati uniformemente per video). Un audio encoder Whisper-large-v3 gestisce l'input audio. Le pagine PDF vengono rese come immagini ed elaborate tramite il percorso visivo. L'addestramento usa una perdita contrastiva con negative cross-modali dure per allineare le rappresentazioni visive e audio con lo spazio di embedding testuale esistente. L'output di 1024 dimensioni supporta il troncamento Matryoshka fino a 32 dimensioni. La finestra di contesto di 32K token copre l'input testuale. Il modello supporta inferenza quantizzata e MLX per Apple Silicon.
Prestazione
Le performance solo testo sono bit-identiche a jina-embeddings-v5-text-small (67,0 di media MMTEB a livello task, 71,7 MTEB in inglese) — il backbone testuale e gli adattatori LoRA restano intatti durante l'addestramento multimodale. Nel retrieval cross-modale, il modello dimostra un forte allineamento sui task text-image, text-audio e text-video. Il retrieval delle pagine PDF è gestito tramite il percorso visivo. Il modello omni-small offre il miglior compromesso accuratezza-efficienza tra i modelli di embedding multimodali di Jina per il deployment su server, con embedding di 1024 dimensioni che offrono più potere discriminatorio rispetto alla variante omni-nano a 768 dimensioni.
Orientamento
Seleziona l'adattatore LoRA appropriato: retrieval, text-matching, clustering o classification. Per gli input multimodali via API, passa direttamente URL di immagini, URL di file audio, URL di file video o URL di PDF — il modello instrada ciascuna modalità tramite l'encoder appropriato. I formati audio supportati includono WAV, MP3, FLAC, OGG, M4A e Opus. Gli input video vengono elaborati come 32 frame campionati uniformemente. Mescola le modalità liberamente all'interno di un singolo batch: lo spazio di embedding è condiviso tra tutte le modalità. Usa la similarità coseno per il confronto. Il troncamento Matryoshka da 1024 a 32 dimensioni è supportato. Gli embedding solo testo sono compatibili drop-in con jina-embeddings-v5-text-small — nessuna reindicizzazione è necessaria al passaggio alla versione superiore. Per deployment edge senza GPU, usa invece jina-embeddings-v5-omni-nano.