Elastic
Jina AI
Modelli
API
keyboard_arrow_down
Reader
Converti qualsiasi URL in Markdown per un migliore ancoraggio dei LLM.
Embeddings
Embeddings multimodali e multilingue.
Reranker
Reranker per massimizzare la pertinenza dei risultati di ricerca.
MCP
terminal
CLI
article
llms.txt
smart_toy
Agenti
data_object
Schema
menu_book
Documenti
Login
login
Embeddings
copyright CC BY-NC 4.0
open_in_new Post di rilascio

jina-embeddings-v5-text-nano

Embeddings multilingue SOTA per l'implementazione edge
Licenza
copyright CC-BY-NC-4.0
Data di rilascio
calendar_month
2026-02-18
Ingresso
abc
Testo
arrow_forward
Produzione
more_horiz
Vettore
Dimensioni Matryoshka help_outline
32
64
128
256
512
768
Dettagli del modello
Parametri: 239M
Lunghezza del token di input: 8K
Dimensione di uscita: 768
Modello base help_outline
open_in_new
EuroBERT-210M
Lingue addestrate help_outline
32 lingue
Lingue supportate help_outline
108 lingue
Quantizzazioni help_outline
GGUF
Supporto Apple Silicon help_outline
MLX
Modelli correlati
link
jina-embeddings-v3
link
jina-embeddings-v5-text-small
Attività supportate
search Recupero
compare_arrows Corrispondenza del testo
bubble_chart Raggruppamento
label Classificazione
Disponibile tramite
Elastic Inference Service
API di Jina
AWS SageMaker
Hugging Face
Air-gapped
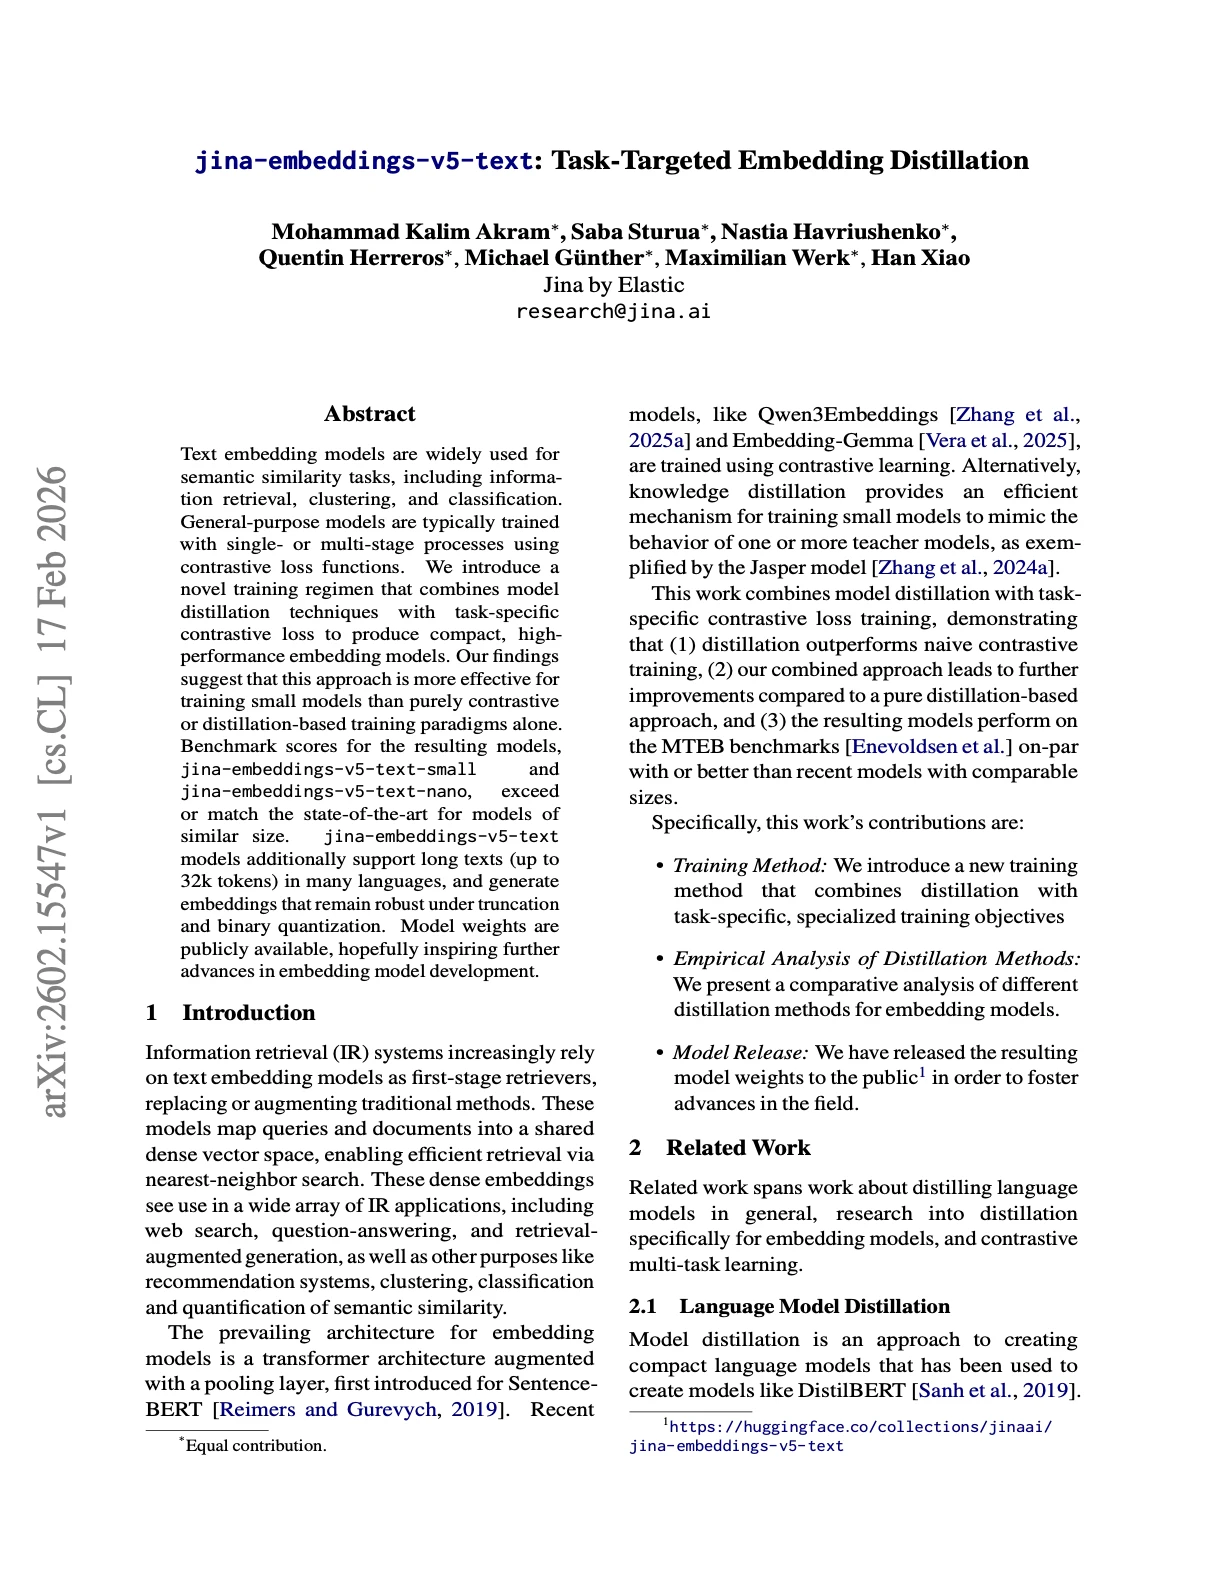
Grafico I/O

Testo

jina-embeddings-v5-text-nano

Attività

Vettore

Frontiera di Pareto help_outline
workspace_premium
MMTEB
MIRACL
RTEB public
LongEmbed
MTEB English · retrieval
chevron_leftchevron_right
30M100M300M1B3.0B10B30B3040506070all-MiniLM-L6-v2bge-large-en-v1.5e5-large-v2e5-small-v2EmbeddingGemma-300Mgranite-embedding-311m-…granite-embedding-97m-m…GritLM-7BGritLM-8x7Bgte-Qwen2-7B-instructharrier-oss-v1-0.6bharrier-oss-v1-27bjina-embeddings-v3jina-embeddings-v5-omni…KaLM-Embedding-Gemma3-1…LaBSELanguageBindLCO-Embedding-Omni-3Bllama-embed-nemotron-8bmultilingual-e5-basemultilingual-e5-large-i…Omni-Embed-Nemotron-3Bpotion-multilingual-128MQwen3-Embedding-0.6BQwen3-Embedding-4BQwen3-Embedding-8Bsnowflake-arctic-embed-…static-similarity-mrl-m…stella_en_1.5B_v5stella_en_400M_v5jina-embeddings-v5-text…Parametri (log)score
Questo modello
Sulla frontiera
Jina AI
Altri
MMTEB
65.50
Parametri
212M
Classifica per punteggio
12 / 48
Frontiera di Pareto
Sulla
Distribuzione dei valorihelp_outline
AUC 0.8242
Corpus
Coppie di traduzione
Ricerca documentale
Codice
Immagine / banner
Immagine / logo
Attività
classification
clustering
retrieval.passage
retrieval.query
retrieval.query → retrieval.passage
text-matching
0.7930.400.500.600.700.80
Correlate20.2%
Negativo difficile1.7%
Non correlate1.1%
Soglie consigliate
FPR 0.1 · 0.722
FPR 0.01 · 0.793
FPR 0.001 · 0.841
FPR 0.0001 · 0.865
bilanciata · 0.678
AUC
0.8242
Soglia del rumore
0.840
Crollo del richiamo
0.557
Coppie misurate
119 / 11k
Componenti del vettorehelp_outline
-0.180.000.19
σ 0.0361 · 183k valori
Geometria dell'embeddinghelp_outline
0768
Media per dimensione, passa il cursore per l'intervallo
Rumore di fondo
0.288
Dim. effettive
69 / 768
Troncamento delle dimensionihelp_outline
3264128256512768
text-matching · Soglia per dimensioni richieste
Coppie linguistichehelp_outline
de-ruen-deen-koen-zhja-ko
Dispersione della soglia tra le coppie: 0.027
Scegli i modelli da confrontare
Pubblicazioni (1)
SIGIR 2026
febbraio 17, 2026
jina-embeddings-v5-text: Task-Targeted Embedding Distillation

Panoramica

jina-embeddings-v5-text-nano è un modello di embedding testuale multilingue da 239M parametri costruito sul backbone EuroBERT-210M. Supporta un contesto di 8K token, produce embedding di 768 dimensioni con troncamento Matryoshka fino a 32 dimensioni e offre la più alta accuratezza per parametro nella famiglia di embedding sub-500M di Jina. Progettato per deployment edge, applicazioni sensibili alla latenza e ambienti a risorse limitate dove una GPU completa non è disponibile.

Metodi

Il modello è costruito su EuroBERT-210M, un encoder bidirezionale compatto preaddestrato su dati multilingue che coprono 15 lingue principali. Impiega il Last-Token-Pooling per generare embedding dalla rappresentazione del token finale. L'addestramento segue una ricetta di distillazione in due fasi: prima, la distillazione della conoscenza da un modello teacher più grande trasferisce la qualità dell'embedding; poi, una perdita contrastiva specifica per il task affina il modello su retrieval, text-matching, clustering e classificazione. Matryoshka Representation Learning consente di troncare le dimensioni degli embedding a qualsiasi dimensione supportata (32, 64, 128, 256, 512, 768) mantenendo prestazioni solide. Geometric Orthogonal Regularization (GOR) limita il degrado delle prestazioni sotto quantizzazione binaria a meno di 2 punti sul MTEB retrieval. La finestra di contesto di 8K abilita l'elaborazione di documenti lunghi senza chunking.

Prestazione

Su MMTEB (multilingue), il modello raggiunge 65,5 di media (livello task) e 57,7 di media (livello tipo) con appena 239M parametri, superando tutti i modelli sotto 500M, inclusi KaLM-mini-v2.5 (60,1, 494M), voyage-4-nano (58,9, 480M) e Gemma-300M (61,1, 308M). Punteggi a livello task: classificazione 69,2, clustering 52,7, classificazione di coppie 81,9, reranking 64,6, retrieval 63,3, STS 78,2. Su MTEB in inglese, raggiunge 71,0 di media, quasi all'altezza del molto più grande jina-embeddings-v5-text-small (71,7). Specifico per la retrieval: 63,26 su MTEB-M, 64,08 su RTEB, 56,06 su BEIR, 63,65 su LongEmbed. Gli embedding restano robusti sotto quantizzazione binaria grazie alla regolarizzazione GOR.

Orientamento

Seleziona il prefisso di task appropriato: 'retrieval' per la ricerca asimmetrica query-documento, 'text-matching' per similarità simmetrica, 'clustering' per il raggruppamento, 'classification' per la categorizzazione. Il troncamento Matryoshka a 256 dimensioni preserva oltre il 95% della qualità del retrieval riducendo lo storage del 67%. La quantizzazione binaria è supportata per una ulteriore riduzione dello storage. Il backbone EuroBERT offre forte copertura per 15 lingue principali, tra cui inglese, francese, tedesco, spagnolo, cinese, giapponese, arabo e hindi. Usa la similarità coseno per confrontare gli embedding. Disponibile via l'API Jina AI, Hugging Face (Sentence Transformers, vLLM) e varianti quantizzate per llama.cpp. Per carichi che richiedono contesto di 32K o maggiore accuratezza, usa invece jina-embeddings-v5-text-small.

Blog che menzionano questo modello
maggio 12, 2026 • 7 minuti letti
jina-embeddings-v3-omni:支持文本、图像、音频和视频的向量模型
Un modello, quattro modalità: testo, immagine, audio, video. I migliori modelli di embedding omni della categoria da 1,6B e 0,9B.
Jina AI
marzo 06, 2026 • 6 minuti letti
Identificare i modelli di embedding a partire da valori numerici grezzi
Un minuscolo transformer che crea impronte digitali per i modelli di embedding leggendo cifre numeriche grezze. Niente feature engineering.
Han Xiao
Fingerprint illustration made from numbers, showcasing digital and high-tech design on a light background.
febbraio 19, 2026 • 7 minuti letti
jina-embeddings-v5-text: Nuovi SOTA Small Multilingual Embeddings
Due 向量模型 multilingue sotto 1B con prestazioni migliori della categoria, disponibili su Elastic Inference Service, Llama.cpp e MLX.
Jina AI
Abstract digital artwork in black and white, featuring scattered dots forming letters in a halftone effect. The central lette
Lingua / tema attuale
Search Foundation
Reader
Embeddings
Reranker
Ottieni la chiave API Jina
Limite di velocità
Chi siamo
Notizie
Scarica il logo Jina
open_in_new
Scarica il logo Elastic
open_in_new
Stato dell'API
Elastic © 2026.SicurezzaTermini & CondizioniPrivacyGestisci i cookieNon vendere né condividere le mie informazioni personali
Questo sito web e tutti i contenuti, software, prodotti e servizi ad esso associati sono destinati esclusivamente all'uso professionale. Non è previsto né raccomandato alcun utilizzo da parte dei consumatori.

