Embeddings
jina-embeddings-v5-text-small
 GGUF
 MLX
 Elastic Inference Service
 API di Jina
 AWS SageMaker
 Hugging Face
 Air-gapped
Panoramica
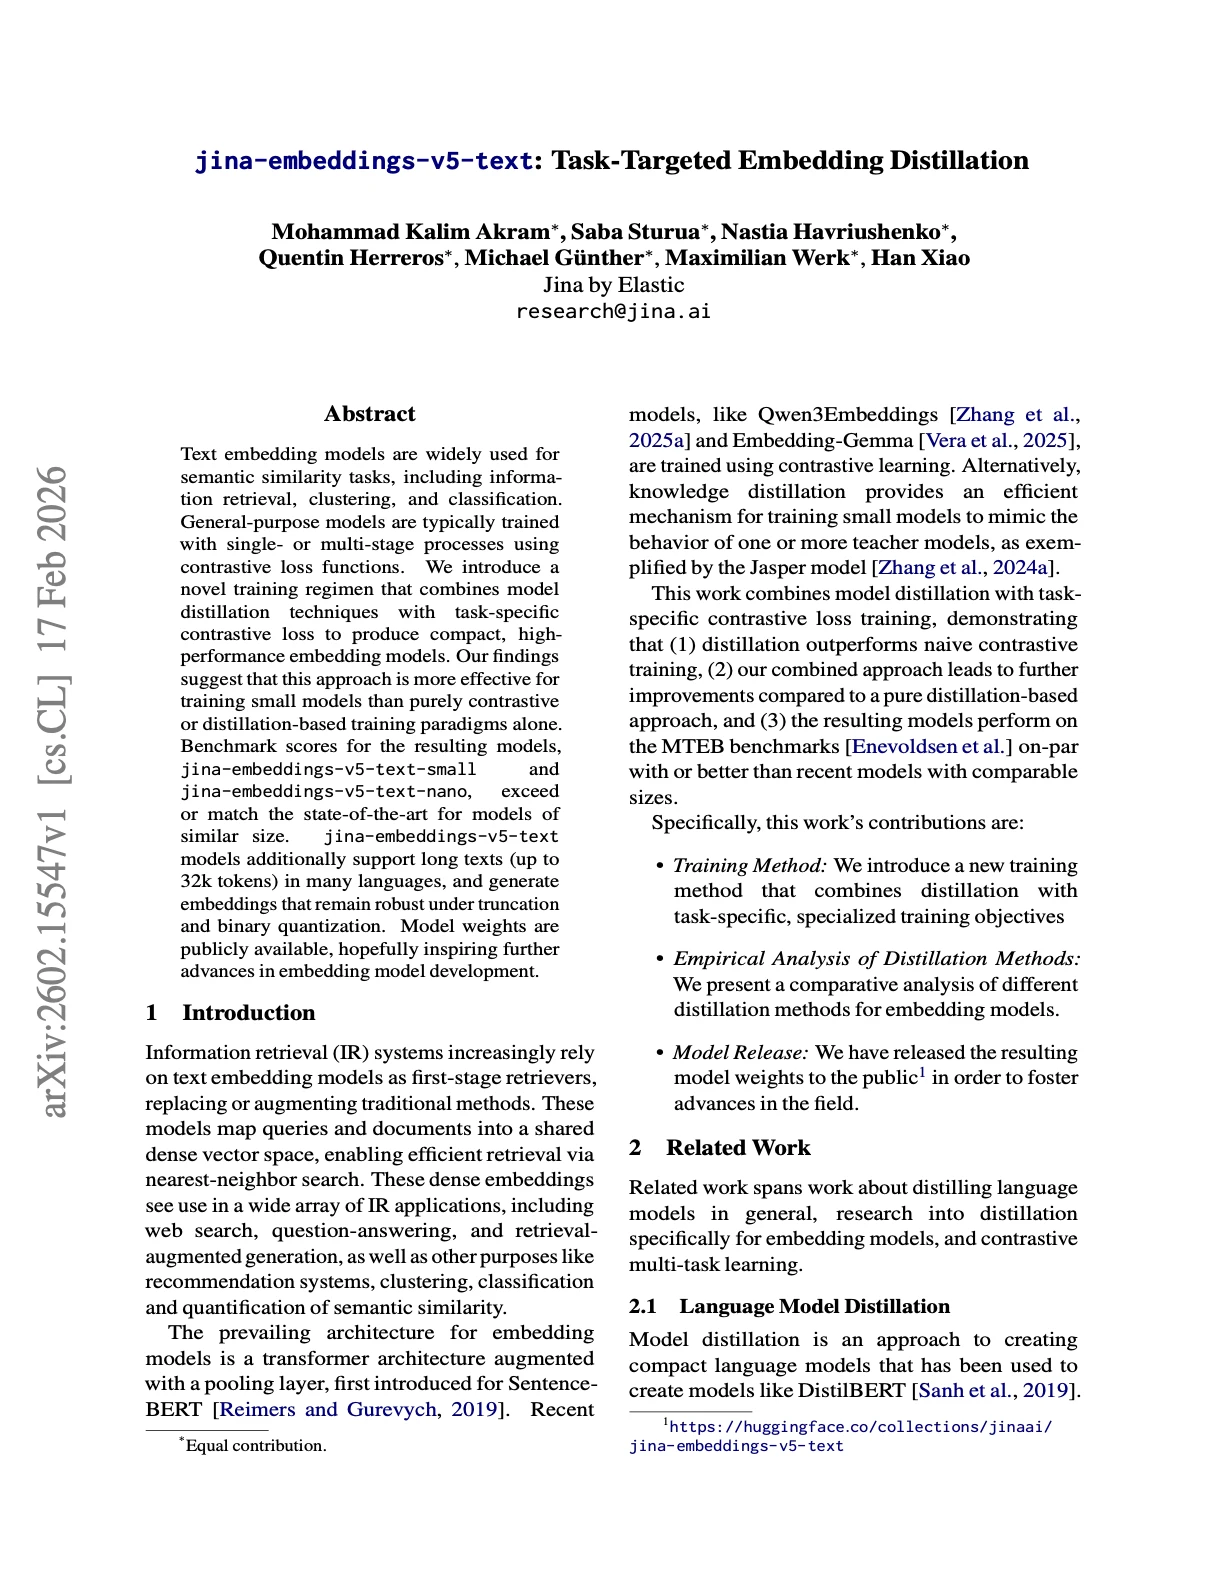
jina-embeddings-v5-text-small è un modello di embedding testuale multilingue da 677M parametri costruito sul backbone Qwen3-0,6B-Base. Supporta un contesto di 32K token, produce embedding di 1024 dimensioni con troncamento Matryoshka fino a 32 dimensioni e raggiunge la media MTEB più alta tra tutti i modelli con meno di 1B parametri. È il modello di embedding predefinito dell'API Jina e la raccomandazione principale per pipeline RAG di produzione.
Metodi
Il modello è costruito su Qwen3-0,6B-Base, un modello linguistico multilingue preaddestrato su 119 lingue. Impiega il Last-Token-Pooling per generare gli embedding. L'addestramento segue un regime in due fasi: (1) la distillazione degli embedding da Qwen3-Embedding-4B (un teacher di 4B parametri) trasferisce rappresentazioni di embedding di alta qualità al modello studente da 677M; (2) una perdita contrastiva specifica per il task affina il modello su retrieval, text-matching, clustering e classificazione. Geometric Orthogonal Regularization (GOR) garantisce che gli embedding restino robusti sotto quantizzazione binaria con perdita di performance minima. Matryoshka Representation Learning abilita il troncamento delle dimensioni da 1024 a 32 preservando una forte qualità del retrieval sopra le 256 dimensioni. La finestra di contesto di 32K è abilitata tramite rotary position embeddings con frequenze base tarate, e il modello è stato addestrato in aggiunta su dati di contesto lungo per un robusto retrieval di documenti lunghi.
Prestazione
Su MMTEB (multilingue), il modello raggiunge 67,0 di media (livello task) e 58,9 di media (livello tipo), il più alto tra tutti i modelli con meno di 1B parametri. Punteggi a livello task: classificazione 71,3, clustering 53,4, classificazione di coppie 82,9, reranking 65,7, retrieval 64,9, STS 78,9. Su MTEB in inglese, raggiunge 71,7 di media, superando Qwen3-0,6B con istruzioni (70,5) e jina-embeddings-v3 (65,7). Specifico per la retrieval: 64,88 su MTEB-M, 66,84 su RTEB, 56,67 su BEIR, 66,39 su LongEmbed. In modo notevole, il modello supera il suo teacher 4B Qwen3-Embedding-4B nella classificazione di coppie (42,0 vs. 26,8 su MMTEB) pur essendo 6× più piccolo, dimostrando che la distillazione combinata con addestramento contrastivo specifico per il task può eccedere le performance del teacher su task specifici.
Orientamento
Seleziona l'adattatore LoRA appropriato: 'retrieval' per la ricerca asimmetrica query-documento (prefissare 'Query:' alle query e 'Document:' ai passaggi), 'text-matching' per similarità simmetrica (prefisso 'Document:' per entrambi gli input), 'clustering' per il raggruppamento di documenti correlati, 'classification' per categorizzazione e analisi del sentimento. Il troncamento Matryoshka a 256–512 dimensioni è adatto all'indicizzazione con vincoli di storage; usa le 1024 dimensioni complete per il reranking. La quantizzazione binaria è supportata con perdita di performance minima. La finestra di contesto di 32K gestisce documenti lunghi nativamente senza chunking. Usa la similarità coseno per confrontare gli embedding. Disponibile tramite l'API Jina AI, Hugging Face (Sentence Transformers, vLLM) e varianti quantizzate per llama.cpp. Per carichi multimodali, usa invece jina-embeddings-v5-omni-small.