Reranker
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 API di Jina
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-gapped
Panoramica
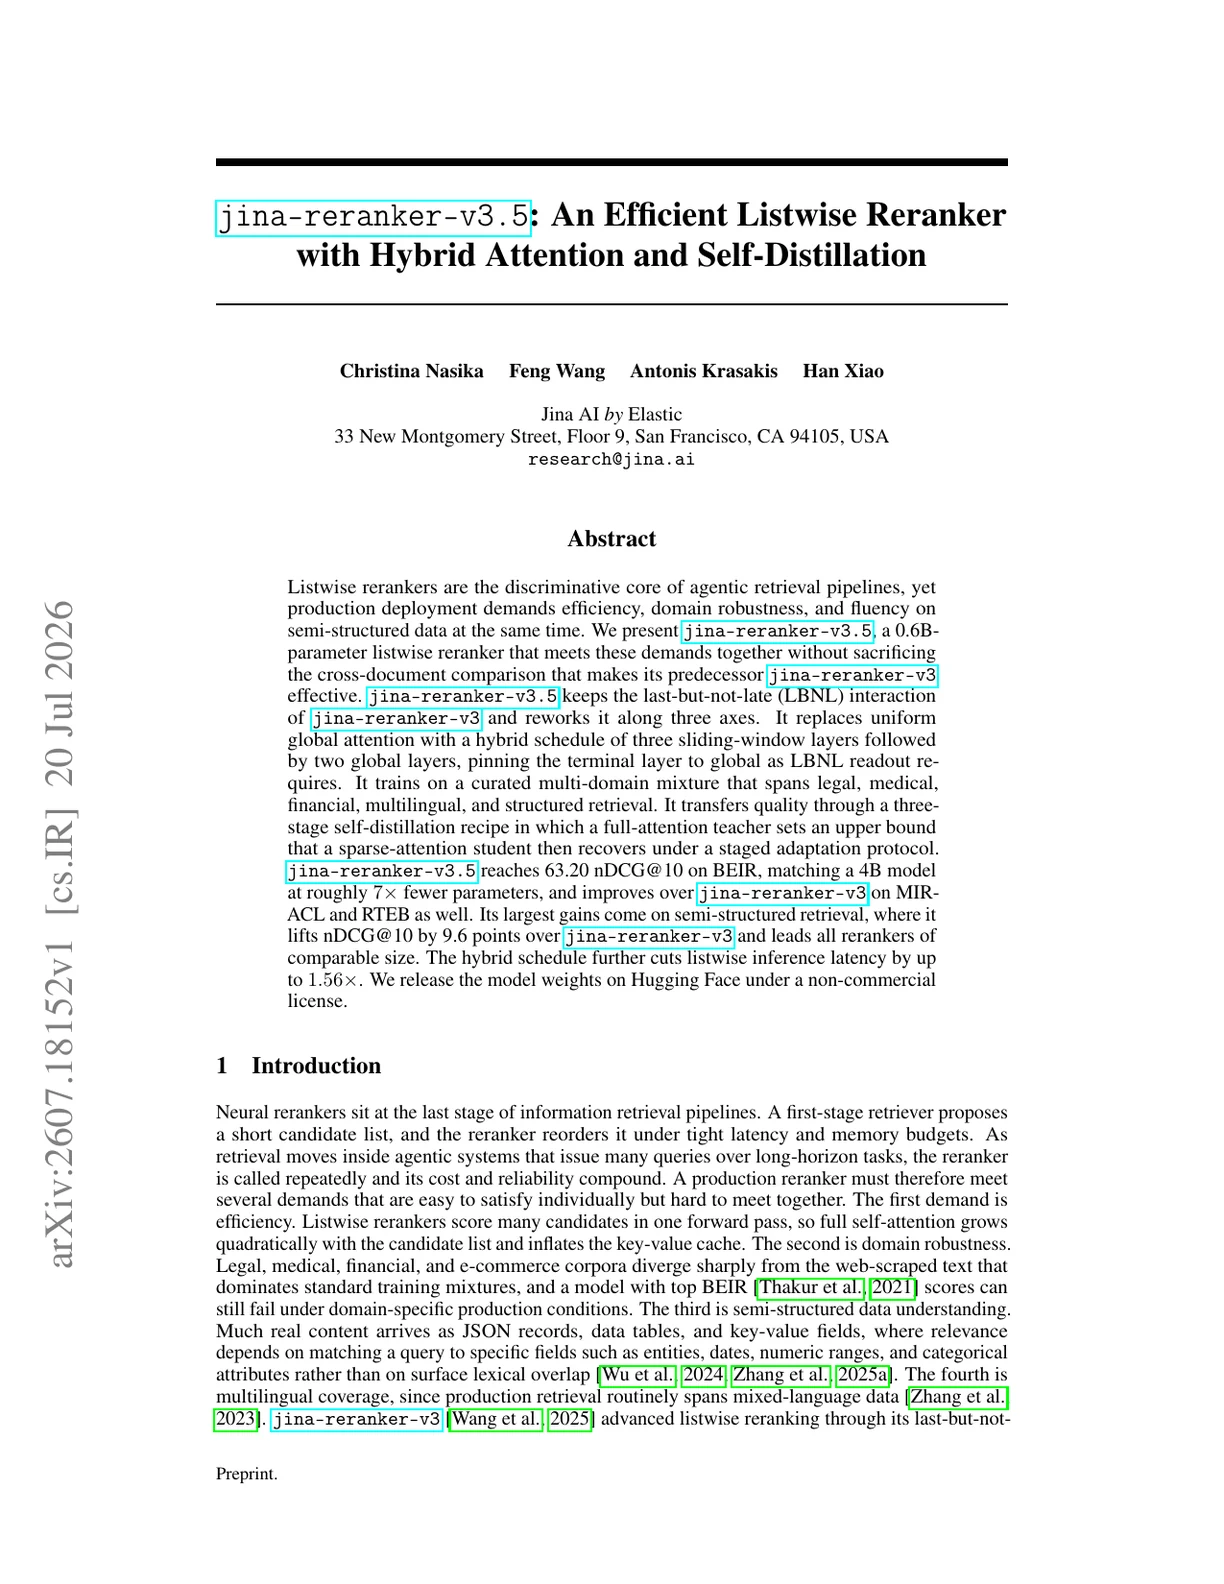
jina-reranker-v3.5 è un reranker listwise da 0,6B parametri che eguaglia i modelli da 4B parametri con circa 7× meno parametri. Introduce una pianificazione dell'attenzione ibrida (tre livelli a finestra scorrevole + due livelli globali) abbinata a una ricetta di auto-distillazione in tre fasi che trasferisce la qualità da un insegnante a attenzione completa a uno studente a attenzione dispersa. È una sostituzione drop-in di jina-reranker-v3, mantenendo lo stesso schema API migliorando al contempo efficienza e copertura dei domini.
Metodi
L'architettura conserva il design listwise LBNL di jina-reranker-v3: la query e tutti i documenti candidati condividono una singola finestra di contesto, e gli embedding vengono letti dall'ultimo token di ogni documento. L'innovazione chiave è la pianificazione dell'attenzione ibrida. Invece di un'attenzione globale uniforme in ogni livello, il modello usa tre livelli di attenzione a finestra scorrevole (che limitano l'attenzione di ciascuna posizione a una finestra locale) seguiti da due livelli di attenzione globale. Il livello terminale è fissato all'attenzione globale perché il meccanismo di lettura LBNL richiede che l'ultimo token consideri l'intero contesto. L'addestramento procede in tre fasi: (1) un modello insegnante a attenzione completa viene addestrato su una miscela multidominio curata che copre legale, medico, finanziario, multilingua e retrieval strutturato; (2) uno studente a attenzione dispersa viene inizializzato dall'insegnante e regolato con adattamento a stadi, aumentando gradualmente la proporzione di step di addestramento che usano la pianificazione ibrida; (3) una passata finale di distillazione in cui lo studente impara a riprodurre le distribuzioni di ranking morbide dell'insegnante, recuperando oltre il 97 % della qualità di ranking dell'insegnante mentre esegue il percorso di inferenza a attenzione dispersa, meno costoso.
Prestazione
Sotto un protocollo unificato top-100 con jina-embeddings-v5-text-small come retriever di prima fase, il modello ottiene 63,20 NDCG{'@'}10 sul BEIR, 74,11 su MIRACL, 70,95 su RTEB e 48,3 su Struct-IR, migliorando rispetto a jina-reranker-v3 (62,10 / 72,20 / 68,01 / 38,7) su ogni asse. Il suo score BEIR supera il Qwen3-Reranker da 4B (62,28) con circa 7× meno parametri. I guadagni relativi rispetto a v3 includono +1,10 BEIR, +2,6 % MIRACL, +4,3 % RTEB (con grandi aumenti nel retrieval legale) e +24,8 % nel ranking dei dati strutturati (Struct-IR). L'inferenza listwise gira 1,22×–1,56× più velocemente di v3 dai contesti corti ai lunghi (A100, FlashAttention-2). La miscela di addestramento multidominio produce miglioramenti particolarmente forti sui dati semistrutturati (tabelle, JSON, XML) e sui corpus di dominio specifico.
Orientamento
jina-reranker-v3.5 è una sostituzione drop-in di jina-reranker-v3: lo schema della richiesta non cambia, quindi cambiare la stringa del modello non richiede modifiche al codice. Classifica una query contro l'intera lista di candidati in una singola chiamata — passa i documenti attraverso l'endpoint standard di rerank e usa top_n per limitare i risultati restituiti, oppure imposta return_embeddings per recuperare anche gli embedding dei documenti. Il modello è particolarmente forte nel ranking dei dati strutturati, nel retrieval legale e in altri domini specifici, e nelle collection multilingua. Il suo design a attenzione ibrida mantiene bassa la latenza su lunghe liste di candidati. La finestra di contesto di 131K token supporta documenti molto lunghi senza chunking. Disponibile sotto CC-BY-NC-4.0 su Hugging Face; per l'uso commerciale, contatta Jina AI. Per i deployment in air-gap o on-premise, sono disponibili pesi quantizzati. Abbina con jina-embeddings-v5-text-small o jina-embeddings-v4 come retriever di prima fase.