Notizie

Accelerare la ricerca AI, un token alla volta.

RSS
In primo piano
Pubblicazioni accademiche
arXiv
settembre 02, 2026
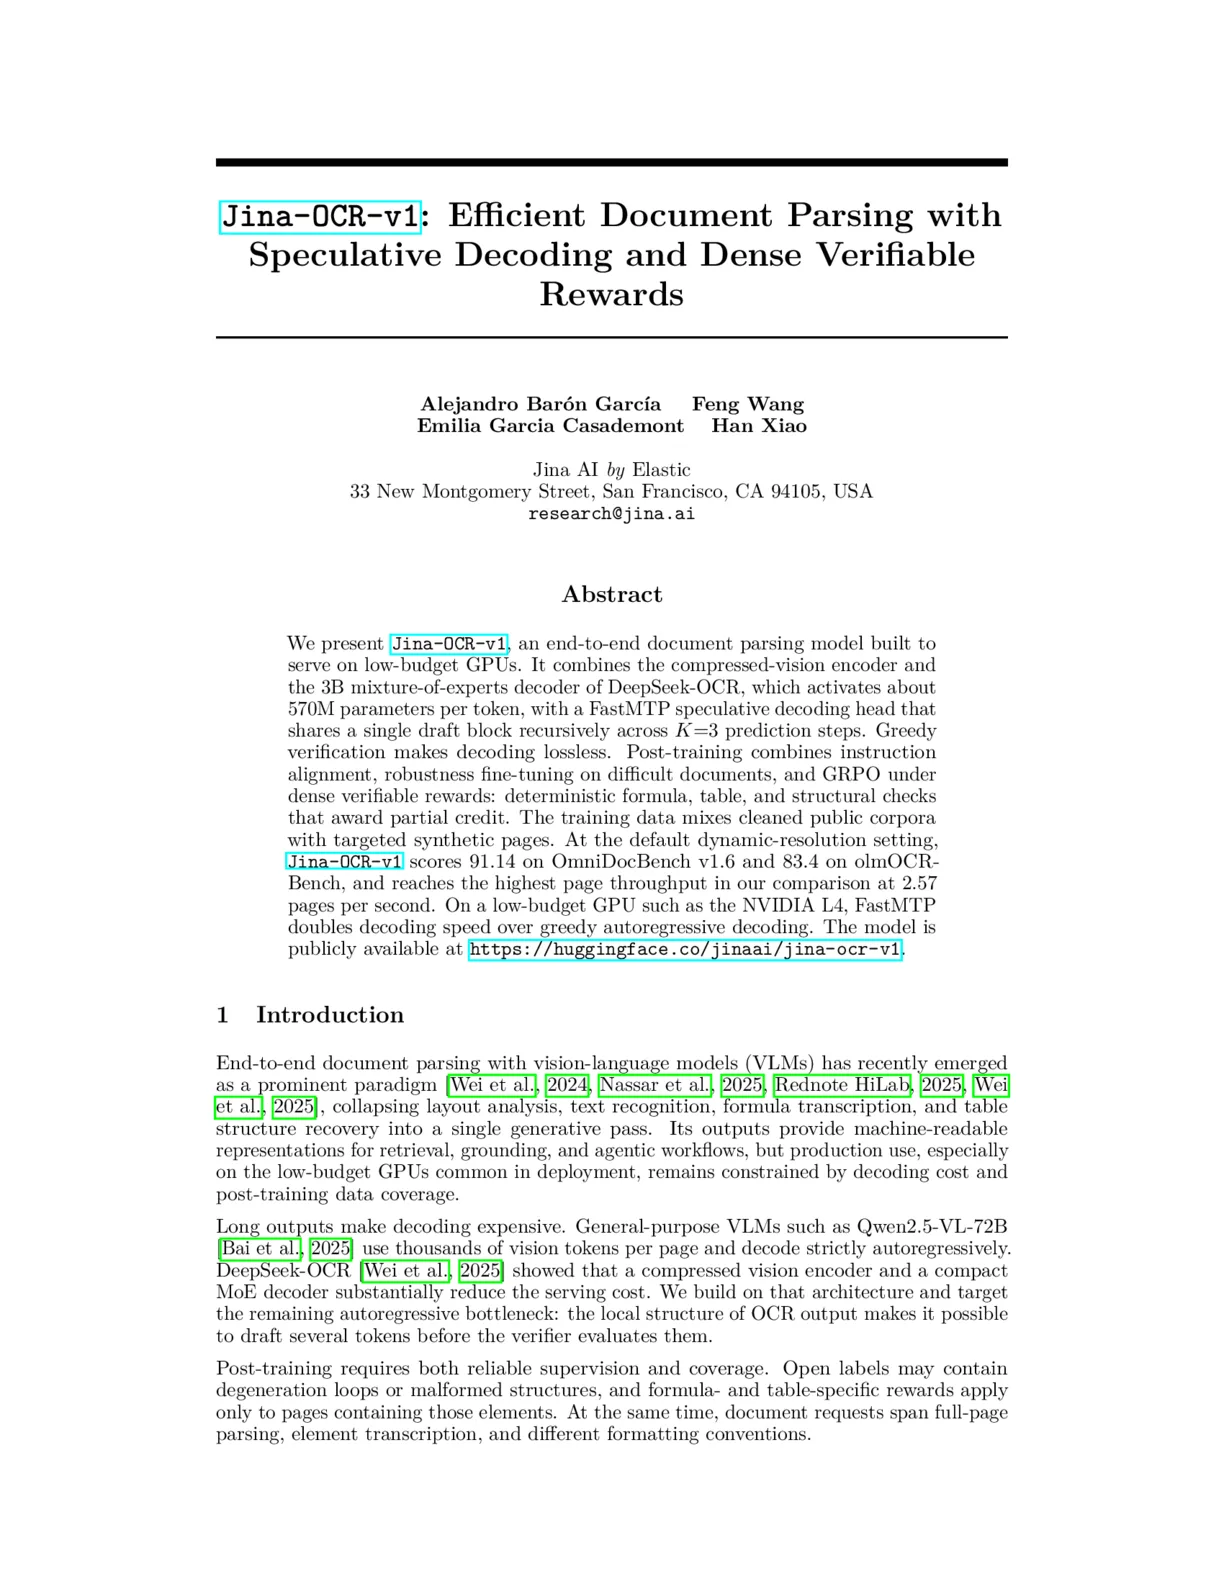
jina-ocr-v1: Efficient Document Parsing with Speculative Decoding and Dense Verifiable Rewards
arXiv
luglio 20, 2026
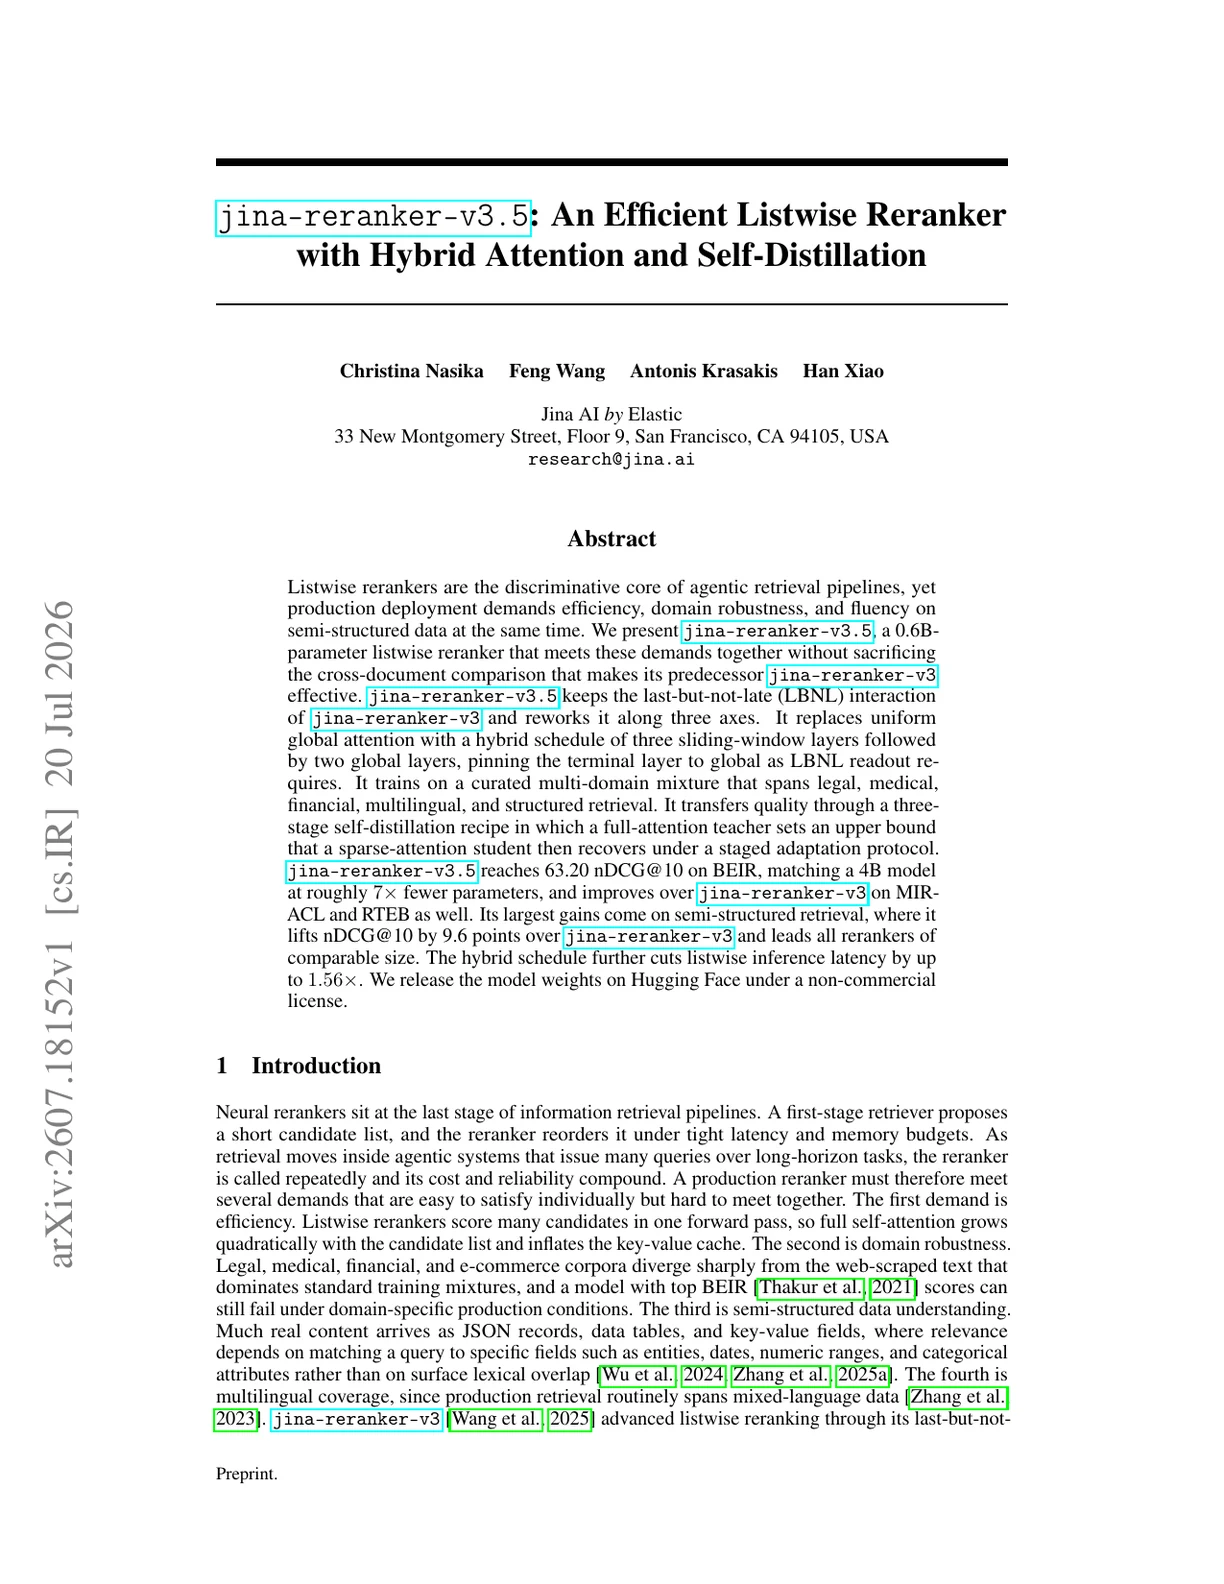
jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation
SIGIR 2026
maggio 11, 2026
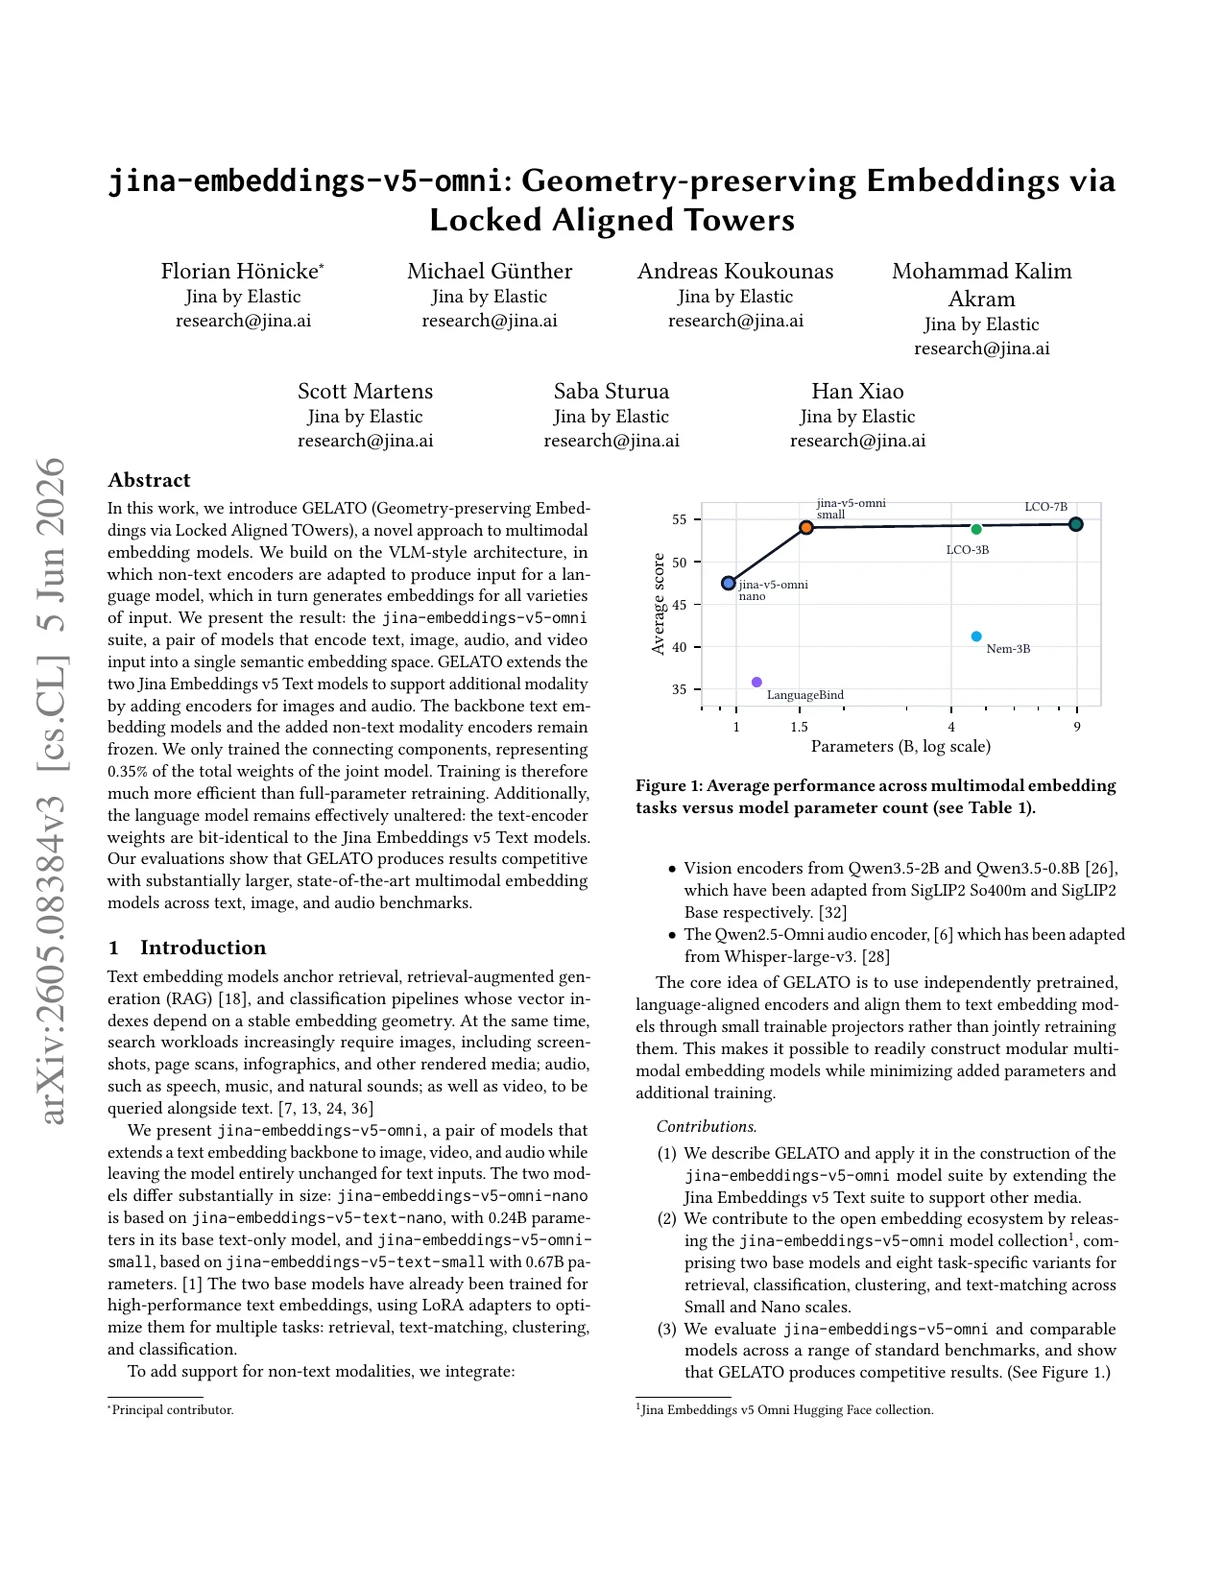
jina-embeddings-v5-omni: Geometry-preserving Embeddings via Locked Aligned Towers
SIGIR 2026
febbraio 17, 2026
jina-embeddings-v5-text: Task-Targeted Embedding Distillation
ICLR 2026
gennaio 22, 2026
Embedding Compression via Spherical Coordinates
arXiv
dicembre 29, 2025
Vision Encoders in Vision-Language Models: A Survey
ICLR 2026
dicembre 04, 2025
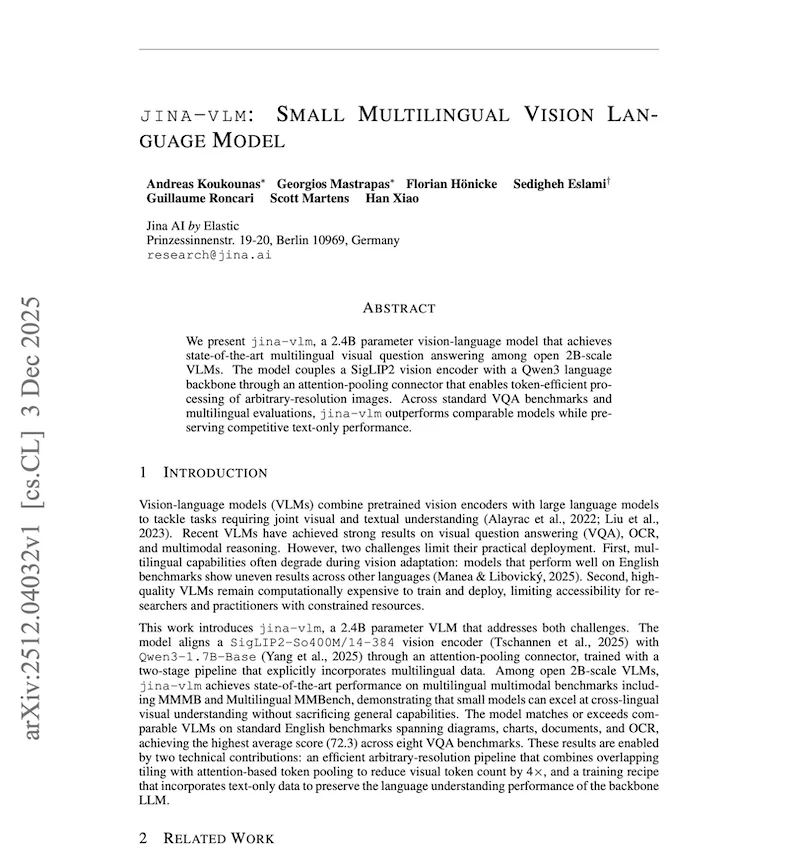
Jina-VLM: Small Multilingual Vision Language Model
AAAI 2026
ottobre 01, 2025
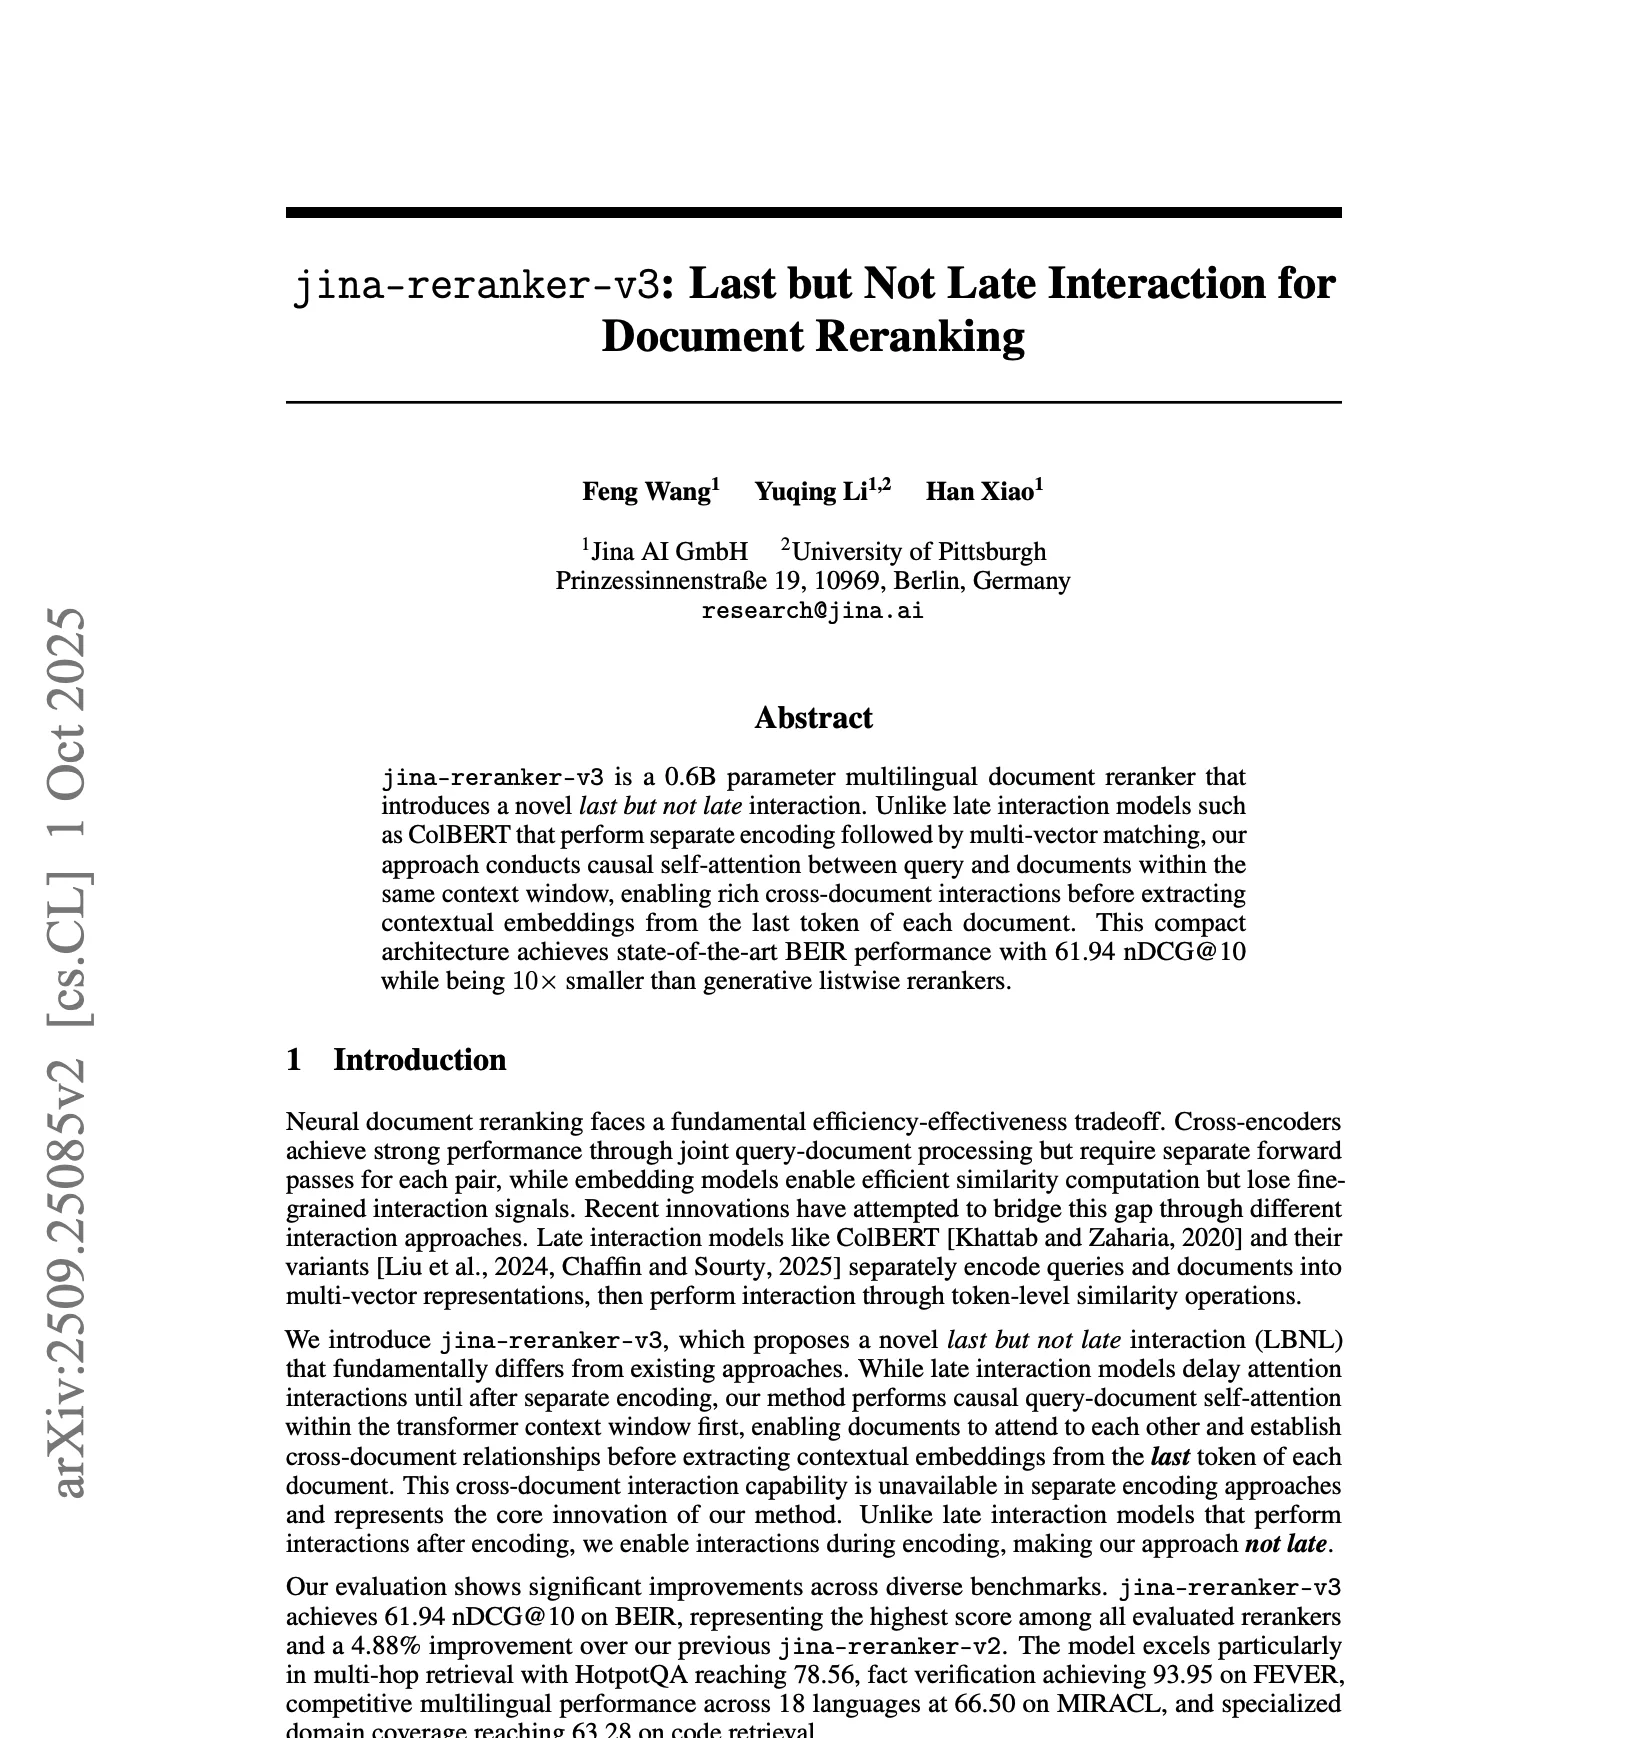
jina-reranker-v3: Last but Not Late Interaction for Document Reranking
NeurIPS 2025
agosto 31, 2025
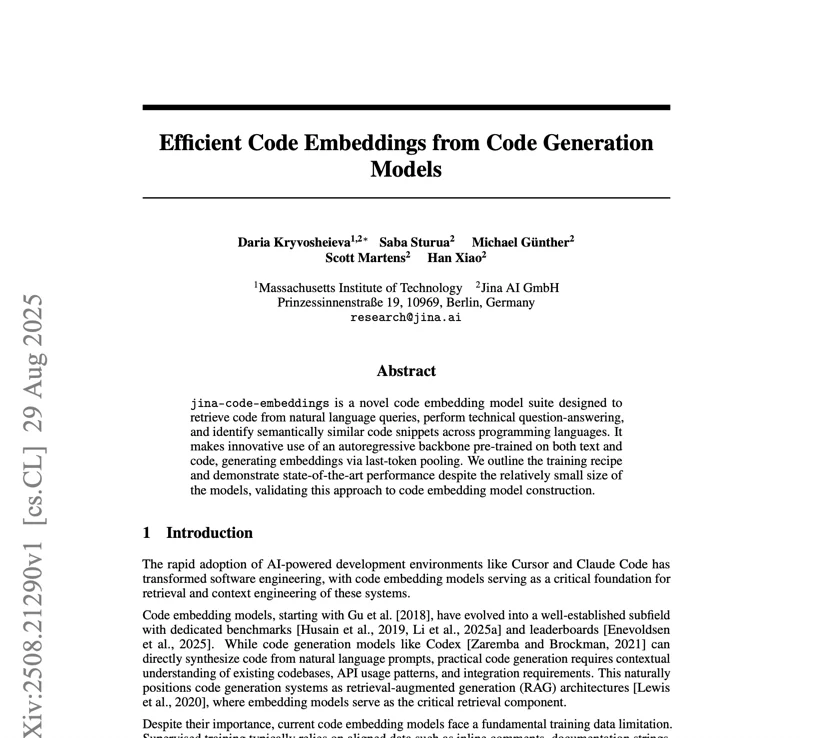
Efficient Code Embeddings from Code Generation Models
EMNLP 2025
giugno 24, 2025
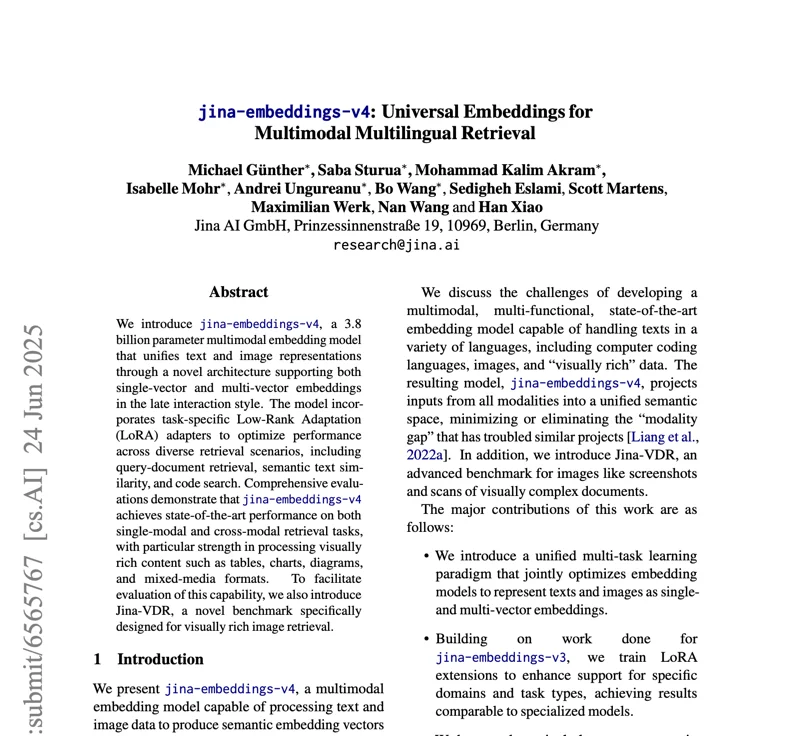
jina-embeddings-v4: Universal Embeddings for Multimodal Multilingual Retrieval
ICLR 2025
marzo 04, 2025
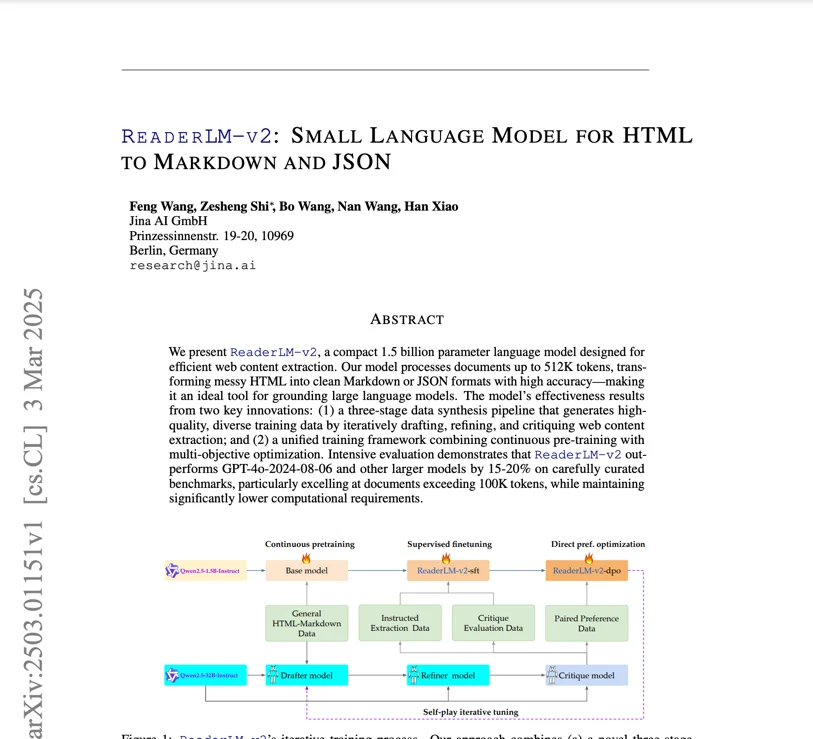
ReaderLM-v2: Small Language Model for HTML to Markdown and JSON
ACL 2025
dicembre 17, 2024
AIR-Bench: Automated Heterogeneous Information Retrieval Benchmark
ICLR 2025
dicembre 12, 2024
jina-clip-v2: Multilingual Multimodal Embeddings for Text and Images
ECIR 2025
settembre 18, 2024
jina-embeddings-v3: Multilingual Embeddings With Task LoRA
SIGIR 2025
settembre 07, 2024
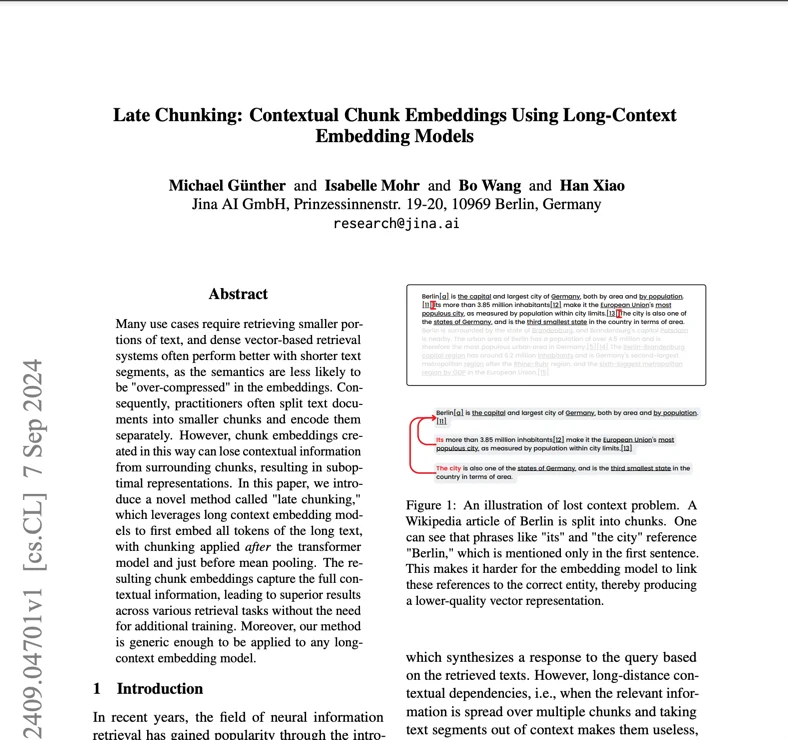
Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models
EMNLP 2024
agosto 30, 2024
Jina-ColBERT-v2: A General-Purpose Multilingual Late Interaction Retriever
WWW 2025
giugno 21, 2024
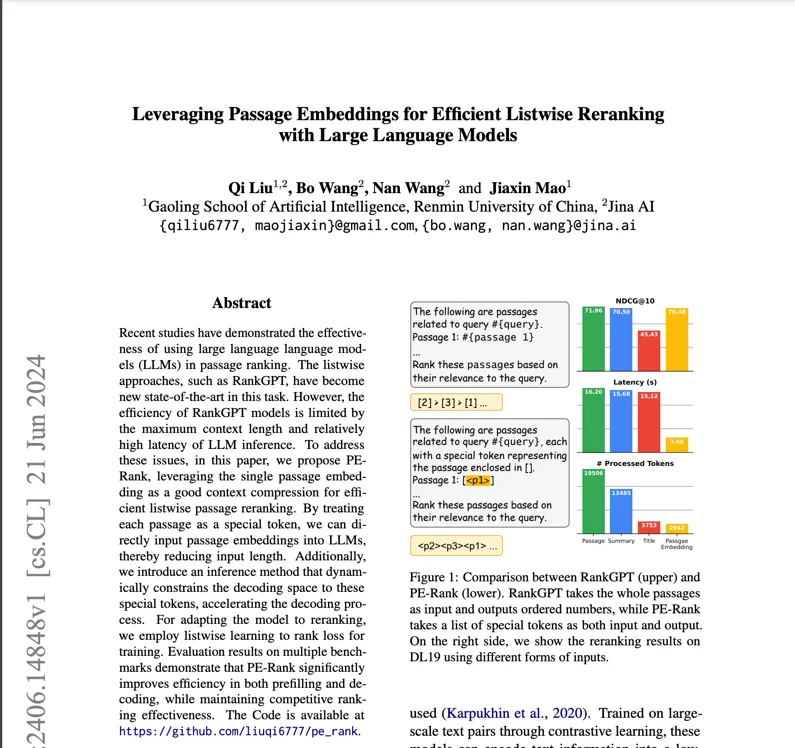
Leveraging Passage Embeddings for Efficient Listwise Reranking with Large Language Models
ICML 2024
maggio 30, 2024
Jina CLIP: Your CLIP Model Is Also Your Text Retriever
arXiv
febbraio 26, 2024
Multi-Task Contrastive Learning for 8192-Token Bilingual Text Embeddings
arXiv
ottobre 30, 2023
Jina Embeddings 2: 8192-Token General-Purpose Text Embeddings for Long Documents
EMNLP 2023
luglio 20, 2023
Jina Embeddings: A Novel Set of High-Performance Sentence Embedding Models
21 pubblicazioni in totale.

settembre 14, 2026 • 9 minuti letti
jina-ocr-v1: Analisi documentale più rapida su GPU a basso costo
jina-ocr-v1 è un modello multimodale (vision language model) con 3,4 miliardi di parametri e 570 milioni di parametri attivi, che ha ottenuto un punteggio di 91,1 su OmniDocBench v1.6 e di 83,4 su olmOCR-Bench.
agosto 03, 2026 • 11 minuti letti
jina-reranker-v3.5: Reranking listwise più veloce con Hybrid Attention e Self-Distillation
Un Reranker listwise da 0,6B che supera Qwen3-Reranker-4B su BEIR, esegue il reranking fino a 1,56 volte più velocemente rispetto alla v3 e guadagna 9,6 nDCG@10 nel recupero semi-strutturato.
maggio 12, 2026 • 7 minuti letti
jina-embeddings-v3-omni:支持文本、图像、音频和视频的向量模型
Un modello, quattro modalità: testo, immagine, audio, video. I migliori modelli di embedding omni della categoria da 1,6B e 0,9B.
marzo 11, 2026 • 7 minuti letti
Bootstrapping di embedding audio da LLM multimodali
Trasforma qualsiasi LLM multimodale in un piccolo modello di embedding audio che supera CLAP con 25 volte meno dati.
marzo 06, 2026 • 6 minuti letti
Identificare i modelli di embedding a partire da valori numerici grezzi
Un minuscolo transformer che crea impronte digitali per i modelli di embedding leggendo cifre numeriche grezze. Niente feature engineering.
febbraio 19, 2026 • 7 minuti letti
jina-embeddings-v5-text: Nuovi SOTA Small Multilingual Embeddings
Due 向量模型 multilingue sotto 1B con prestazioni migliori della categoria, disponibili su Elastic Inference Service, Llama.cpp e MLX.
dicembre 04, 2025 • 7 minuti letti
Jina-VLM: Modello di linguaggio visivo multilingue di piccole dimensioni
Un nuovo modello di linguaggio visivo da 2B raggiunge lo SOTA sul VQA multilingue, senza perdita catastrofica di informazioni sulle attività di solo testo.
ottobre 03, 2025 • 7 minuti letti
Jina Reranker v3: Reranker Listwise da 0.6B per il recupero multilingue SOTA
Nuovo *reranker* *listwise* da 0.6 miliardi di parametri che considera la query e tutti i documenti candidati in una singola finestra di contesto.
settembre 09, 2025 • 11 minuti letti
Modelli di Embedding Multimodali in Llama.cpp e GGUF
Abbiamo introdotto i vettori modello multimodali in llama.cpp e GGUF, e abbiamo scoperto alcune problematiche sorprendenti lungo il percorso.
settembre 04, 2025 • 6 minuti letti

Jina Code Embeddings: Recupero di codice SOTA a 0,5B e 1,5B
LLM per la generazione di codice → Embeddings di codice: i modelli da 0,5B/1,5B raggiungono prestazioni SOTA su 25 benchmark di recupero del codice.