

Embeddings
検索、RAG、エージェントアプリケーション向けの最先端のマルチモーダルな多言語ロングコンテキストベクトルモデル。
ベクトルモデルAPI
検索システムと RAG システムを改善するために、当社の埋め込みモデルをお試しください。無料トライアルから始められます!
curl "https://api.jina.ai/v1/embeddings" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $JINA_API_KEY" \
  -d @- <<EOFEOF
{
  "model": null,
  "normalized": true,
  "embedding_type": "float",
  "input": [
    text_fieldsclose"Organic skincare for sensitive skin with aloe vera and chamomile: Imagine the soothing embrace of na…ing, healthy complexion.",
    text_fieldsclose"Bio-Hautpflege für empfindliche Haut mit Aloe Vera und Kamille: Erleben Sie die wohltuende Wirkung u…einen strahlenden Teint.",
    text_fieldsclose"Cuidado de la piel orgánico para piel sensible con aloe vera y manzanilla: Descubre el poder de la n…el radiante y saludable.",
    text_fieldsclose"针对敏感肌专门设计的天然有机护肤产品:体验由芦荟和洋甘菊提取物带来的自然呵护。我们的护肤产品特别为敏感肌设计,温和滋润,保护您的肌肤不受刺激。让您的肌肤告别不适,迎来健康光彩。",
    text_fieldsclose"新しいメイクのトレンドは鮮やかな色と革新的な技術に焦点を当てています: 今シーズンのメイクアップトレンドは、大胆な色彩と革新的な技術に注目しています。ネオンアイライナーからホログラフィックハイライターまで、クリエイティビティを解き放ち、毎回ユニークなルックを演出しましょう。"
    + 入力を追加
  ]
}
EOFEOFv5-omni: すべてを 1 つの embedding で
テキスト、画像、音声、動画 — 1 つの共有 embedding 空間、2 つのサイズ。v5-omni-small(1.6B)は、20 億パラメータ未満のオープンウェイト omni モデルの中で最高のパフォーマンスを発揮します。v5-omni-nano(0.9B)は、10 億未満のパラメータで競争力のある検索性能を提供します。どちらも v5-text とバイト単位で互換性があり、再インデックスは不要です。
v5-text: 新しい SOTA の小型多言語 embeddings
jina-embeddings-v5-textは、2つの効率的なサイズ(677Mの小型モデルと239Mのナノスケールモデル)で第5世代のベクトル品質を提供し、タスク固有のLoRAアダプタ、Matryoshka 次元、32Kコンテキスト、エッジ展開のためのGGUF/MLX量子化により、MMTEB、MTEB英語、および検索タスクにおいて新たなベンチマークを確立します。
2つの購入方法
弊社の API をサブスクライブするか、クラウドサービスプロバイダーを通じて購入してください。
radio_button_unchecked
cloud
3 のクラウドサービスプロバイダーと連携します
AWS または Azure をご利用ですか?当社のモデルを自社のクラウドプラットフォームに直接デプロイし、CSP アカウント経由で請求を処理できます。
radio_button_checked

Jina Search Foundation API を利用
すべての製品にアクセスする最も簡単な方法。いつでもトークンをリチャージできます。
この API キーにさらにトークンを追加します
リチャージするには正しい API キーを入力してください
レート制限について学ぶ
レート制限とは、1 分間に IP アドレス/API キー (RPM) ごとに API に対して実行できるリクエストの最大数です。各製品およびティアのレート制限の詳細については、以下をご覧ください。
keyboard_arrow_down

オンプレミス展開
Jina Embeddings モデルを AWS SageMaker と Microsoft Azure にデプロイし、まもなく Google Cloud サービスにもデプロイするか、当社の営業チームに問い合わせて、仮想プライベートクラウドとオンプレミスサーバー用のカスタム Kubernetes デプロイメントを入手してください。
 AWS SageMaker
 Embeddings
 Reranker
 Microsoft AzureEmbeddingsReranker
 Google CloudEmbeddings

API統合
当社のベクターモデル API は、一般的なデータベース、ベクターデータベース、RAG および LLMOps フレームワークで簡単に使用できます。開始するには、API キーを以下の統合のいずれかにコピーするだけで、モデルをすぐに使用できます。
ベクトルストア
LLMOps
RAG
可観測性

MongoDB

DataStax

Qdrant

Pinecone

Chroma

Weaviate
Milvus

Epsilla

MyScale

LlamaIndex

Haystack

Langchain

Dify

SuperDuperDB
%20rotate(-89.93)'/%3e%3crect%20class='cls-1'%20x='30.52'%20y='10.19'%20width='3'%20height='47.42'%20transform='translate(-13.3%2044.91)%20rotate(-60.3)'/%3e%3ccircle%20id='_椭圆形'%20class='cls-1'%20cx='28.91'%20cy='31.28'%20r='5'/%3e%3cpolygon%20class='cls-1'%20points='42.43%2030.75%2035.08%2029.1%2036.37%2021.5%2039.33%2022.01%2038.51%2026.8%2043.09%2027.82%2042.43%2030.75'/%3e%3cpolygon%20class='cls-1'%20points='16.75%2045.55%209.43%2043.77%2010.86%2036.19%2013.8%2036.75%2012.9%2041.53%2017.46%2042.63%2016.75%2045.55'/%3e%3cpolygon%20class='cls-1'%20points='11.02%2028.19%209.54%2020.8%2017.01%2018.89%2017.75%2021.8%2013.04%2023%2013.96%2027.6%2011.02%2028.19'/%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
DashVector
Portkey

Baseten

TiDB
LanceDB

Carbon
私たちの論文
最先端の検索モデルをゼロからどう訓練したか、最新の研究成果もご紹介します。EMNLP、SIGIR、ICLR、NeurIPS、ICML では、当社チームにお立ち会いください!
 arXiv
9月 02, 2026
 arXiv
7月 20, 2026
SIGIR 2026
5月 11, 2026
SIGIR 2026
2月 17, 2026

ICLR 2026
1月 22, 2026
 arXiv
12月 29, 2025
ICLR 2026
12月 04, 2025
AAAI 2026
10月 01, 2025
NeurIPS 2025
8月 31, 2025
EMNLP 2025
6月 24, 2025
ICLR 2025
3月 04, 2025
ACL 2025
12月 17, 2024
ICLR 2025
12月 12, 2024
ECIR 2025
9月 18, 2024
SIGIR 2025
9月 07, 2024
EMNLP 2024
8月 30, 2024
WWW 2025
6月 21, 2024
ICML 2024
5月 30, 2024
 arXiv
2月 26, 2024
 arXiv
10月 30, 2023

EMNLP 2023
7月 20, 2023
合計で 21 件の論文があります。
ベクトルモデルの学習
ベクトルとは何ですか?なぜベクトル化する必要があるのですか?始めるための記事がいくつかあります。包括的なガイドでベクトルモデルについて基礎から学びましょう。


Reranker、ベクトル検索、BM25 の比較
以下の表は、Reranker、ベクトル/埋め込み検索、BM25 の包括的な比較を示し、各カテゴリにおける長所と短所を示しています。
| Reranker | ベクトル検索 | BM25 | |
|---|---|---|---|
| 最適な用途 | 検索の精度と関連性の向上 | 初期の迅速なフィルタリング | 幅広いクエリにわたる一般的なテキスト検索 |
| 粒度 | 詳細:サブドキュメントとクエリセグメント | 広範囲:文書全体 | 中程度:さまざまなテキストセグメント |
| クエリ時間の複雑さ | 高い | 中程度 | 低い |
| インデックス作成時間の複雑さ | 不要 | 高い | 低い、事前に構築されたインデックスを利用する |
| トレーニング時間の複雑さ | 高い | 高い | 不要 |
| 検索品質 | より詳細な問い合わせに最適 | 効率と精度のバランス | 幅広いクエリに対する一貫性と信頼性 |
| 強み | 深い文脈理解による高精度 | 中程度の精度で高速かつ効率的 | 確立された機能で拡張性が高い |
| Reranker API を無料で試す | Embedding API を無料で試す |
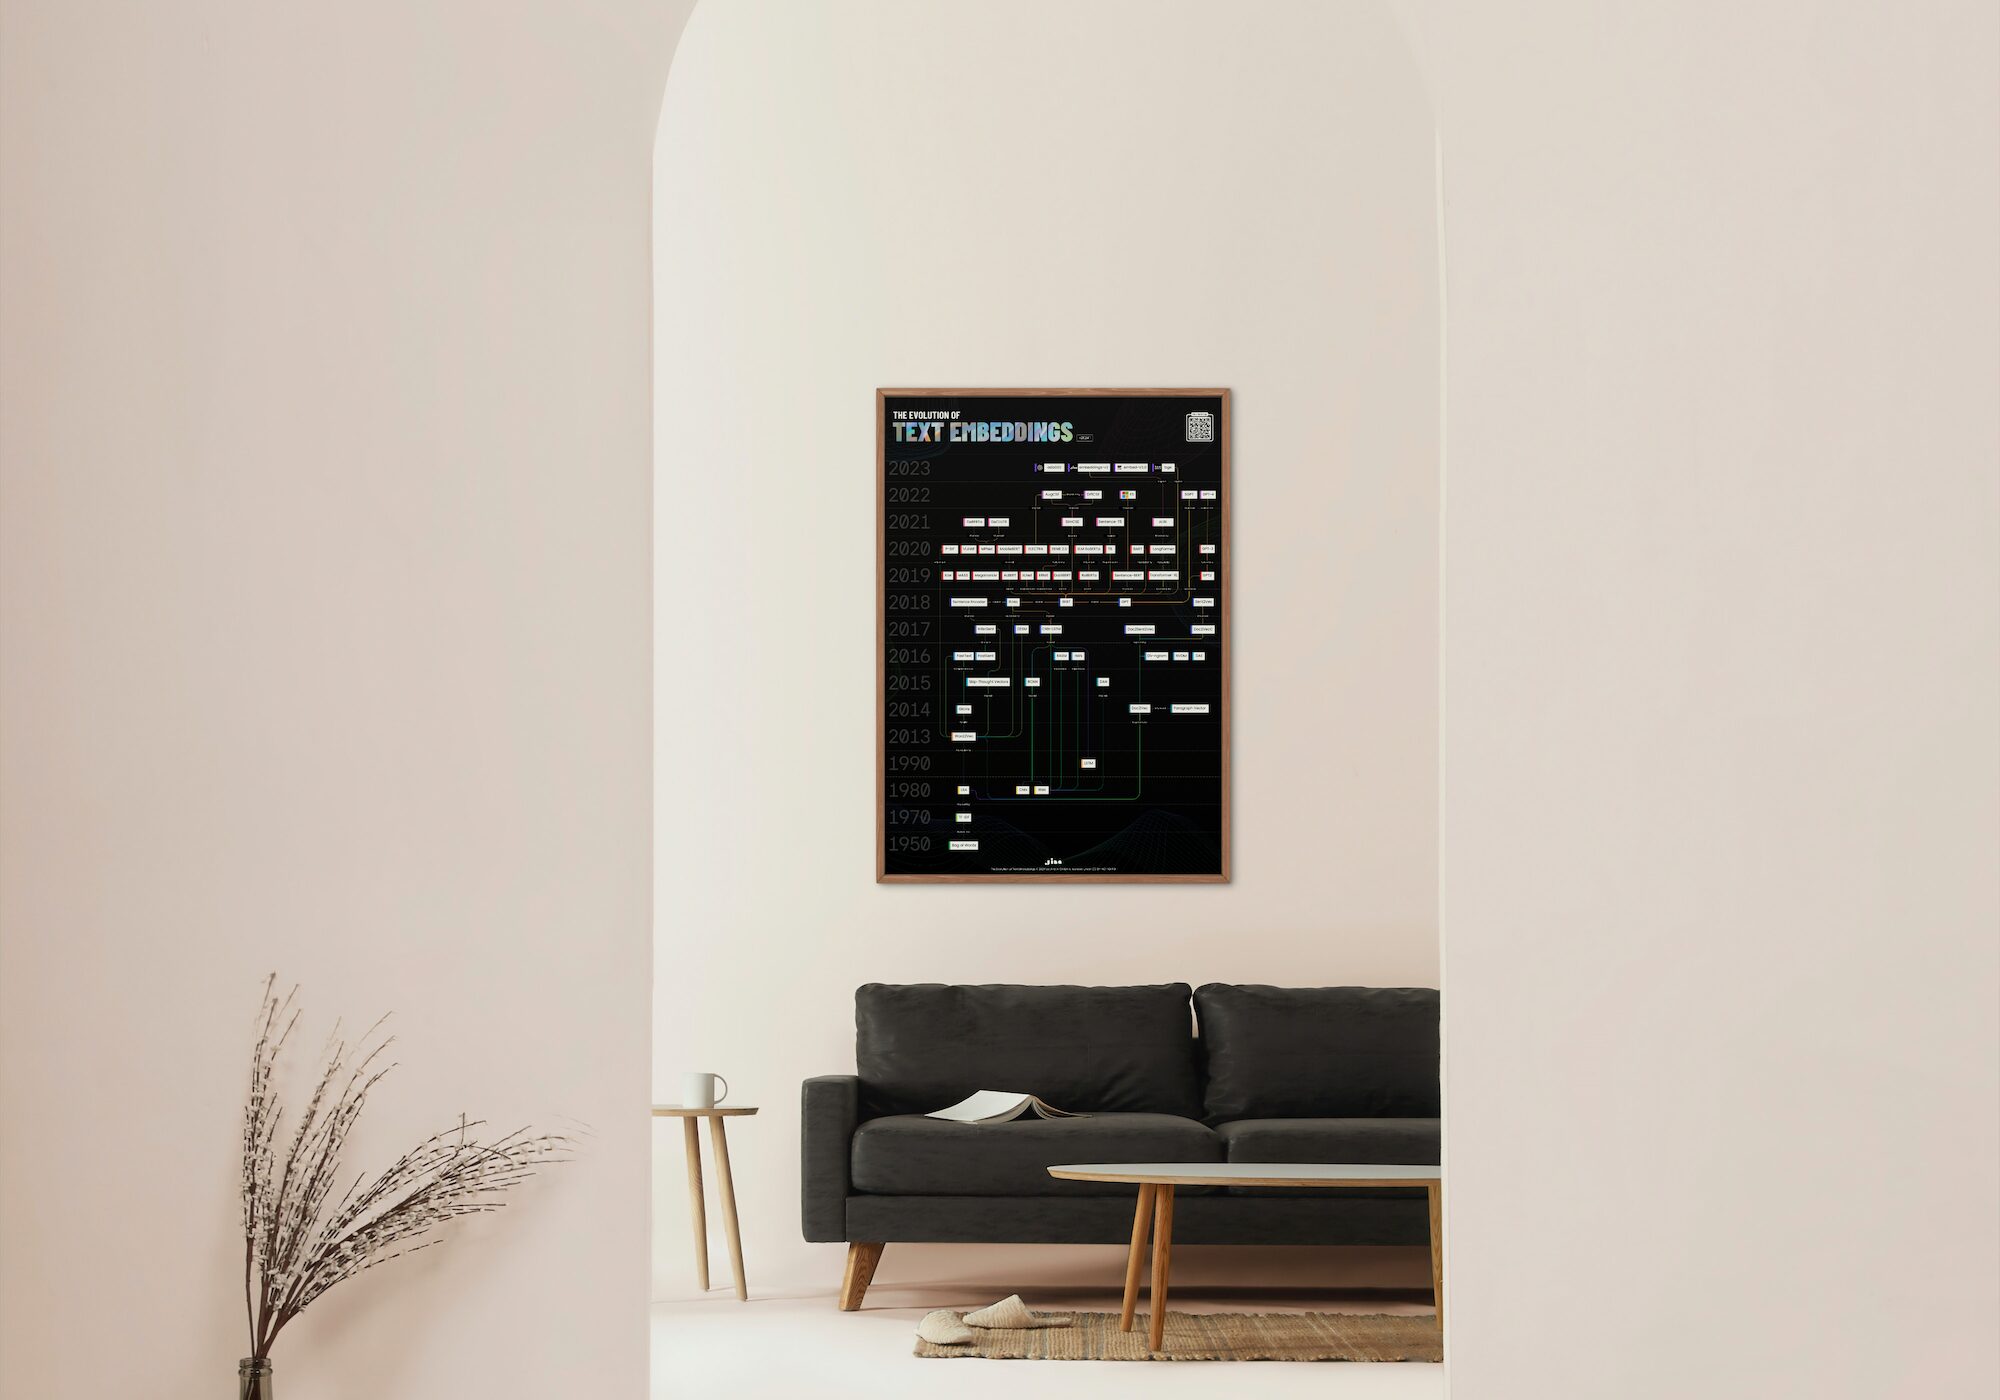
ベクトルモデルの進化ポスター
当社の丁寧に作られたポスターをオフィススペースやリビングルームに飾って、1950 年以来のテキストベクターモデルの進化と進化から次のインスピレーションを見つけてください。
Jina 埋め込みモデルはどのようにトレーニングされますか?
keyboard_arrow_down
マルチモーダルベクトルモデルにはどのようなものがありますか?
keyboard_arrow_down
Jina のモデルはどの言語をサポートしていますか?
keyboard_arrow_down
単一入力におけるコンテキストの最大長はどれくらいですか?
keyboard_arrow_down
1つのリクエストに含めることができる入力の最大数はいくつですか?
keyboard_arrow_down
画像、音声、動画、またはPDFファイルをマルチモーダルモデルに送信するにはどうすればよいですか?
keyboard_arrow_down
Jinaの埋め込みモデルは、最新のOpenAI、Cohere、Voyageのモデルと比べてどうでしょうか?
keyboard_arrow_down
OpenAI の text-embedding-3-large から Jina Embeddings モデルに移行するにはどうすればよいですか?
keyboard_arrow_down
画像やその他の非テキスト入力のトークンを計算する方法は?
keyboard_arrow_down
画像、音声、または動画を埋め込むためのモデルを提供していますか?
keyboard_arrow_down
Jinaの埋め込みモデルは、個人データや企業データで微調整できますか?
keyboard_arrow_down
モデルをプライベートサーバーでホストすることは可能ですか?例えば、自分のインフラストラクチャやクラウドアカウントでホストすることはできますか?
keyboard_arrow_down
「タスク」パラメータとは何ですか?どのような状況で使用すればよいですか?
keyboard_arrow_down
レイテインタラクション検索とは何ですか?どのモデルがこれをサポートしていますか?
keyboard_arrow_down
遅延チャンキングとは何ですか?どのような状況で使用すればよいですか?
keyboard_arrow_down
APIによって強制されるコンテキスト長が、モデルによってサポートされるコンテキスト長と異なるのはなぜですか?
keyboard_arrow_down
jina-embeddings-v4 は無料なのになぜこんなに遅いのでしょうか?
keyboard_arrow_down
Embeddings API のレート制限は何ですか?
keyboard_arrow_down
どの埋め込みモデルを選択すべきでしょうか?
keyboard_arrow_down
画像や PDF ファイルのサイズ制限は何ですか?
keyboard_arrow_down
レート制限
レート制限は 2 つの方法で追跡されます:RPM (1 分あたりのリクエスト数) および TPM (1 分あたりのトークン数)。制限は IP/API キーごとに適用され、RPM または TPM のしきい値のいずれかに先に達した時点でトリガーされます。リクエストヘッダーに API キーを指定すると、IP アドレスではなくキー単位でレート制限が追跡されます。
| 製品 | API エンドポイント | 説明arrow_upward | API キーなしkey_off | 無料 API キーありkey | 有料 API キーありkey | プレミアム API キーありkey | 平均レイテンシ | トークン使用量のカウント方法 | 許可されるリクエスト | |
|---|---|---|---|---|---|---|---|---|---|---|
| Reader API | https://r.jina.ai | URL を LLM に適したテキストに変換する | 20 RPM | 500 RPM | 500 RPM | trending_up5000 RPM | 7.9s | 出力応答内のトークンの数に基づきます。 | GET/POST | |
| Reader API | https://s.jina.ai | Web を検索し、結果を LLM に適したテキストに変換する | block | 100 RPM | 100 RPM | trending_up1000 RPM | 2.5s | 各リクエストには、10,000 トークンから始まる固定数のトークンが必要です。 | GET/POST | |
| Reranker API | https://api.jina.ai/v1/rerank | クエリに基づいてドキュメントをランク付けする | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart 入力サイズに依存 help | 入力リクエスト内のトークンの数に基づきます。 | POST | |
| ベクトルモデルAPI | https://api.jina.ai/v1/embeddings | テキスト/画像を固定長ベクトルに変換する | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart 入力サイズに依存 help | 入力リクエスト内のトークンの数に基づきます。 | POST |
CC BY-NCライセンスの自己チェック
play_arrow
弊社のマネージドAPIをご利用ですか、それともAzure、AWS、GCP上の公式ミラーをご利用ですか?
play_arrow
はい
play_arrow
いいえ
API関連のFAQ
code
JinaのすべてのAPIで同じAPIキーを使用できますか?
keyboard_arrow_down
code
API キーのトークンの使用状況を表示できますか?
keyboard_arrow_down
code
API キーを忘れた場合はどうすればよいですか?
keyboard_arrow_down
code
API キーには有効期限がありますか?
keyboard_arrow_down
code
API キー間でトークン残高を転送できますか?
keyboard_arrow_down
code
API キーを破棄してもいいですか?
keyboard_arrow_down
code
一部のモデルの初回リクエストに時間がかかるのはなぜですか?
keyboard_arrow_down
code
私の API データはモデルのトレーニングに使用されましたか?
keyboard_arrow_down
code
Jina API のレート制限は何ですか?
keyboard_arrow_down
code
API にはバッチサイズの制限がありますか?
keyboard_arrow_down
code
ElasticsearchのJina APIは、Jinaモデルと同じですか?
keyboard_arrow_down
請求に関するよくある質問
attach_money
API の料金は文の数またはリクエストの数に基づいて課金されますか?
keyboard_arrow_down
attach_money
新規ユーザーは無料トライアルを利用できますか?
keyboard_arrow_down
attach_money
失敗したリクエストに対してトークンは差し引かれますか?
keyboard_arrow_down
attach_money
どのような支払い方法が利用できますか?
keyboard_arrow_down
attach_money
トークンの購入について請求書は発行されますか?
keyboard_arrow_down
attach_money
APIトークンではなく、商用ライセンスを購入するにはどうすればよいですか?
keyboard_arrow_down
attach_money
クレジットカードではなく、請求書または発注書で支払うことはできますか?
keyboard_arrow_down
attach_money
支払いは済ませましたが、残高やレート制限が変わっていません。何をチェックすれば良いでしょうか?
keyboard_arrow_down
attach_money
キャンセル、自動チャージの停止、または保存済みの支払い方法の削除方法を教えてください。
keyboard_arrow_down
