Reader
LM-v2
 Reader API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 エアギャップ
概要
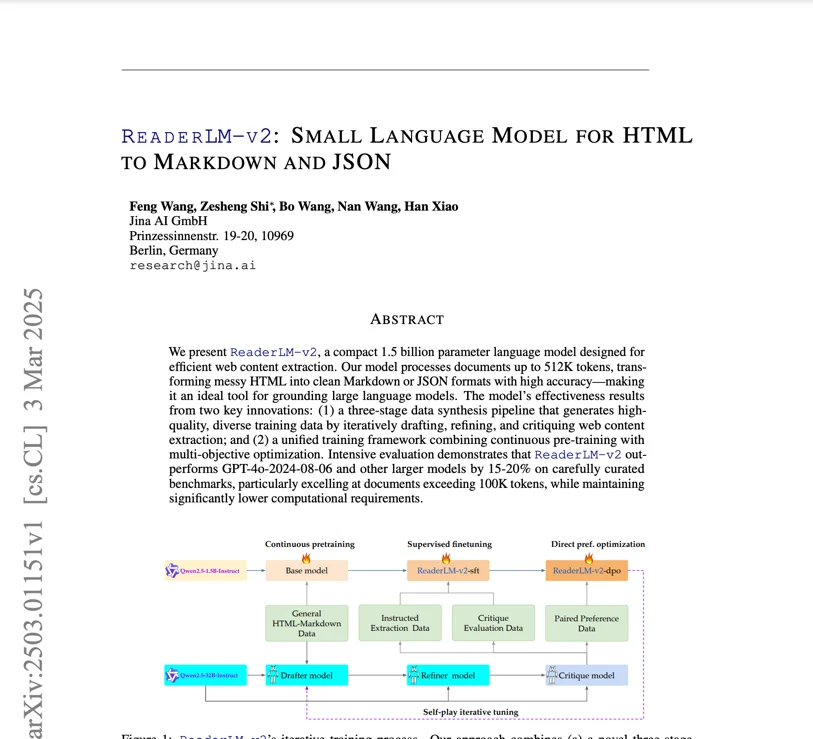
ReaderLM-v2 は 1.54B パラメータの小型言語モデルで、乱雑な HTML を高精度でクリーンな Markdown または JSON に変換し、最大 512K トークンの文書を処理します。大規模言語モデルのグラウンディングに最適なツールで、Web コンテンツを LLM が効率的に消費できる構造化形式に変換します。HTML から Markdown への変換では Qwen2.5-32B-Instruct や Gemini2-flash-expr を上回り、コストはその数分の一で済みます。
手法
このモデルの有効性には 2 つの重要なイノベーションが寄与しています。第一に、3 段階のデータ合成パイプラインが、Web コンテンツ抽出を反復的に下書き・改善・批評することで、高品質かつ多様な学習データを生成します — この合成データアプローチにより、手動アノテーションなしに多様な HTML 構造をモデルが参照できます。第二に、統合学習フレームワークが継続的事前学習と多目的最適化を組み合わせ、HTML から Markdown への変換と HTML から JSON への変換を同時に学習可能にします。'shallow-but-wide'(浅く広い)デコーダーオンリーアーキテクチャ(28 層、隠れ次元 1536、クエリヘッド 12、KV ヘッド 2)は選択的なコピー操作に最適化されています。512K トークンのコンテキストは zigzag-ring-attention により実現されています。対照損失による学習が劣化問題を大幅に軽減します。
パフォーマンス
HTML から Markdown への変換タスクでは、このモデルは ROUGE-L 0.84、Jaro-Winkler 0.82、Levenshtein 距離 0.22 を達成し、Qwen2.5-32B-Instruct と Gemini2-flash-expr を上回っています。HTML から JSON への変換タスクでは、F1 スコア 0.81、パス率 98% で競争力を維持しています。T4 GPU では入力 67 tokens/s、出力 36 tokens/s で処理します。劣化問題(トークンループ、反復出力)は対照損失による学習により大幅に軽減されています。512K トークンのコンテキストウィンドウにより、実世界のほとんどの文書でチャンキングが不要になります。
ベストプラクティス
このモデルは、HTML から Markdown への変換、JSON 抽出、指示追従をデモンストレーションする Google Colab ノートブックを通じて利用できます。HTML から Markdown への変換タスクでは、プレフィックス指示なしで生の HTML を入力してください。JSON 抽出では、プロンプトで対象スキーマを指定してください。create_prompt ヘルパー関数が両タスクのプロンプト作成を容易にします。モデルは Colab の無料 T4 GPU ティアで動作しますが(vllm と triton が必要)、bfloat16 または Flash Attention 2 がない場合は制約があります。本番環境には RTX 3090/4090 を推奨します。AWS SageMaker、Azure、GCP マーケットプレイスで利用可能です。非商用利用向けに CC BY-NC 4.0 で提供されています。RAG パイプラインの前処理ステップとして、jina-embeddings-v5-text-small で埋め込む前に Web コンテンツをクリーンな Markdown に変換するために、このモデルを使用してください。