Embeddings
 Apache 2.0 ライセンス
jina-clip-v1
Apache-2.0 Jina API
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 エアギャップ
概要
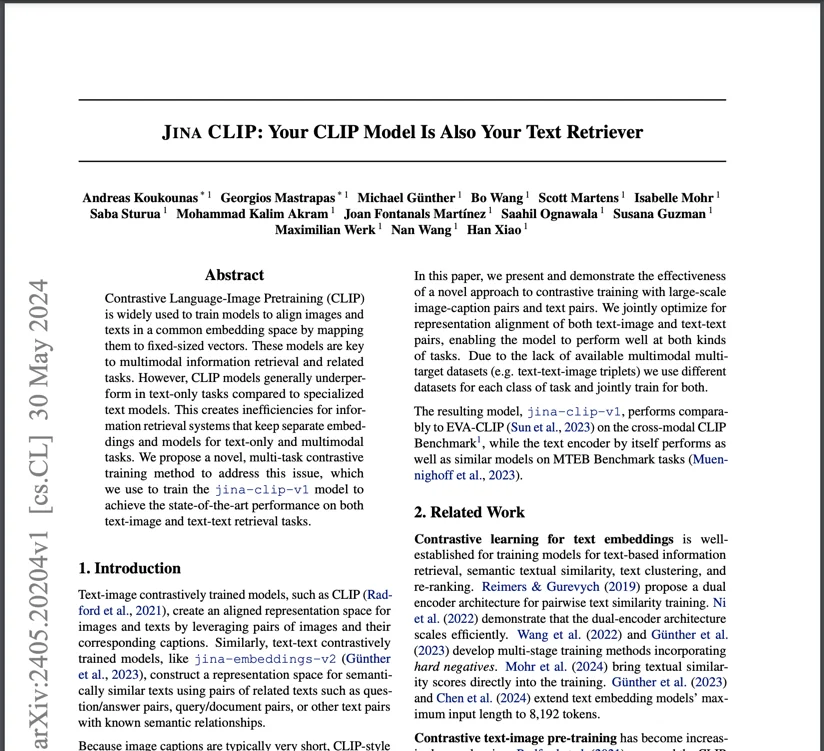
jina-clip-v1 は 223M パラメータのマルチモーダル埋め込みモデルで、テキスト間の検索とテキストから画像の検索の両方で state-of-the-art の性能を達成しました — CLIP ファミリーのモデルとしては初めてです。クロスモーダルアラインメントのためにテキスト単独検索を犠牲にする標準の CLIP モデルとは異なり、jina-clip-v1 はマルチタスク対比学習により、すべての検索組み合わせで高い性能を維持します。テキストコンテキストは 12,288 トークンに対応し、元の CLIP の 77 トークン制限の 100 倍です。
方法
アーキテクチャは、ALiBi により 12,288 トークンに対応する改造済み Jina BERT v2 テキストエンコーダと、Beijing Academy for AI の EVA-02 画像エンコーダを組み合わせています。重要な革新はマルチタスク対比学習手法です:モデルは同時に (1) クロスモーダルアラインメントのための画像キャプションペア、(2) テキスト単独検索品質を維持するためのテキスト間ペア、(3) テキスト長さの変化への頑健性を高める画像の AI 生成長文説明で学習します。最終段階ではハードネガティブなテキストトリプレットを用いて意味的区別を鋭くします。このマルチタスクアプローチにより、標準の CLIP 学習に見られるテキスト単独検索の壊滅的忘却(catastrophic forgetting)を防ぎます。画像エンコーダは 224×224 ピクセルのタイルを処理し、各タイルは 1,000 トークンの処理能力を消費します。
パフォーマンス
テキスト単独検索では、このモデルは OpenAI CLIP に対して 165% の性能向上を達成しました(MTEB で 0.429 vs 0.162)。画像タスクでは:テキストから画像の検索が 2% 向上(0.899)、画像からテキストの検索が 6%(0.803)、画像から画像の検索が 12%(0.916)。ゼロショット画像分類(CIFAR-100)では、標準 CLIP を上回ります。Flickr8k/30k と MSCOCO Captions でのクロスモーダル性能は、特化した単一モダリティモデルと競争力があります。12,288 トークンのテキストコンテキストは、画像とともに長文テキスト文書を検索する上で大きな優位性です。2026 年、jina-clip-v2 が 89 言語対応と 512×512 画像処理によりこのモデルを引き継ぎます。
ベストプラクティス
モデルは 224×224 ピクセルのタイルで画像を処理します。各タイルは 1,000 トークンを消費します。750×500 ピクセルの画像には 12 タイル(12,000 トークン)が必要です。テキストは単語あたり約 1.1 トークンです。マルチモーダルクエリでは、それに合わせてトークン予算を計画してください。モデルは現在英語のみ対応 — 多言語アプリケーションには jina-clip-v2 を使用してください。Jina Embeddings API 経由と、Hugging Face での Apache 2.0 ライセンスによるオープンソースリリースで利用可能です。本番環境では、AWS Marketplace と Azure のデプロイオプションが最適化されたインフラを提供します。クロスモーダル比較にはコサイン類似度を使用してください。新しいマルチモーダルプロジェクトでは、jina-clip-v2(89 言語、512×512 画像、MRL 対応)または jina-embeddings-v4(32K コンテキスト、マルチベクトルモード、コード対応)を優先してください。