Embeddings
 Reranker
jina-colbert-v2
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 エアギャップ
概要
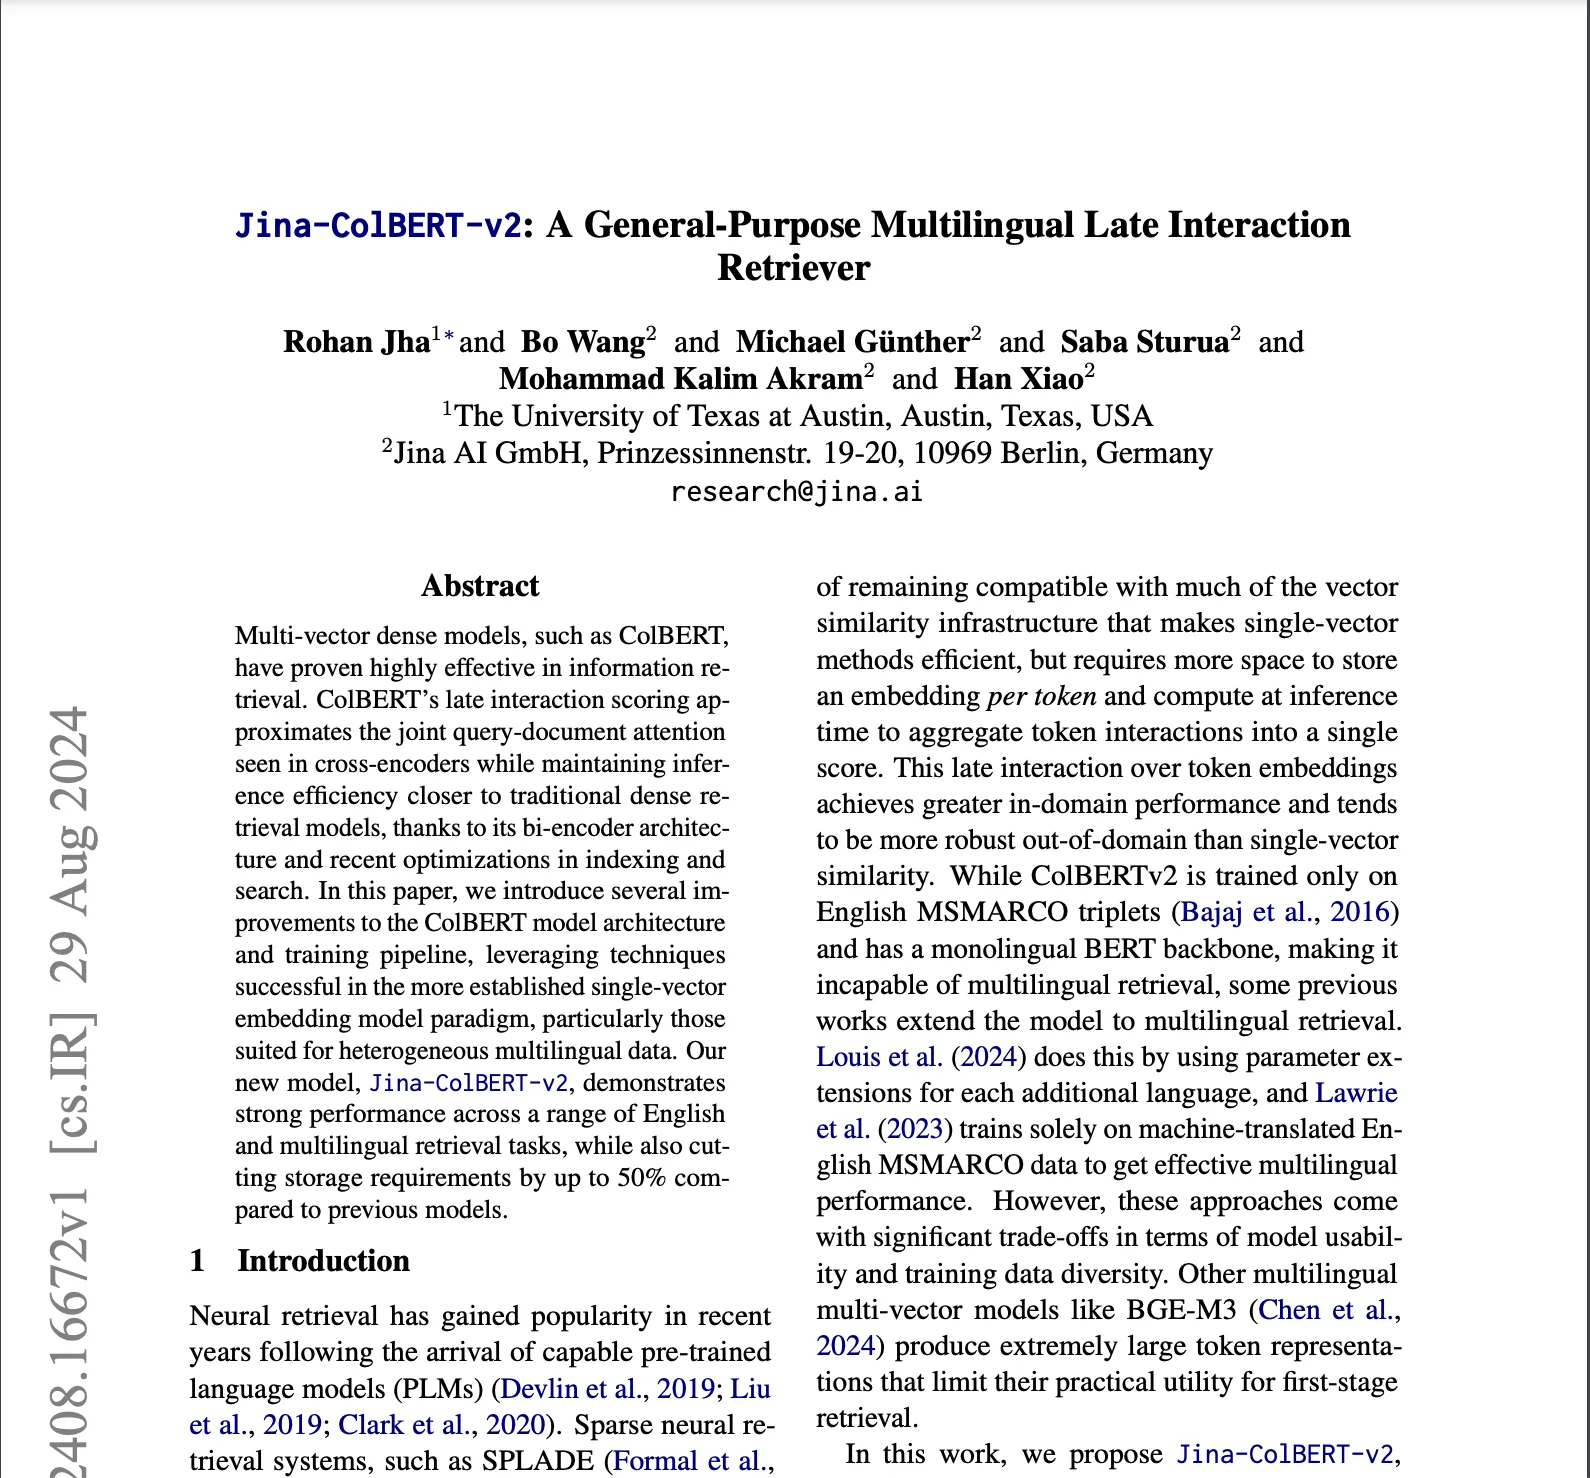
jina-colbert-v2 は 560M パラメータの多言語レイテインタラクション検索モデルで、89 言語をサポートしています。トークン単位のコンパクトな埋め込み(トークンあたり 64–128 次元)を生成する初の多言語 ColBERT 系モデルであり、スケーラブルでコスト効率の高い多言語検索を可能にします。Matryoshka 表現学習により、128 から 64 への次元削減を性能 1.5% の低下のみで実現し、ストレージ要件を半減させます。
手法
モデルは、回転位置埋め込みを強化し Flash Attention で最適化された改変版の XLM-RoBERTa バックボーン(560M パラメータ)を持つ ColBERT レイテインタラクションアーキテクチャに基づいています。学習は 2 つの重要な段階から成ります:(1) さまざまな言語の多様な弱教師ありデータによる初期事前学習、(2) ラベル付きトリプレットデータとより大きな教師モデルからの教師あり蒸留によるファインチューニング。主要な革新はマルチベクトル埋め込みへの Matryoshka 表現学習の実装です:モデルは単一の学習プロセスから 128、96、または 64 次元のトークン単位のベクトルを生成し、再学習なしでの動的ストレージ最適化を可能にします。8,192 トークンの文書コンテキスト(12,288 まで拡張可能)と 32 トークンのクエリ制限は、ALiBi 位置エンコーディングによって管理されています。
パフォーマンス
モデルは英語タスクにおいて元の ColBERT-v2 に対して 6.5% の改善を達成し、14 の BEIR ベンチマークにわたって平均スコア 0.521 を記録しています。MIRACL ベンチマークでは、テストされたすべての言語で従来の BM25 ベースの検索手法を上回り、特にクロスリンガルシナリオで強みを示しています。128 から 64 次元への縮小は、性能の低下をわずか 1.5% に留めながらストレージ要件を半減させます。例えば、64 次元ベクトルで 1 億件の文書を保存する場合、AWS では月額 659.62 ドル、128 次元では 1,319.24 ドルです。モデルの多言語カバレッジ(89 言語)とコンパクトなトークン埋め込みは、グローバル検索アプリケーションに特に適しています。
ベストプラクティス
モデルは最適な性能のために CUDA 対応ハードウェアが必要です。クエリは 32 トークンに制限しながら、最大 8,192 トークン(12,288 まで拡張可能)のドキュメント長をサポートします。本番デプロイでは、Jina Search Foundation API、AWS マーケットプレイス、Azure を通じて利用可能で、Hugging Face には非商用バージョンがあります。実装時には、クエリとドキュメントのどちらを埋め込むかを指定してください — モデルは非対称エンコーディングを使用します。適切なインデックスなしで超大量ドキュメントコレクションをリアルタイム処理するように設計されていません;ANN 検索には FAISS、Qdrant、Weaviate を使用してください。ドメイン固有のタスクには、コーパスでのファインチューニングを検討してください。より高次元の出力を持つ単一ベクトル検索には、jina-embeddings-v4(シングルベクトルモード)または jina-embeddings-v5-text-small を検討してください。