I/O 図

テキスト

jina-embeddings-v3

タスク

ベクトル

パレートフロント
30M100M300M1B3.0B10B30B506070all-MiniLM-L6-v2bge-base-en-v1.5bge-en-iclbge-multilingual-gemma2bge-small-en-v1.5cde-small-v1e5-mistral-7b-instructe5-small-v2EVA-CLIP ViT-B/16granite-embedding-30m-e…GritLM-8x7Bgte-largegte-modernbert-basegte-Qwen2-1.5B-instructgte-smalljina-clip-v1jina-embeddings-v2-base…KaLM-mini-v2.5LaBSELENS-d4000LENS-d8000Linq-Embed-MistralLongCLIP ViT-B/16multilingual-e5-basemultilingual-e5-large-i…multilingual-e5-smallOpenAI CLIP ViT-B/16Qwen3-Embedding-0.6BSFR-Embedding-Mistralsnowflake-arctic-embed-lsnowflake-arctic-embed-…static-retrieval-mrl-en…stella_en_1.5B_v5stella_en_400M_v5UAE-Large-V1jina-embeddings-v3パラメータ数(対数)score
このモデル
フロント上
Jina AI
その他
MTEB English
65.52
パラメータ
572M
スコア順位
15 / 52
パレートフロント
フロント外
値の分布
AUC 0.8525
コーパス
翻訳ペア
ドキュメント検索
コード
タスク
default
classification
retrieval.passage
retrieval.query
retrieval.query → retrieval.passage
separation
text-matching
0.7410.200.400.600.80
関連21.8%
ハードネガティブ3.0%
無関係1.0%
推奨しきい値
FPR 0.1 · 0.618
FPR 0.01 · 0.741
FPR 0.001 · 0.797
FPR 0.0001 · 0.824
バランス · 0.597
AUC
0.8525
ノイズ上限
0.791
再現率の急落点
0.385
測定ペア数
119 / 11k
ベクトル成分
-0.25-0.010.23
σ 0.0312 · 244k 個の値
埋め込みの幾何
01024
次元ごとの平均。カーソルを合わせると範囲を表示
ノイズ下限
0.496
実効次元数
54 / 1024
次元の切り詰め
32641282565121024
classification · 要求した次元数ごとのしきい値
言語ペア
de-rude-zhen-deen-jaen-koen-ruen-zhja-ko
ペア間のしきい値のばらつき:0.072
比較するモデルを選択
論文 (4)

概要

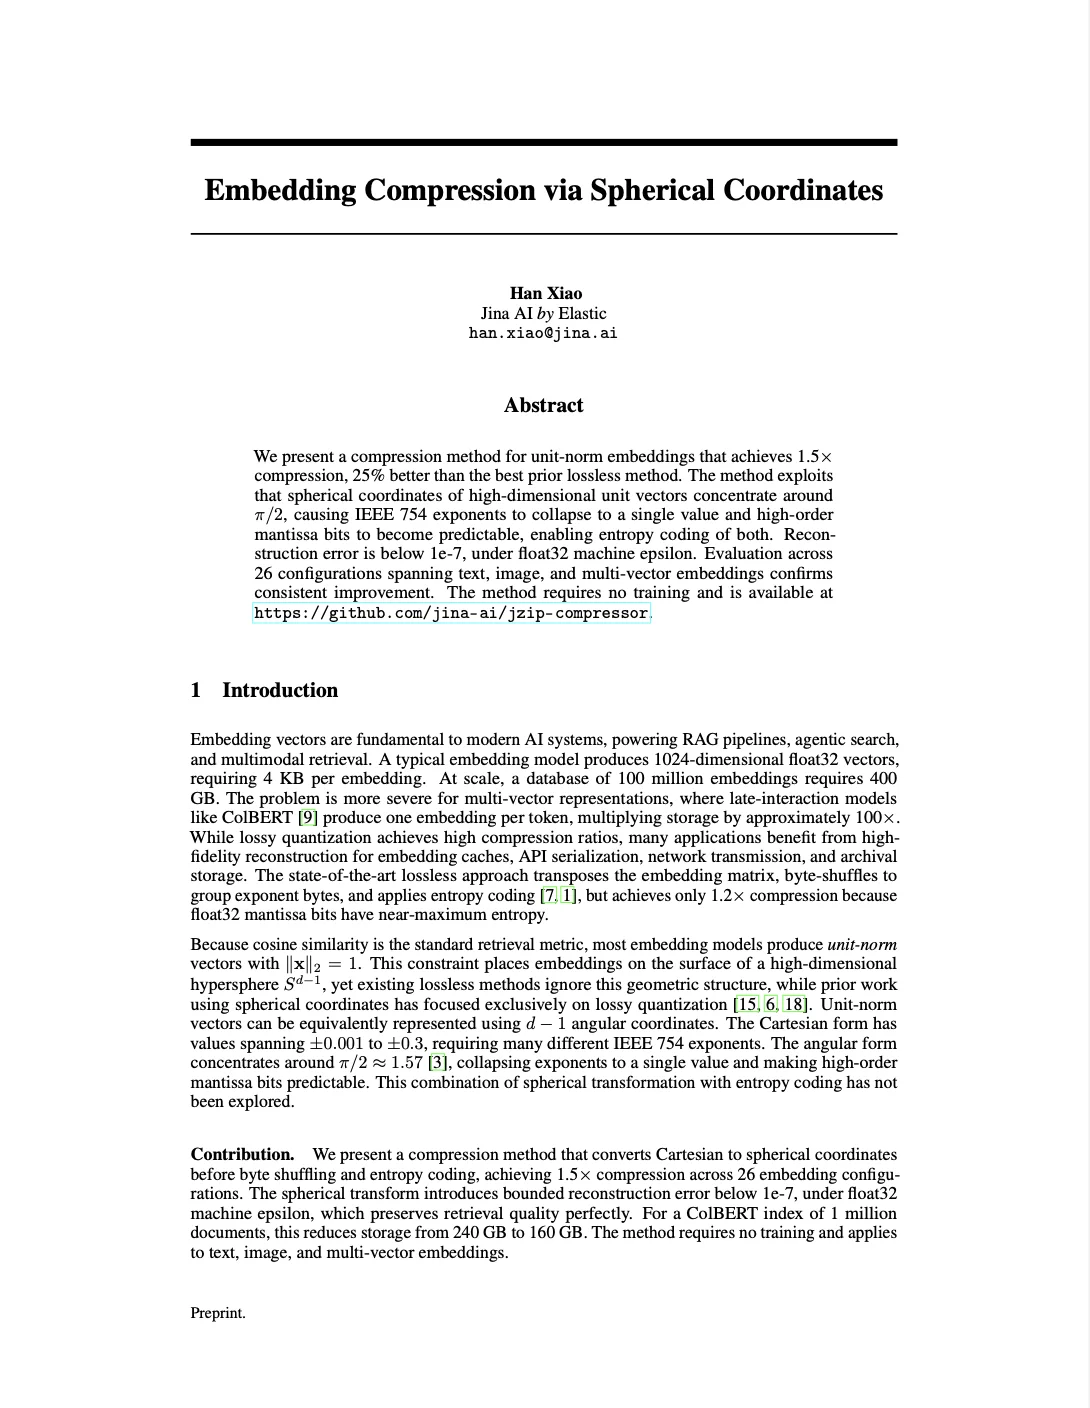
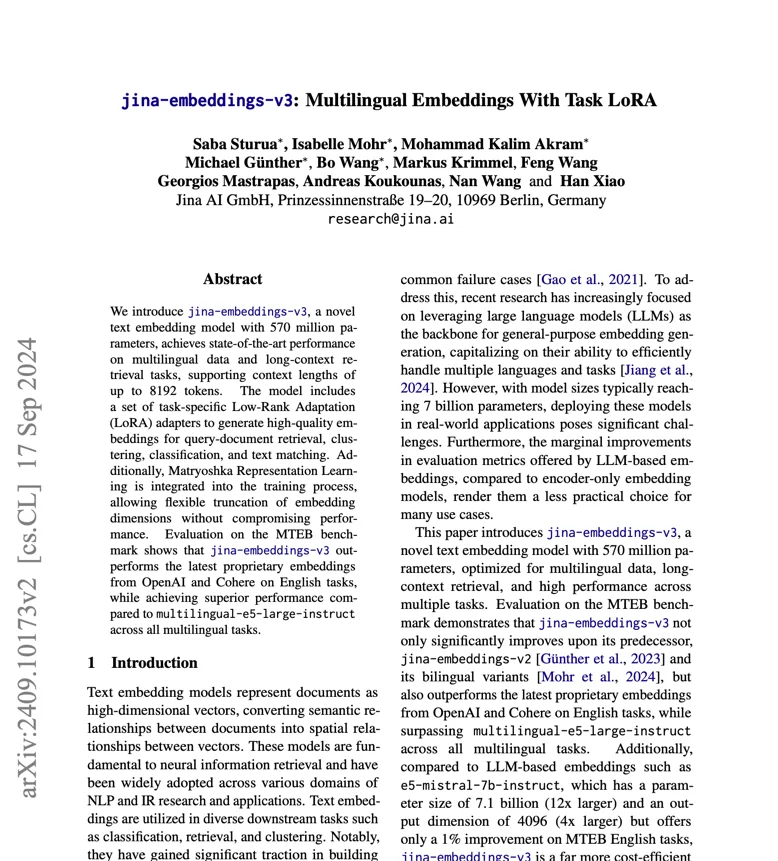
jina-embeddings-v3 は 570M パラメータの多言語テキスト埋め込みモデルで、89 言語と 8,192 トークンのコンテキストウィンドウをサポートします。その特徴的な革新はタスク固有 LoRA アダプタの使用です:同じ 570M バックボーンが軽量アダプタ重みの切り替え(それぞれ 60M パラメータ未満)により、検索、分類、クラスタリング、テキストマッチング用に最適化された埋め込みを生成します。リリース時に SOTA の MTEB 性能を達成し、英語タスクで OpenAI と Cohere のプロプライエタリ埋め込みを上回りました。

手法

モデルは 24 層の Transformer を持つ jina-XLM-RoBERTa バックボーンに基づいており、チューニングしたベース周波数の RoPE(Rotary Position Embeddings)を用いて、最大 8,192 トークンまでの長コンテキスト外挿を可能にしています。訓練は 3 段階のカリキュラムに従いました:(1) 89 言語での多言語事前学習、(2) ペアテキストデータセットでの対照ファインチューニングによるベース埋め込み品質の確立、(3) タスク固有 LoRA アダプタの訓練。各 LoRA アダプタは総パラメータ数に 3% 未満を追加しながらモデルを特定のタスクに特化させます:非対称検索用の retrieval.query と retrieval.passage、クラスタリング用の separation、分類用の classification、意味的類似度用の text-matching。Matryoshka Representation Learning(MRL)により、64 次元で検索品質の 90% 以上を維持しながら、埋め込みを 1024 から 32 次元に切り詰められます。コンテキストウィンドウを超える文書では、レイトチャンキングがサポートされます。

パフォーマンス

MTEB で、jina-embeddings-v3 は全タスクで平均スコア 65.52 を達成し、分類(82.58)と文類似度(85.80)で特に強い結果を出しました。多言語タスクすべてで multilingual-e5-large-instruct を上回り、英語タスクで e5-mistral-7b-instruct(パラメータ数 12 倍)に勝利しました。多言語 MTEB では 64.44 を記録し、89 言語にわたって一貫した性能を示しました。MRL 切り詰めは、完全な 1024 に対して 64 次元で検索性能の 92% を維持しました。2026 年、jina-embeddings-v5-text-small がほとんどのワークロードでこのモデルに取って代わり、32K コンテキストと、パラメータあたりより高い精度をもたらす蒸留ベースの学習を提供します。

ベストプラクティス

タスクに応じた適切な LoRA アダプタを選択してください:retrieval.query/retrieval.passage は検索用、separation はクラスタリング用、classification は分類用、text-matching は意味的類似度用。8,192 トークンを超える文書には `late_chunking パラメータを使用してください。256 または 512 次元への Matryoshka 切り詰めはストレージ制約のあるインデックスに適しています。リランキングには完全な 1024 次元を使用してください。本モデルは本番のスループットに CUDA 対応 GPU が必要です。新しい多言語プロジェクトには jina-embeddings-v5-text-small`(32K コンテキスト、蒸留による学習、より高い精度)を優先してください。本モデルはテキスト生成や複雑な推論向けには設計されておらず、テキストではなく埋め込みを生成します。

このモデルについて言及しているブログ
3月 06, 2026 • 6 分で読めます
生の数値から埋め込みモデルを特定する
生の数値を読み取ることで埋め込みモデルをフィンガープリント化する、小さな Transformer。特徴量エンジニアリングは不要。
2月 19, 2026 • 7 分で読めます
jina-embeddings-v5-text: 新しい SOTA 小型多言語ベクトルモデル
<input> 1B 未満の最高の性能を誇る 2 つの多言語対応ベクトルモデル(Embeddings)が、Elastic Inference Service、Llama.cpp、および MLX で利用可能になりました。 </input>
9月 04, 2025 • 6 分で読めます
Jina Code Embeddings: 0.5B および 1.5B で SOTA のコード検索を実現
コード生成LLM → コードのベクトルモデル:0.5B/1.5Bのモデルが25のコード検索ベンチマークでSOTA(最高性能)を達成。
7月 25, 2025 • 8 分で読めます
JinaVDR:20言語で95のタスクを網羅した新しいVisual Document Retrievalベンチマーク
JinaVDRは、視覚的なドキュメント検索のための新しいベンチマークであり、20言語にわたる95のタスクを網羅しています。近日中にMTEBで公開予定です。
7月 04, 2025 • 13 分で読めます
DeepResearchにおける多様なクエリ生成のための劣モジュラ最適化
DeepResearchにおいてクエリの多様性が重要であることは広く知られていますが、劣モジュラ最適化を通じてそれを厳密に解決する方法を知っている人はほとんどいません。