Embeddings
 Qwen Research License
jina-embeddings-v4
Qwen Research License GGUF
 Jina API
 Hugging Face
 エアギャップ
概要
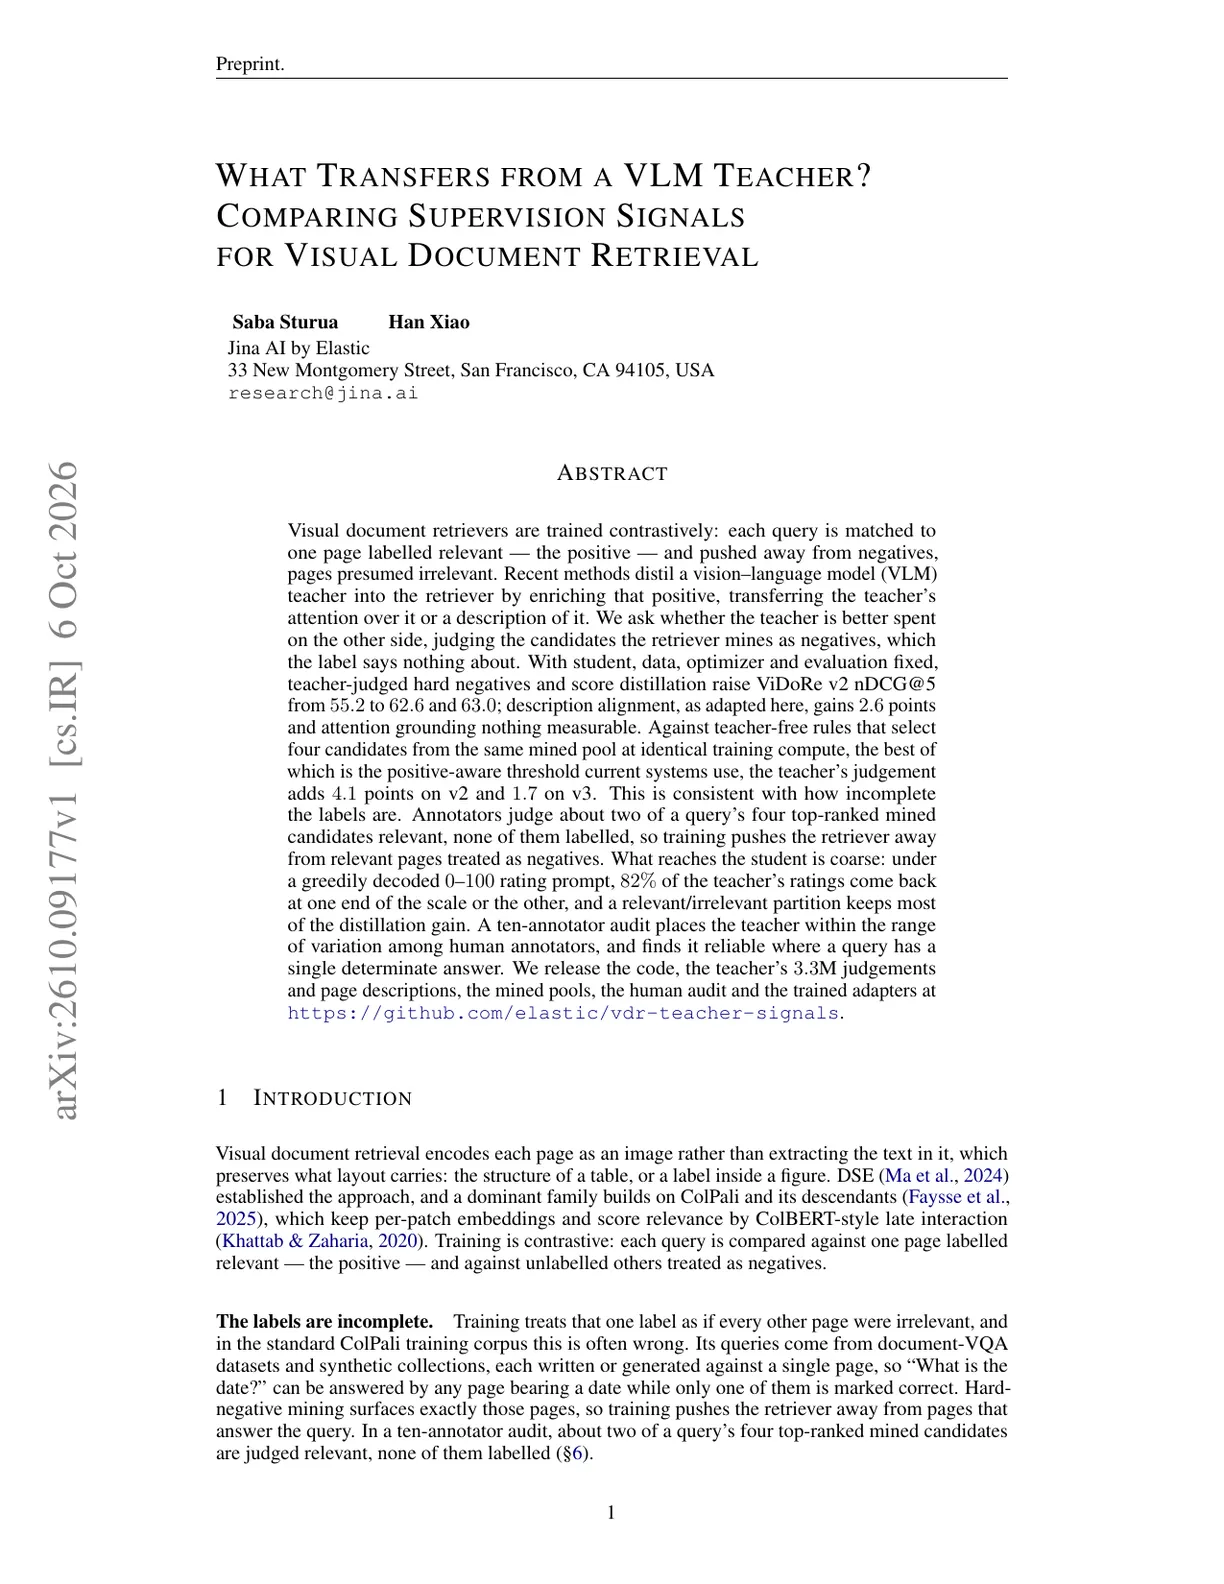
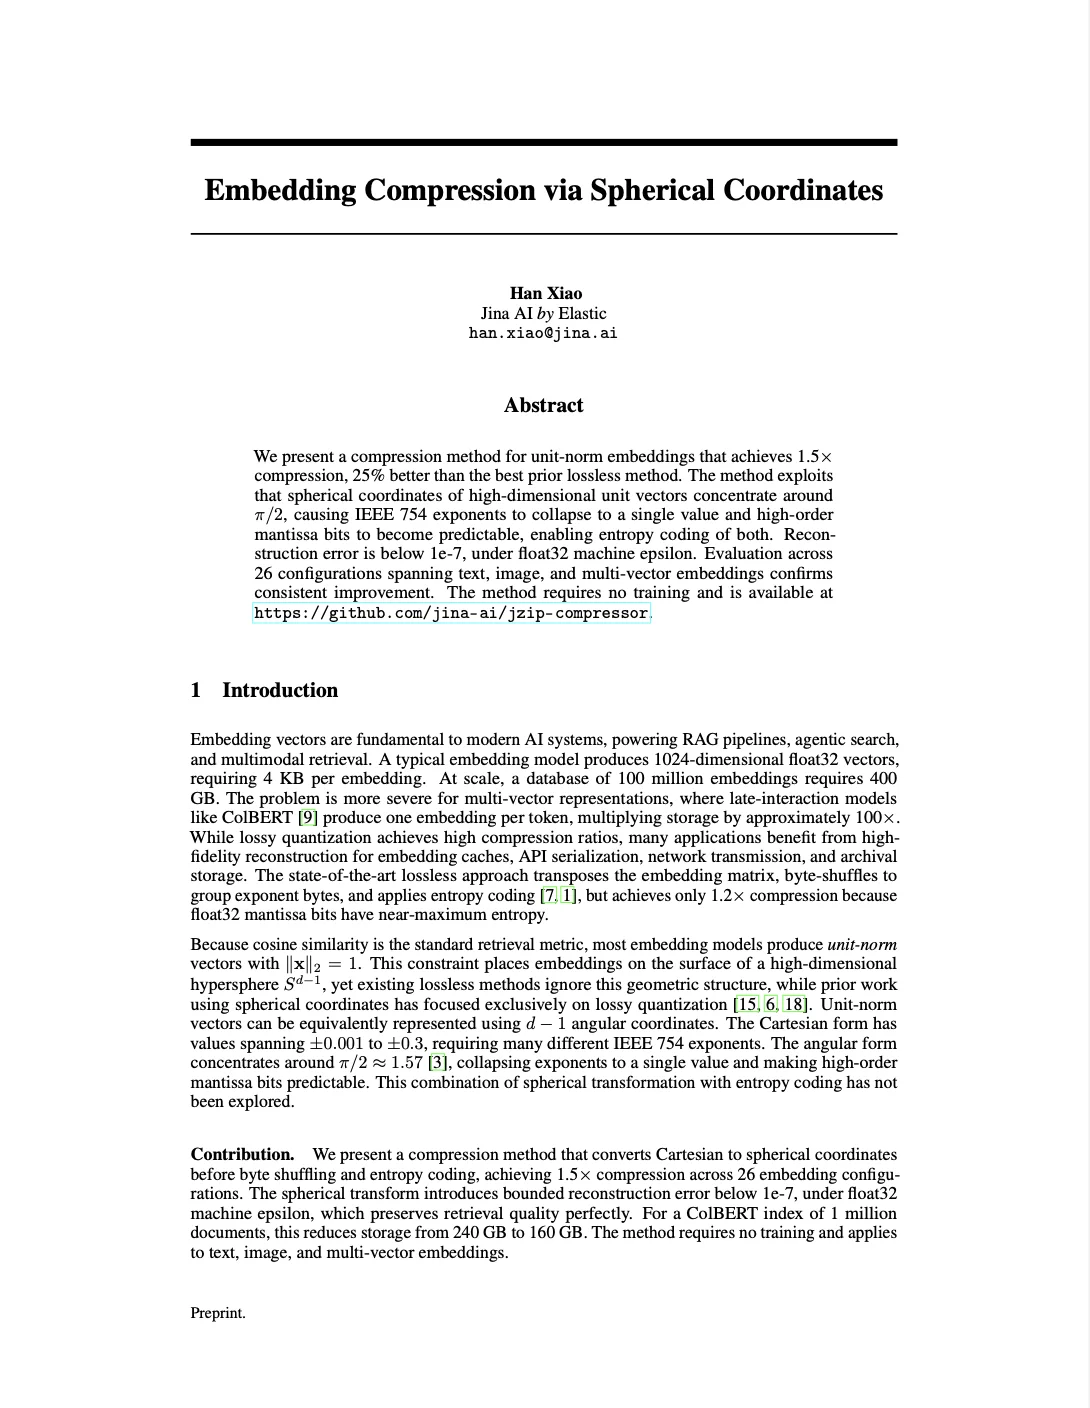
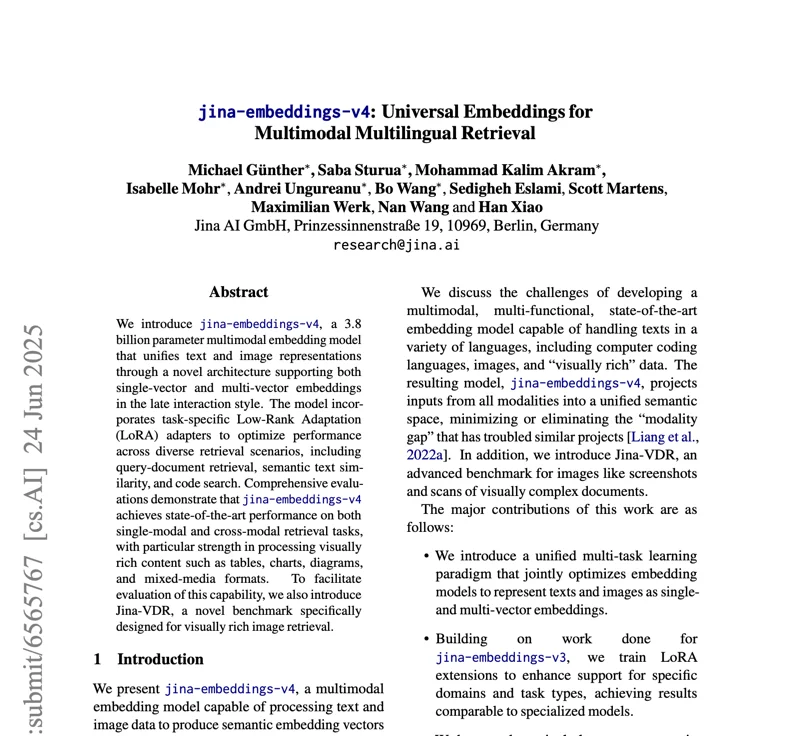
jina-embeddings-v4 は 3.8B パラメータのマルチモーダル埋め込みモデルで、テキストと画像の表現を単一のアーキテクチャに統合します。単一ベクトル(dense)とマルチベクトル(レイテインタラクション/ColBERT スタイル)の両方の出力モードを独自にサポートし、モデルを切り替えずにインデックス効率と検索精度のトレードオフが可能です。視覚情報の多い文書検索で SOTA 性能を達成し、表、チャート、図、混合メディア形式をネイティブに処理します。
手法
アーキテクチャは大きなトランスフォーマーエンコーダバックボーンと Qwen2.5-VL ベースのビジョンエンコーダーを組み合わせ、テキスト(最大 32K トークン)と画像(768×28×28 パッチ)を共有アテンション層で処理します。3 つのタスク固有 LoRA アダプタ(それぞれ 60M パラメータ)はモデルを以下に特化させます:非対称クエリ-文書検索、意味的テキスト類似度、コード検索。デュアル出力設計が中核の革新です:モデルは高速な ANN インデックス向けの単一の 2048 次元 dense ベクトル(Matryoshka 切り捨てで 128 次元まで短縮可能)または、レイテインタラクションスコアリング用の 128 次元トークンレベルベクトルのセットを生成できます。訓練は 2 段階のカリキュラムを使用しました:テキスト-画像とテキスト-テキストのペアに対する同時対照事前学習に続いて、タスク固有 LoRA アダプタを訓練します。32K トークンのコンテキストウィンドウを超える文書では、レイトチャンキングがサポートされます。Qwen Research License が適用されます。
パフォーマンス
JinaVDR(Visual Document Retrieval)では、モデルは平均 72.19 を記録し、ColPali-v1.2 の 64.50 を上回っています。ViDoRe では平均 84.11(マルチベクトルモードでは 90.17)で、ColPali の 83.90 を上回ります。クロスモーダル検索は CLIP ベンチマークで 84.11 を達成し、jina-clip-v2(81.12)と nllb-clip-large-siglip(83.19)を上回っています。テキスト検索スコア:MTEB-en で 55.97、MMTEB で 66.49、LongEmbed で 67.11(jina-embeddings-v3 は 55.66)。意味的類似度は英語 STS で 85.89、多言語 STS で 72.70。コード検索は CoIR で 71.59。クロスモーダルアラインメントはコサイン類似度 0.71(OpenAI CLIP は 0.15)に達します。マルチベクトルモードは視覚情報の多いタスクで常にシングルベクトルモードを上回り、シングルベクトルモードは標準的なテキスト検索で効率的な性能を提供します。
ベストプラクティス
パイプラインに基づいて出力モードを選択してください:大規模 ANN インデックスにはシングルベクトル(Matryoshka 切り捨てで 128–512 次元が利用可能)、視覚情報の多い文書の top-k 候補の再ランキングにはマルチベクトル。API のタスクパラメータで LoRA アダプタを選択してください:クエリ-文書検索は 'retrieval'、意味的類似度は 'text-matching'、コード検索は 'code'。32K トークンを超える文書には `late_chunking を使用してください。LoRA アダプタごとの 60M パラメータオーバーヘッドは無視できるほど小さく(メモリ増加は 2% 未満)、3 つすべてのアダプタを同時にロードできます。モデルは Qwen Research License の下で提供されています(非商用利用のみ、商用ライセンスの提供はありません)。本番デプロイには CUDA 対応 GPU を使用してください;モデルは Jina API、AWS、Azure、GCP マーケットプレイスで利用可能です。テキストのみのワークロードには、計算コストを大幅に抑えながらパラメータあたりの精度を高める jina-embeddings-v5-text-small` が適しています。