Embeddings
jina-embeddings-v5-omni-nano
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Hugging Face
 MacOS
 エアギャップ
概要
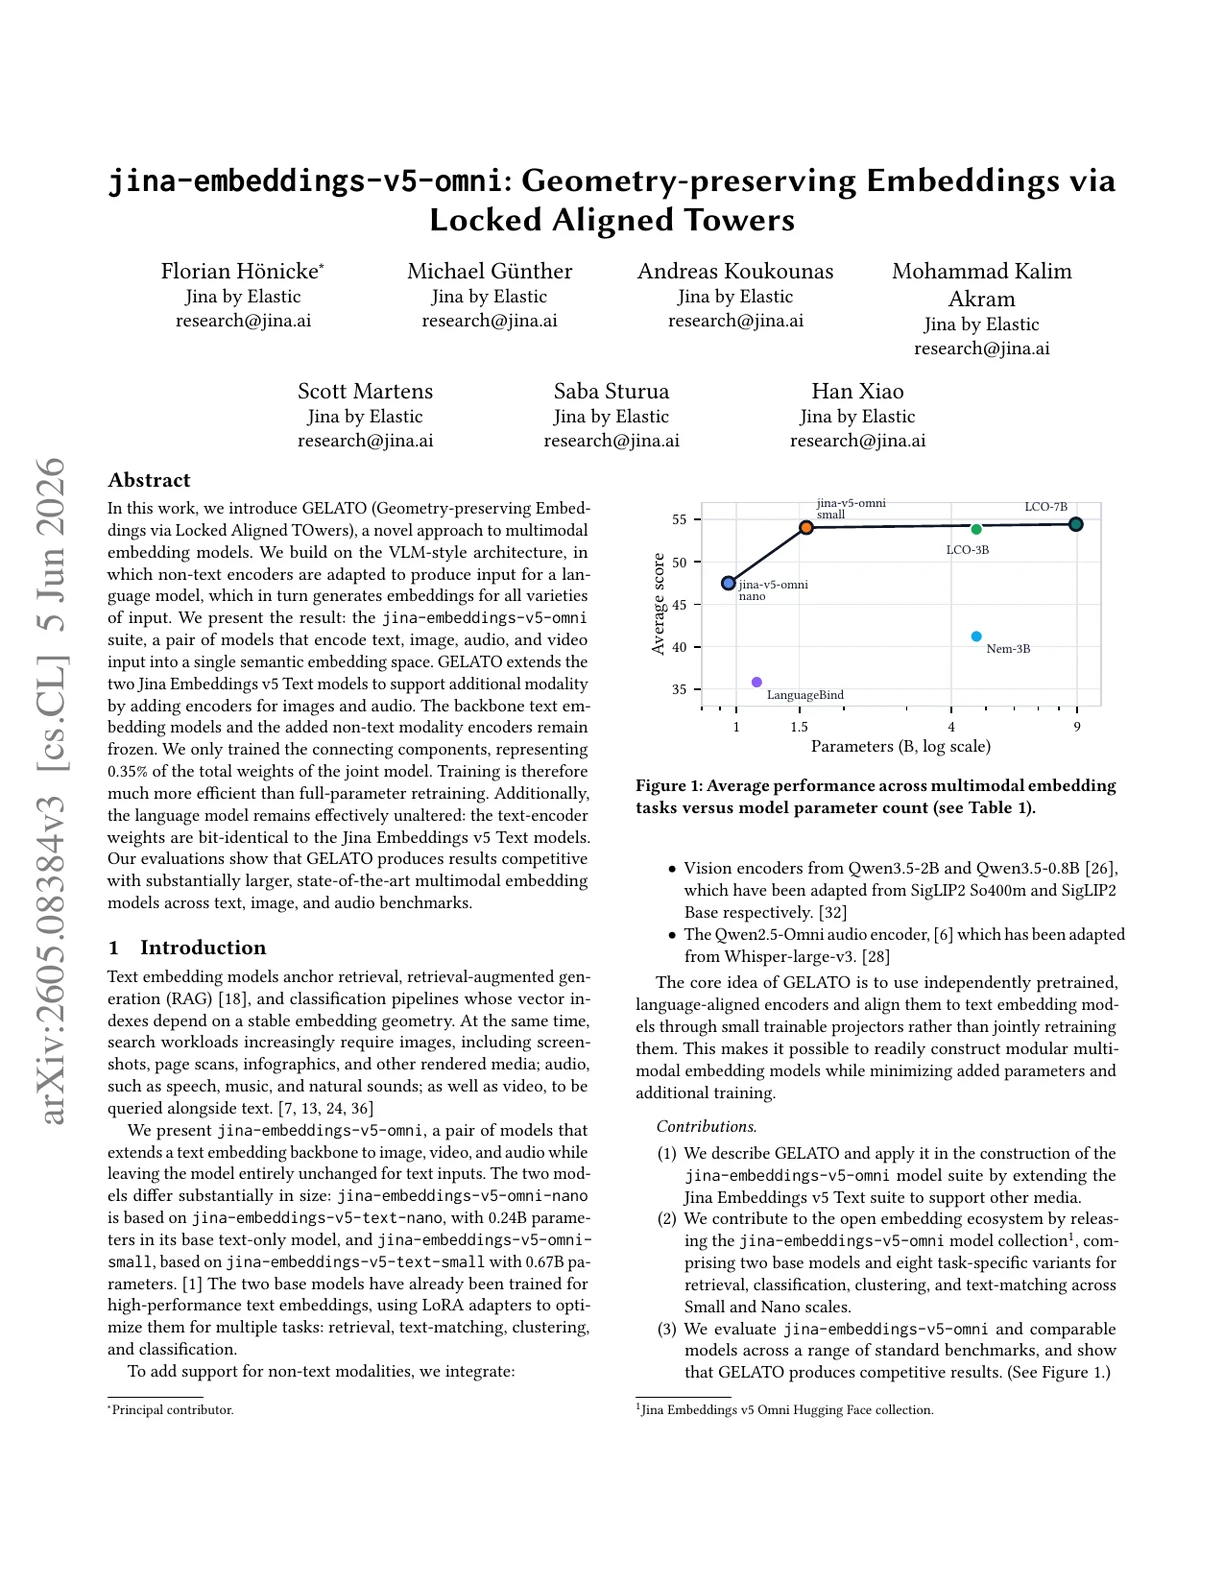
jina-embeddings-v5-omni-nano は約 1.04B パラメータのマルチモーダル埋め込みモデルで、テキスト、画像、動画、音声を受け付け、共有ベクトル空間で埋め込みを生成します。v5-omni 一族のコンパクトなバリアントで、GPU が利用できないエッジや一般ハードウェア向けに設計されています。テキスト専用の出力は jina-embeddings-v5-text-nano とビット同一であり、テキスト専用からマルチモーダルへのドロップインアップグレードを再インデックスなしで実現します。
方法
モデルは jina-embeddings-v5-text-nano にマルチモーダル機能を付加する第3段階の訓練で拡張されます。EuroBERT-210M テキストバックボーンと4 つのタスク固有 LoRA アダプターは凍結され、新規に訓練されるのはクロスモーダル投影器のみです。SigLIP2 Base ビジュアルエンコーダーが画像と動画を処理し(動画ごとに 32 フレームを均一サンプリング)、Whisper-large-v3 音声エンコーダーが音声入力を処理します。PDF ページは画像としてレンダリングされ、視覚経路で処理されます。訓練はクロスモーダルハードネガティブを用いたコントラスト損失を使用し、視覚・音声表現を既存のテキスト埋め込み空間に整列させます。768 次元の出力空間は 32 次元まで Matryoshka 切り捨てをサポートしています。8K トークンのコンテキストウィンドウはテキスト入力をカバーし、画像・音声入力はそれぞれのエンコーダーで処理されます。
パフォーマンス
テキスト専用の性能は jina-embeddings-v5-text-nano(MMTEB タスクレベル平均 65.5、英語 MTEB 71.0)とビット同一です。マルチモーダル性能は、埋め込み空間が 768 次元(1024 に対して)と狭く、テキストバックボーンが小さいため jina-embeddings-v5-omni-small をわずかに下回りますが、テキスト-画像、テキスト-音声、テキスト-動画の検索にわたって強いクロスモーダル整合性を維持しています。モデルは CPU やエッジハードウェア向けに最適化されており、より大きな omni-small モデルが効率的に動けない環境に対応します。クロスモーダル検索品質は、そのサイズクラスにおいて競争力があります。
ベストプラクティス
jina-embeddings-v5-omni-small と同じ利用パターンです:適切な LoRA アダプター(retrieval、text-matching、clustering、classification)を選択し、API 経由で画像 URL、音声ファイル URL、動画ファイル URL、PDF URL を直接渡してください——モデルは各モダリティを適切なエンコーダーにルーティングします。対応する音声フォーマット:WAV、MP3、FLAC、OGG、M4A、Opus。動画入力は 32 フレームの均一サンプリングとして処理されます。単一バッチ内でモダリティを自由に混合できます;埋め込み空間はすべてのモダリティ間で共有されます。比較にはコサイン類似度を使用してください。768 から 32 次元への Matryoshka 切り捨てはサポートされています。テキスト専用の埋め込みは jina-embeddings-v5-text-nano とドロップイン互換です——アップグレード時に再インデックスは不要です。より高い精度を必要とするサーバーデプロイメントには、jina-embeddings-v5-omni-small(1024 次元、より大きなバックボーン)を使用してください。