Embeddings
jina-embeddings-v5-omni-small
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Hugging Face
 MacOS
 エアギャップ
概要
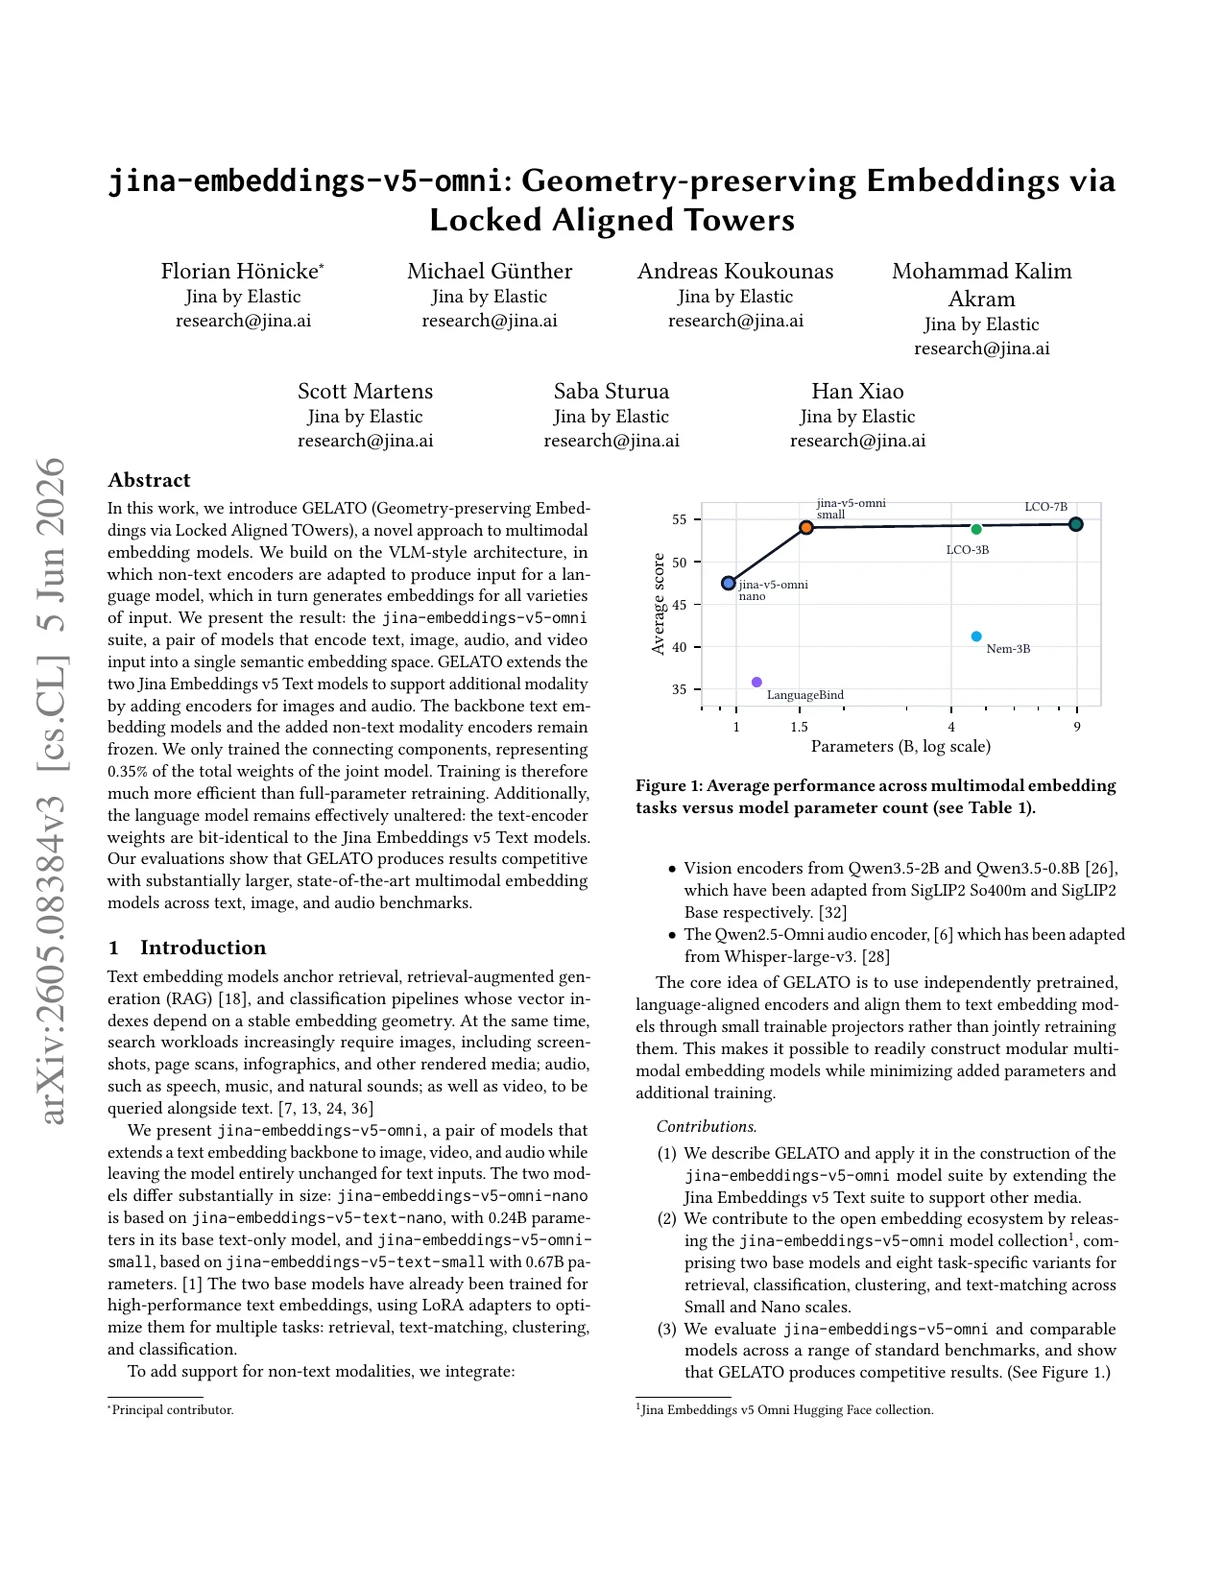
jina-embeddings-v5-omni-small は約 1.74B パラメータのマルチモーダル埋め込みモデルで、テキスト、画像、動画、音声、PDF を受け付け、共有 1024 次元ベクトル空間で埋め込みを生成します。Jina API のデフォルト埋め込みモデルであり、Jina のマルチモーダル埋め込みモデルの中で最も優れた精度-効率のトレードオフを提供します。テキスト専用の出力は jina-embeddings-v5-text-small とビット同一であり、テキスト専用からマルチモーダルへのシームレスな移行を再インデックスなしで可能にします。
方法
モデルは jina-embeddings-v5-text-small を拡張する第3段階で訓練されます。マルチモーダル訓練中は、Qwen3-0.6B-Base テキストバックボーンと4 つのタスク固有 LoRA アダプターすべてが凍結され、新規に訓練されるのはクロスモーダル投影器のみです。SigLIP2 Large ビジュアルエンコーダーが画像と動画を処理し(動画ごとに 32 フレームを均一サンプリング)、Whisper-large-v3 音声エンコーダーが音声入力を処理します。PDF ページは画像としてレンダリングされ、視覚経路で処理されます。訓練はクロスモーダルハードネガティブを用いたコントラスト損失を使用し、視覚・音声表現を既存のテキスト埋め込み空間に整列させます。1024 次元の出力は 32 次元まで Matryoshka 切り捨てをサポートしています。32K トークンのコンテキストウィンドウはテキスト入力をカバーします。モデルは Apple Silicon 向けの量子化推論と MLX 推論をサポートしています。
パフォーマンス
テキスト専用の性能は jina-embeddings-v5-text-small(MMTEB タスクレベル平均 67.0、英語 MTEB 71.7)とビット同一です——マルチモーダル訓練中はテキストバックボーンと LoRA アダプターには手をつけません。クロスモーダル検索では、モデルはテキスト-画像、テキスト-音声、テキスト-動画タスクにわたって強い整合性を示しています。PDF ページ検索は視覚経路で処理されます。omni-small モデルは、サーバーデプロイメント向けに Jina のマルチモーダル埋め込みモデル中で最適な精度-効率のトレードオフを提供し、1024 次元の埋め込みは 768 次元の omni-nano 変種よりも高い識別力を持ちます。
ベストプラクティス
適切な LoRA アダプターを選択してください:retrieval、text-matching、clustering、または classification。API 経由のマルチモーダル入力では、画像 URL、音声ファイル URL、動画ファイル URL、PDF URL を直接渡してください——モデルは各モダリティを適切なエンコーダーにルーティングします。対応する音声フォーマットには WAV、MP3、FLAC、OGG、M4A、Opus が含まれます。動画入力は 32 フレームの均一サンプリングとして処理されます。単一バッチ内でモダリティを自由に混合できます:埋め込み空間はすべてのモダリティ間で共有されます。比較にはコサイン類似度を使用してください。1024 から 32 次元への Matryoshka 切り捨てはサポートされています。テキスト専用の埋め込みは jina-embeddings-v5-text-small とドロップイン互換です——アップグレード時に再インデックスは不要です。GPU なしのエッジ展開には jina-embeddings-v5-omni-nano を代わりに使用してください。