Embeddings
jina-embeddings-v5-text-nano
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Hugging Face
 エアギャップ
概要
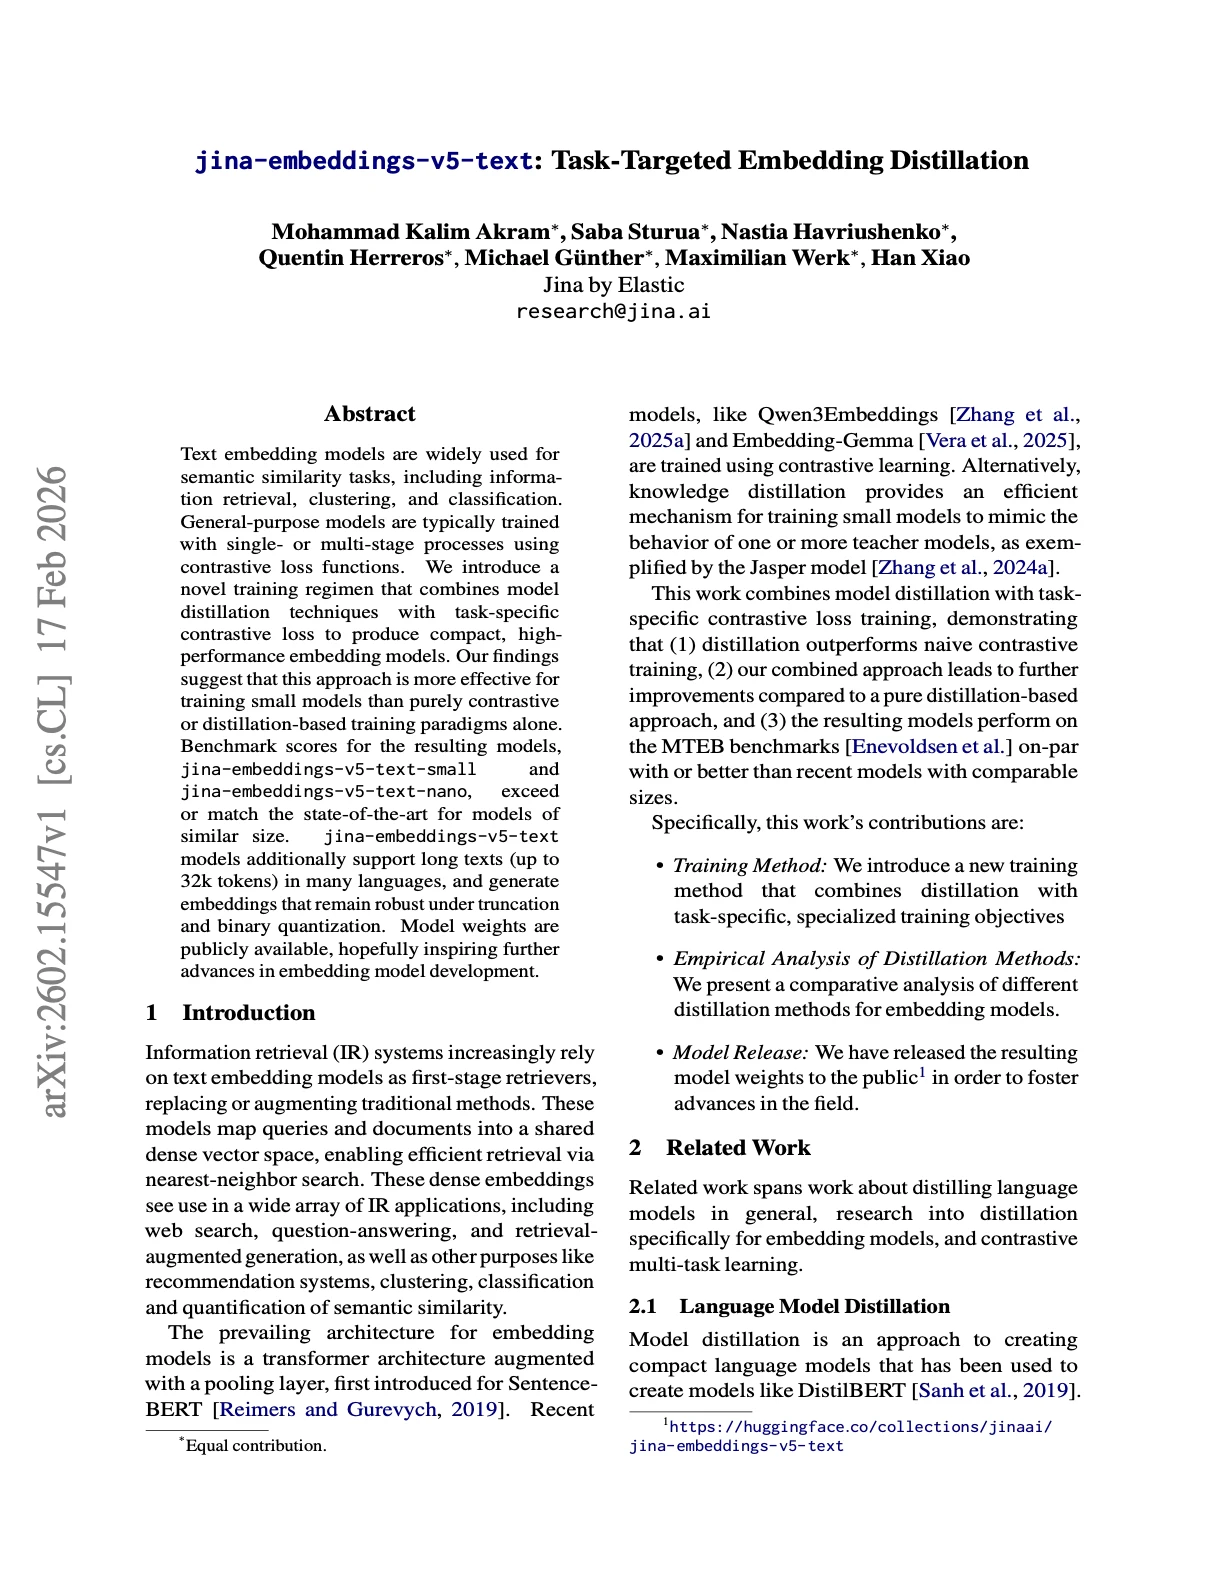
jina-embeddings-v5-text-nano は EuroBERT-210M バックボーン上に構築された 239M パラメータの多言語テキスト埋め込みモデルです。8K トークンのコンテキストをサポートし、Matryoshka 切り捨てで 32 次元まで縮小できる 768 次元の埋め込みを生成し、Jina の 500M 未満の埋め込みモデル群でパラメータあたり最高精度を実現します。GPU が利用できないエッジ展開、レイテンシに敏感なアプリケーション、リソース制約の環境のために設計されています。
手法
モデルは EuroBERT-210M に基づいています。これは主要 15 言語をカバーする多言語データで事前学習されたコンパクトな双方向エンコーダーです。Last-Token-Pooling を用いて最終トークン表現から埋め込みを生成します。訓練は 2 段階の蒸留レシピに従います:まず、より大きな教師モデルからの知識蒸留によって埋め込み品質を転移させ、次にタスク固有の対照損失で検索、テキストマッチング、クラスタリング、分類タスクのファインチューニングを行います。Matryoshka Representation Learning により、サポートされる任意のサイズ(32、64、128、256、512、768)で埋め込み次元を切り捨てながら強い性能を維持できます。Geometric Orthogonal Regularization(GOR)は、バイナリ量子化下の性能劣化を MTEB 検索で 2 ポイント未満に抑えます。8K コンテキストウィンドウにより、チャンキングなしの長文書処理を可能にします。
パフォーマンス
MMTEB(多言語)では、モデルはわずか 239M パラメータでタスクレベル平均 65.5、タイプレベル平均 57.7 を達成し、500M 未満の全モデル(KaLM-mini-v2.5(60.1、494M)、voyage-4-nano(58.9、480M)、Gemma-300M(61.1、308M)を含む)を上回っています。タスクレベルスコア:分類 69.2、クラスタリング 52.7、ペア分類 81.9、リランキング 64.6、検索 63.3、STS 78.2。英語 MTEB では平均 71.0 を達成し、はるかに大きい jina-embeddings-v5-text-small(71.7)にほぼ迫っています。検索特化:MTEB-M 63.26、RTEB 64.08、BEIR 56.06、LongEmbed 63.65。GOR 正則化により、バイナリ量子化下でも埋め込みの堅牢性は保たれます。
ベストプラクティス
適切なタスクプレフィックスを選択してください:非対称クエリ-ドキュメント検索には 'retrieval'、対称類似度には 'text-matching'、グルーピングには 'clustering'、分類には 'classification'。Matryoshka 切り捨てを 256 次元にすると、検索品質の 95% 以上を維持しながらストレージを 67% 削減します。さらなるストレージ削減のためのバイナリ量子化もサポートしています。EuroBERT バックボーンは英語、フランス語、ドイツ語、スペイン語、中国語、日本語、アラビア語、ヒンディー語を含む主要 15 言語で強力なカバレッジを提供します。埋め込みの比較にはコサイン類似度を使用してください。Jina AI API、Hugging Face(Sentence Transformers、vLLM)、llama.cpp 用の量子化バリアントで利用可能です。32K コンテキストやより高い精度が必要なワークロードには、代わりに jina-embeddings-v5-text-small を使用してください。