Reranker
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 エアギャップ
概要
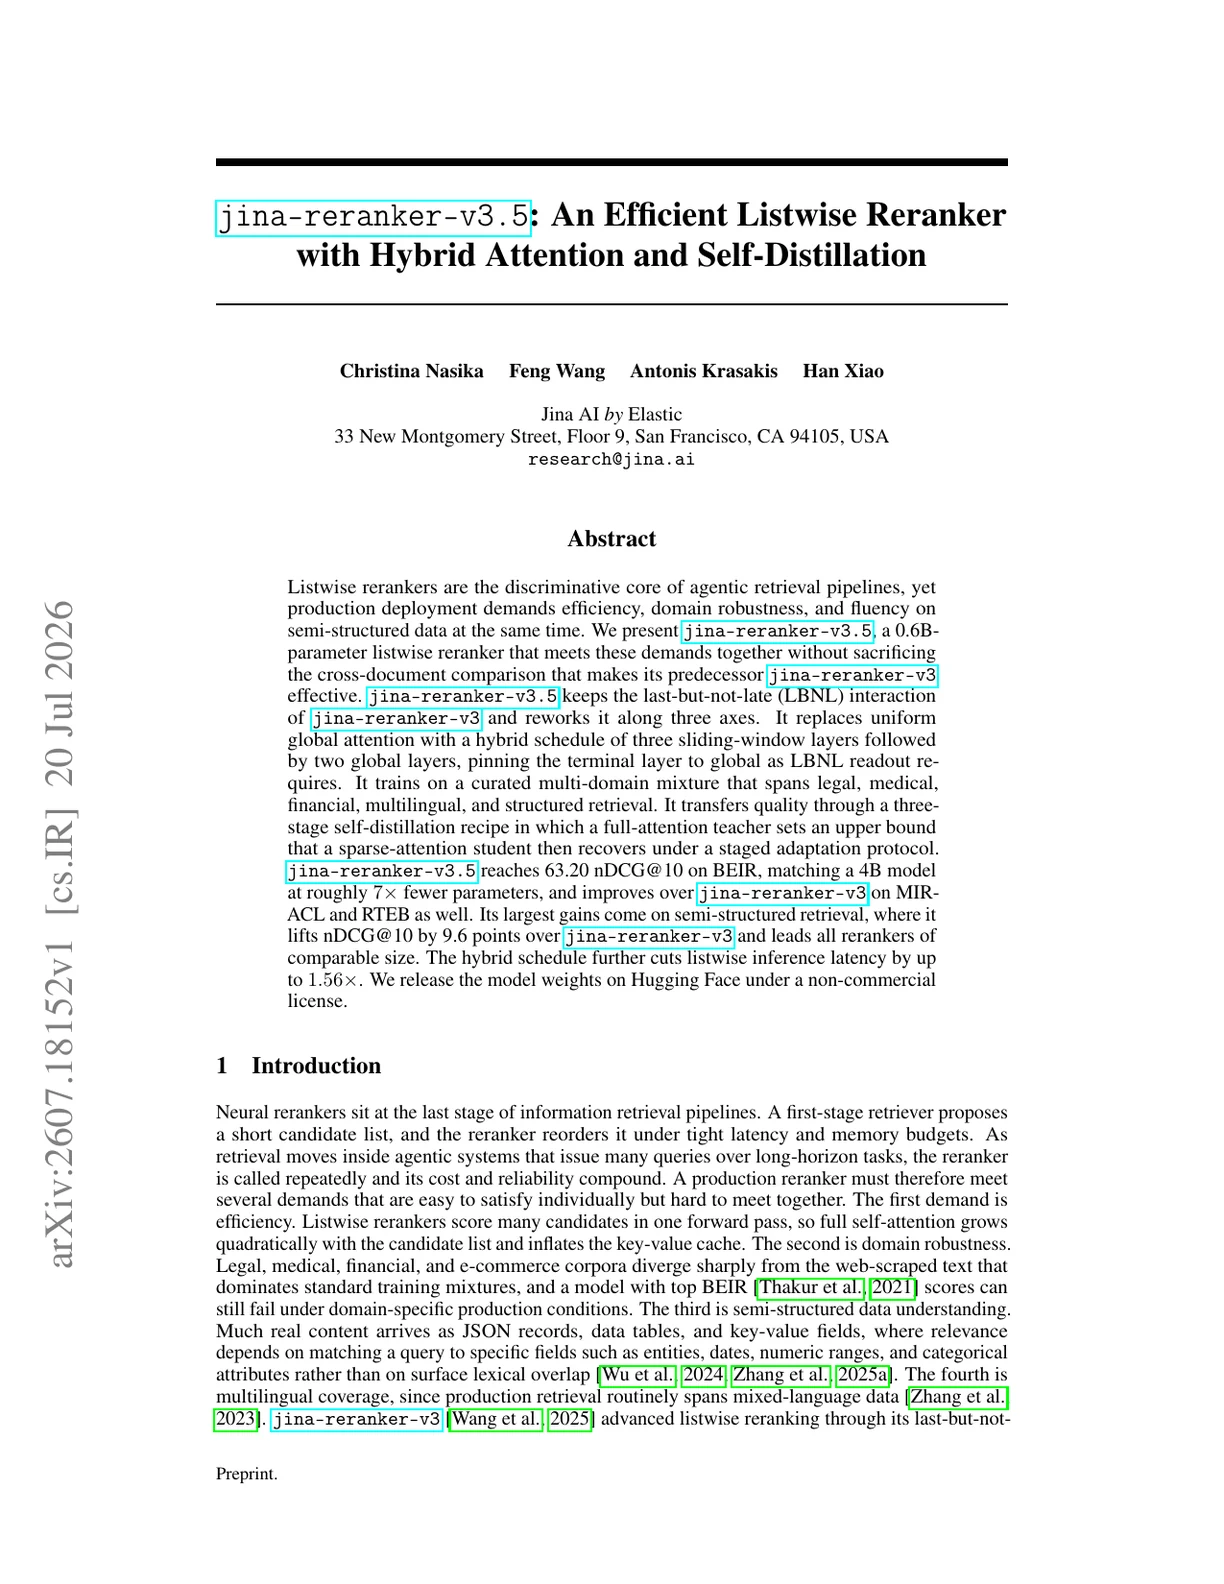
jina-reranker-v3.5 は 0.6B パラメータのリストワイズリランカーで、4B パラメータのモデルに約 1/7 のパラメータ数で匹敵します。ハイブリッドアテンションスケジュール(スライディングウィンドウ層 3 つ + グローバル層 2 つ)と、フルアテンション教師からスパースアテンション生徒へ品質を転移する三段階の自己蒸留レシピを導入します。jina-reranker-v3 のドロップイン代替で、同じ API スキーマを維持しつつ効率とドメインカバレッジを改善します。
方法
アーキテクチャは jina-reranker-v3 の LBNL リストワイズ設計を保持しています:クエリとすべての候補文書が単一のコンテキストウィンドウを共有し、埋め込みは各文書の最終トークンから読み出されます。主要な革新はハイブリッドアテンションスケジュールです。すべての層で均一のグローバルアテンションを用いる代わりに、モデルはスライディングウィンドウアテンション層 3 つ(各位置のアテンションを局所ウィンドウに制限)の後にグローバルアテンション層 2 つを使います。最終層は LBNL 読み出し機構が最終トークンが完全なコンテキストに注意する必要があるため、グローバルアテンションに固定されています。訓練は 3 段階で進行します:(1) フルアテンション教師モデルを、法務・医療・金融・多言語・構造化検索にまたがるキュレーション済みマルチドメイン混合で訓練;(2) スパースアテンション生徒を教師から初期化し、段階的適応でファインチューニングし、ハイブリッドスケジュールを用いる訓練ステップの割合を段階的に増加;(3) 生徒が教師のソフトランキング分布をマッチすることを学ぶ最終蒸留パスで、より低コストなスパースアテンション推論パスを実行しながら教師のランキング品質の 97% 以上を回復します。
パフォーマンス
jina-embeddings-v5-text-small を第一段階の検索器とする統一的なトップ 100 プロトコル下で、モデルは BEIR で 63.20 NDCG{'@'}10、MIRACL で 74.11、RTEB で 70.95、Struct-IR で 48.3 を記録し、jina-reranker-v3(62.10 / 72.20 / 68.01 / 38.7)をすべての軸で上回ります。その BEIR スコアは、パラメータ数が約 1/7 の 4B Qwen3-Reranker(62.28)を僅差で上回ります。v3 からの相対的な伸びは、BEIR +1.10、MIRACL +2.6%、RTEB +4.3%(法務検索で大幅な向上)、構造化データランキング(Struct-IR)で +24.8% です。リストワイズ推論は短いコンテキストから長いコンテキストにかけて v3 より 1.22–1.56 倍速く実行されます(A100、FlashAttention-2)。マルチドメイン訓練混合は、半構造化データ(表、JSON、XML)とドメイン固有コーパスで特に強い向上をもたらします。
ベストプラクティス
jina-reranker-v3.5 は jina-reranker-v3 のドロップイン代替です:リクエストスキーマは不変のため、モデル名の切り替えにコード変更は不要です。クエリを候補リスト全体に対して単一の呼び出しでランキングします——文書を標準の rerank エンドポイントに渡し、戻り結果を制限するには top_n を使うか、文書埋め込みも取得するには return_embeddings を設定します。モデルは構造化データランキング、法務などドメイン固有の検索、多言語コレクションで特に強いです。ハイブリッドアテンション設計により、長い候補リストでもレイテンシが低く保たれます。131K トークンのコンテキストウィンドウはチャンキングなしで非常に長い文書に対応します。Hugging Face で CC-BY-NC-4.0 下で利用可能;商用利用は Jina AI に連絡してください。エアギャップまたはオンプレミス環境向けに、量子化重みも用意されています。第一段階の検索器として jina-embeddings-v5-text-small または jina-embeddings-v4 と組み合わせます。