Reranker
jina-reranker-v3
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 エアギャップ
概要
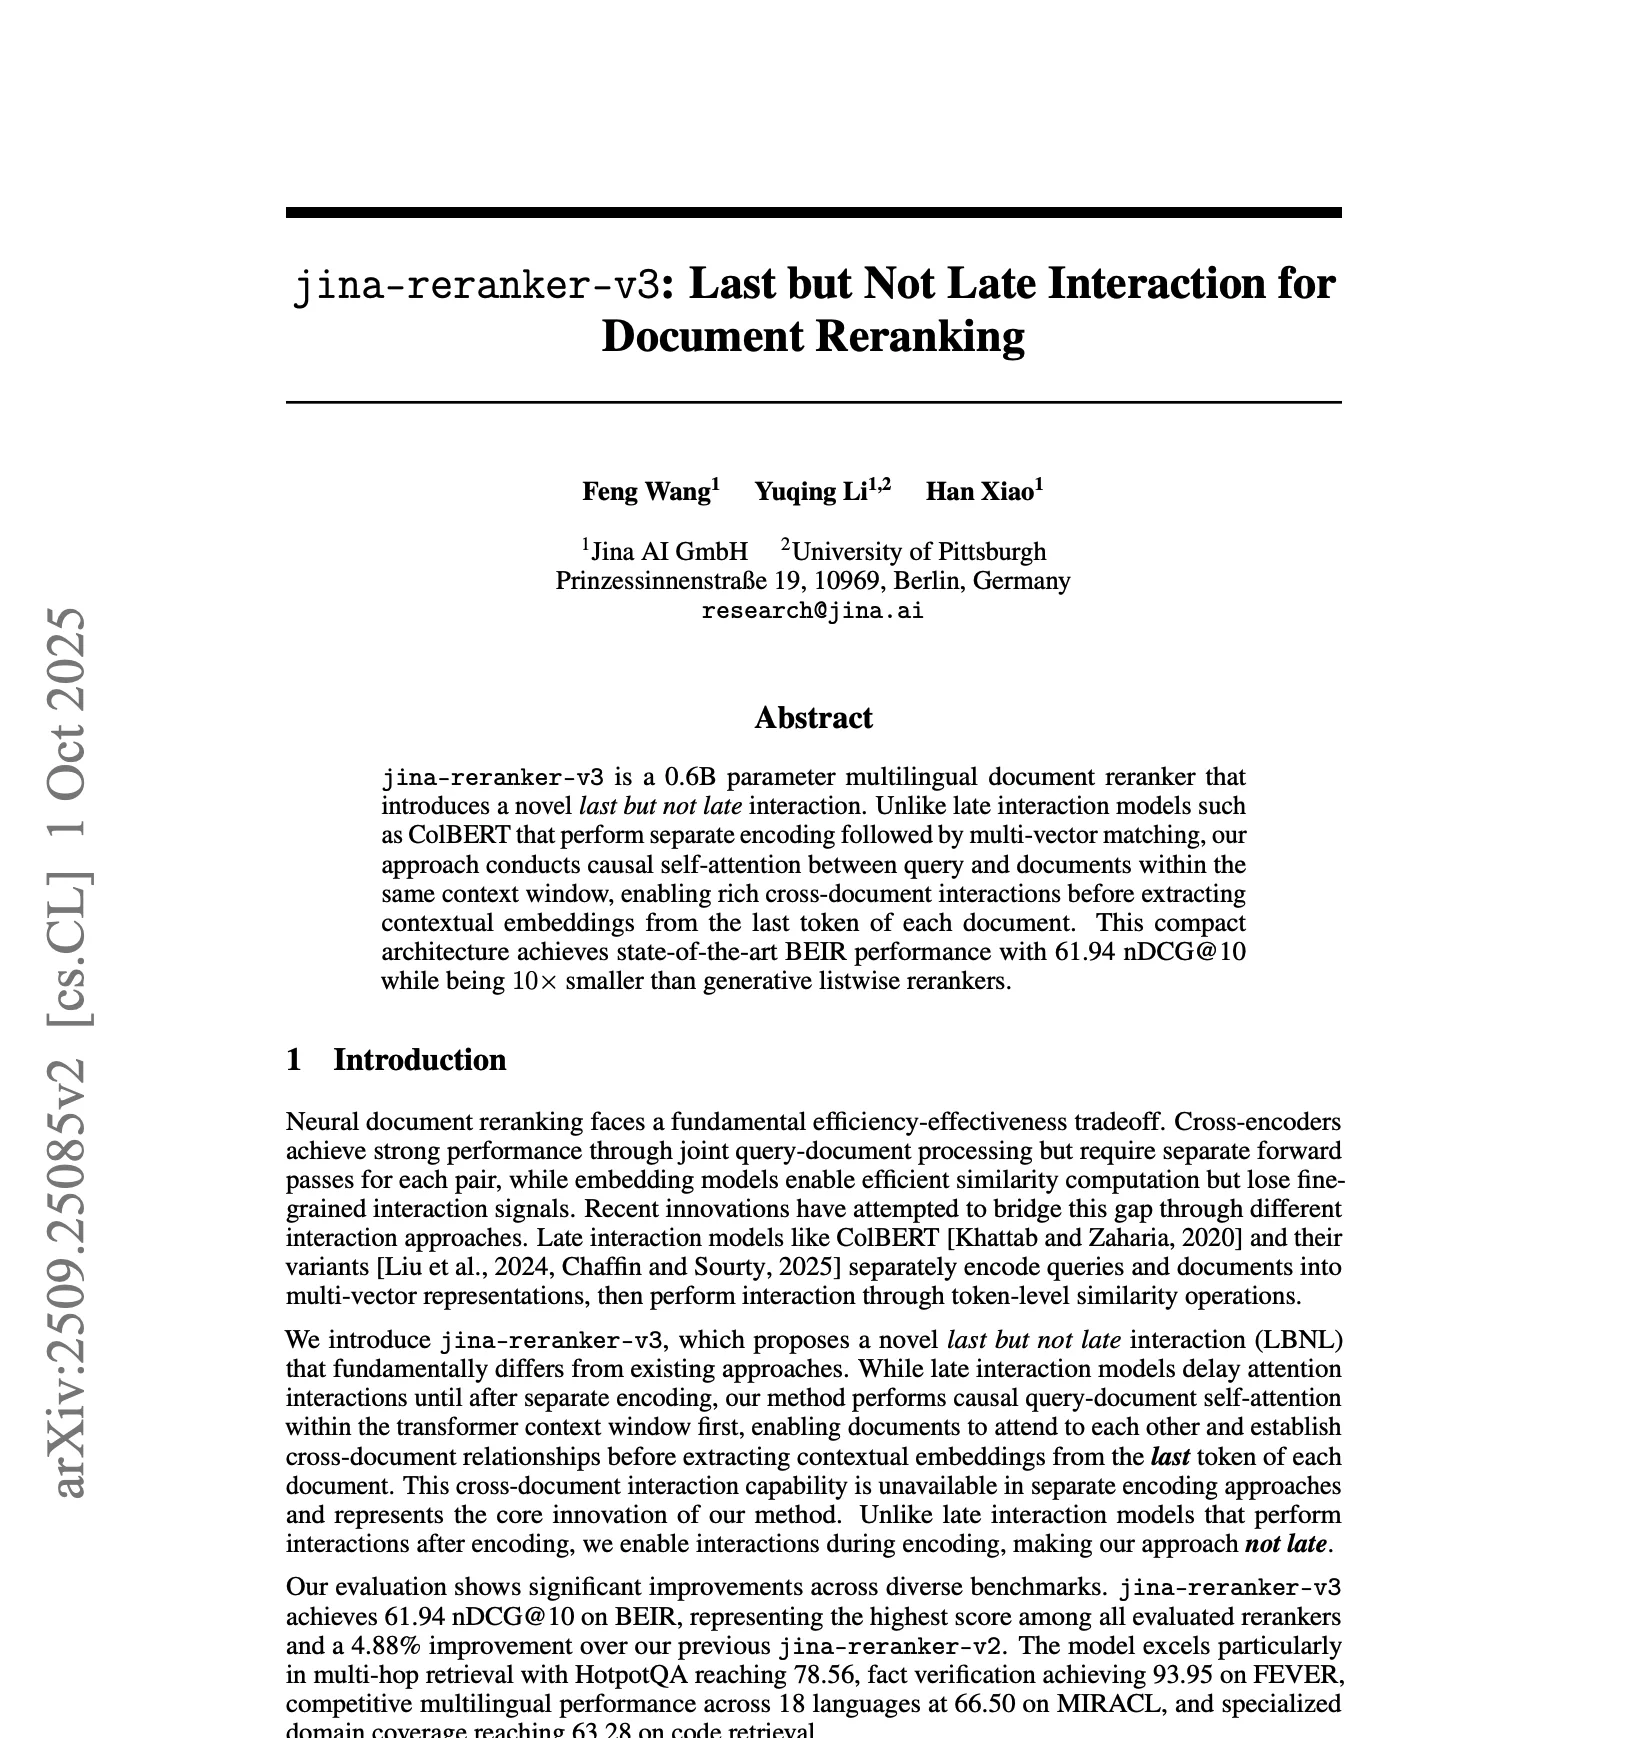
jina-reranker-v3 は 597M パラメータの多言語リストワイズリランカーで、'last but not late'(LBNL)相互作用を導入しています。ペアワイズクロスエンコーダースコアリングからのパラダイムシフトです。各クエリ-文書ペアを孤立して評価するのではなく、単一の 131K トークンのコンテキストウィンドウ内で候補文書のリスト全体を同時に処理し、因果的アテンションによって文書間の関係を捉えます。次点の競合よりパラメータ数を 2.5 分の 1 に抑えながら、SOTA の BEIR 性能(61.94 NDCG{'@'}10)を達成します。
方法
コアとなる革新は LBNL アーキテクチャです。標準のクロスエンコーダーでは、各クエリ-文書ペアが独立してスコアリングされます。レイトインタラクションモデル(ColBERT)では、文書は個別にエンコードされトークン単位で照合されます。LBNL は両方の強みを組み合わせます:クエリとすべての候補文書が単一の因果的アテンションコンテキストを共有するため、モデルは文書間で注意を向け、ペアワイズスコアリングが見逃す相対的な関連性シグナルを捉えることができます。モデルは 1 フォワードパスにつき最大 16 文書(訓練中のポジティブ 1、ネガティブ 15)を処理し、各文書は固定長に切り詰められます。埋め込みは各文書の最終トークンから Last-Token-Pooling を通じて抽出され、因果的アテンション機構を活用して先行コンテキストからの情報を自然に集約します。131K トークンのコンテキストウィンドウは、調整済みベース周波数のロータリー位置埋め込みにより実現されます。訓練は 3 段階の漸進的カリキュラムを使用し、InfoNCE、分散損失(重み 0.45)、デュアルマッチング損失(重み 0.85)、類似損失を組み合わせる多目的損失を適用します。
パフォーマンス
BEIR では、モデルは 61.94 NDCG{'@'}10 を達成し、評価されたすべてのリーランカー中最高で、jina-reranker-v2 に対し 4.88% の向上です。マルチホップ検索(HotpotQA で 78.56)と事実検証(FEVER で 93.95)に強みがあります。多言語性能は 18 言語で MIRACL 66.50 に達し、アラビア語が 78.69、タイ語が 81.06 です。コード検索は CoIR で 63.28 を達成します。パラメータ数を 2.5 分の 1 に抑えながら、1.5B の mxbai-rerank-large(61.44)を上回ると同時に、同サイズの bge-reranker-v2-m3 に対し 5.43% の向上を示します。性能は文書順序に対して比較的安定です:ランダム(62.54)、降順(61.94)、昇順(61.52)——候補の順序に依存しない頑健なリストワイズスコアリングを示しています。
ベストプラクティス
埋め込みの抽出には、system/user/assistant ロールと特別トークンを持つ構造化プロンプトテンプレートを使用してください。131K コンテキストを超えるコレクションには、1 フォワードパスにつき最大 64 文書を処理してください。文書をランダムまたは関連性の降順で順序付けた場合が最適です(性能差は 1% 未満)。比較ランキングタスクには文書間の相互作用能力を利用してください——モデルのリストワイズ設計は、ペアワイズスコアリングが見逃す候補間の関係を捉えます。多言語アプリケーションでは、モデルは 18 言語にわたって強力なゼロショット転移を提供します。大規模文書セットにはバッチ処理を実装し、クエリ埋め込みをバッチ間で一貫して保持してください。256 次元の出力埋め込みは効率的な類似度計算を支援します。マルチホップ推論と事実検証タスクに最適です。本番環境では、ハイブリッドアテンションによる 1.22–1.56 倍の高速推論を実現する jina-reranker-v3.5 を使用してください。