


Embeddings
검색, RAG, 에이전트 애플리케이션을 위한 최고 성능의 멀티모달·다국어·긴 컨텍스트 임베딩입니다.
임베딩 API
검색 및 RAG 시스템을 개선하려면 저희 임베딩 모델을 사용해 보세요. 무료 체험으로 시작하세요!
curl "https://api.jina.ai/v1/embeddings" \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $JINA_API_KEY" \
  -d @- <<EOFEOF
{
  "model": null,
  "normalized": true,
  "embedding_type": "float",
  "input": [
    text_fieldsclose"Organic skincare for sensitive skin with aloe vera and chamomile: Imagine the soothing embrace of na…ing, healthy complexion.",
    text_fieldsclose"Bio-Hautpflege für empfindliche Haut mit Aloe Vera und Kamille: Erleben Sie die wohltuende Wirkung u…einen strahlenden Teint.",
    text_fieldsclose"Cuidado de la piel orgánico para piel sensible con aloe vera y manzanilla: Descubre el poder de la n…el radiante y saludable.",
    text_fieldsclose"针对敏感肌专门设计的天然有机护肤产品:体验由芦荟和洋甘菊提取物带来的自然呵护。我们的护肤产品特别为敏感肌设计,温和滋润,保护您的肌肤不受刺激。让您的肌肤告别不适,迎来健康光彩。",
    text_fieldsclose"新しいメイクのトレンドは鮮やかな色と革新的な技術に焦点を当てています: 今シーズンのメイクアップトレンドは、大胆な色彩と革新的な技術に注目しています。ネオンアイライナーからホログラフィックハイライターまで、クリエイティビティを解き放ち、毎回ユニークなルックを演出しましょう。"
    + 입력 추가
  ]
}
EOFEOFv5-omni: 하나의 임베딩으로 모든 것을
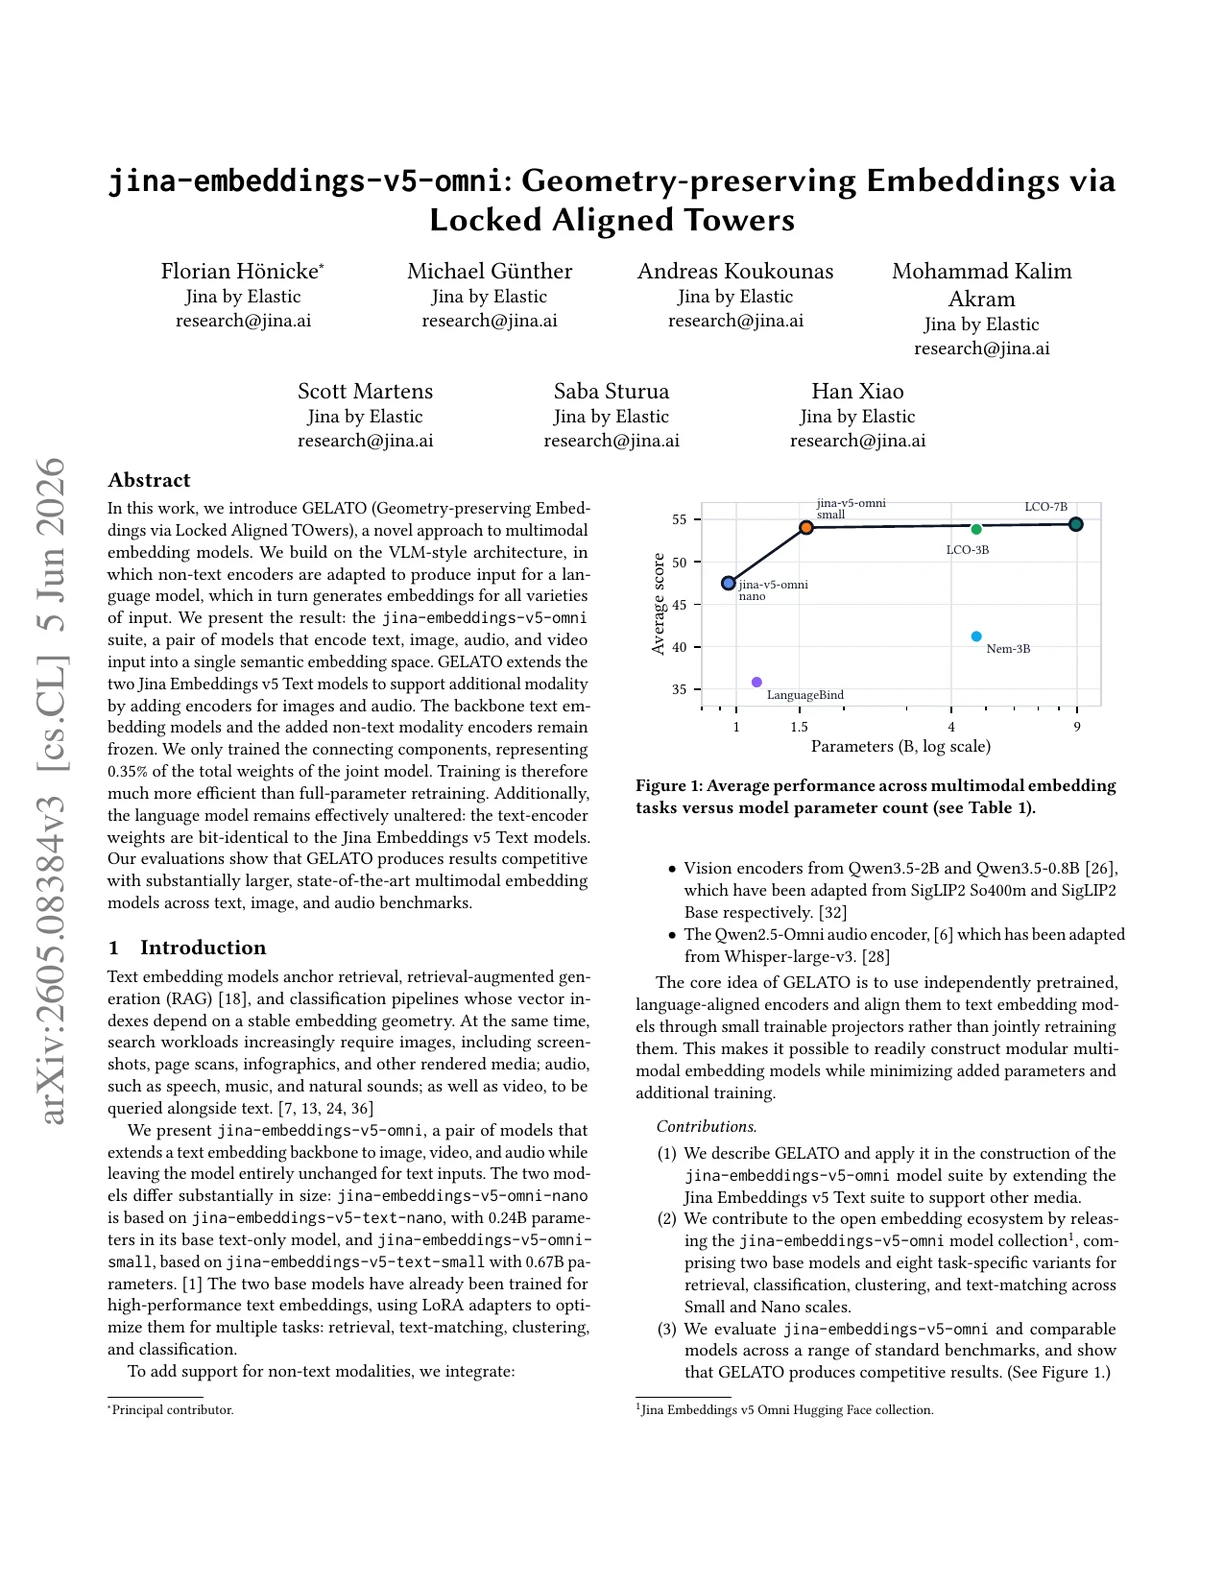
텍스트, 이미지, 오디오, 동영상을 하나의 공유 임베딩 공간에 담고, 두 가지 크기로 제공합니다. v5-omni-small(약 1.74B)은 20억 개 미만 파라미터의 오픈 웨이트 omni 모델 중 가장 성능이 좋습니다. v5-omni-nano(약 1.04B)는 10억 개 미만에서 경쟁력 있는 검색 성능을 냅니다. 두 모델 모두 v5-text와 바이트 단위까지 호환되므로 재인덱싱이 필요 없습니다.
v5-text: 새로운 SOTA 소규모 다국어 임베딩
jina-embeddings-v5-text는 677M small과 239M nano 두 가지 효율적인 크기로 5세대 임베딩 품질을 제공하며, 작업별 LoRA 어댑터, Matryoshka 차원, small 모델 32K·nano 모델 8K 컨텍스트, 엣지 배포를 위한 GGUF/MLX 양자화를 갖춰 MMTEB, MTEB 영어, 검색 작업에서 새로운 벤치마크를 세웁니다.
구매 방법 두 가지
저희 API를 구독하시거나 클라우드 서비스 제공업체를 통해 구매하세요.
radio_button_unchecked
cloud
3개 클라우드 서비스 제공업체와 협력
AWS 또는 Azure를 사용하고 계신가요? 저희 모델을 회사의 클라우드 플랫폼에 직접 배포하고 CSP 계정을 통해 비용을 청구할 수 있습니다.
radio_button_checked

Jina Search Foundation API 사용
저희 모든 제품에 접근할 수 있는 가장 쉬운 방법입니다. 필요할 때마다 토큰을 충전하세요.
key
verified_user
더 많은 토큰으로 이 API 키를 충전하세요
재충전하려면 올바른 API 키를 입력하세요.
speed
속도 제한 이해하기
속도 제한은 IP 주소 또는 API 키별로 1분 동안 API에 보낼 수 있는 요청 수(RPM)와 토큰 수(TPM)의 상한입니다. 제품 및 등급별 한도는 아래에서 확인하세요.
keyboard_arrow_down

온프레미스 배포
AWS SageMaker 및 Microsoft Azure와 곧 Google Cloud Services에 Jina Embeddings 모델을 배포하거나 영업팀에 문의하여 가상 프라이빗 클라우드 및 온프레미스 서버에 대한 맞춤형 Kubernetes 배포를 받으세요.
 AWS SageMaker
 Embeddings
 Reranker
 Microsoft AzureEmbeddingsReranker
 Google CloudEmbeddings

API 통합
저희 Embedding API는 다양한 유명 데이터베이스, 벡터 스토어, RAG 및 LLMOps 프레임워크와 네이티브로 통합되어 있습니다. 시작하려면 나열된 통합 중 하나에 API 키를 복사하여 붙여넣기만 하면 빠르고 원활하게 사용할 수 있습니다.
벡터 스토어
LLMOps
RAG
관측 가능성

MongoDB

DataStax

Qdrant

Pinecone

Chroma

Weaviate
Milvus

Epsilla

MyScale

LlamaIndex

Haystack

Langchain

Dify

SuperDuperDB
%20rotate(-89.93)'/%3e%3crect%20class='cls-1'%20x='30.52'%20y='10.19'%20width='3'%20height='47.42'%20transform='translate(-13.3%2044.91)%20rotate(-60.3)'/%3e%3ccircle%20id='_椭圆形'%20class='cls-1'%20cx='28.91'%20cy='31.28'%20r='5'/%3e%3cpolygon%20class='cls-1'%20points='42.43%2030.75%2035.08%2029.1%2036.37%2021.5%2039.33%2022.01%2038.51%2026.8%2043.09%2027.82%2042.43%2030.75'/%3e%3cpolygon%20class='cls-1'%20points='16.75%2045.55%209.43%2043.77%2010.86%2036.19%2013.8%2036.75%2012.9%2041.53%2017.46%2042.63%2016.75%2045.55'/%3e%3cpolygon%20class='cls-1'%20points='11.02%2028.19%209.54%2020.8%2017.01%2018.89%2017.75%2021.8%2013.04%2023%2013.96%2027.6%2011.02%2028.19'/%3e%3c/g%3e%3c/g%3e%3c/g%3e%3c/svg%3e)
DashVector
Portkey

Baseten

TiDB
LanceDB

Carbon
저희 논문
최첨단 검색 모델이 어떻게 처음부터 학습되는지 알아보고 최신 논문도 확인해 보세요. EMNLP, SIGIR, ICLR, NeurIPS, ICML에서 저희 팀을 만나보세요!
EMNLP 2026
10월 06, 2026
NeurIPS 2026
9월 02, 2026
NeurIPS 2026
8월 06, 2026
NeurIPS 2026
7월 20, 2026
SIGIR 2026
5월 11, 2026
SIGIR 2026
2월 17, 2026
ICLR 2026
1월 22, 2026
 arXiv
12월 29, 2025
ICLR 2026
12월 04, 2025
AAAI 2026
10월 01, 2025
NeurIPS 2025
8월 31, 2025
EMNLP 2025
6월 24, 2025
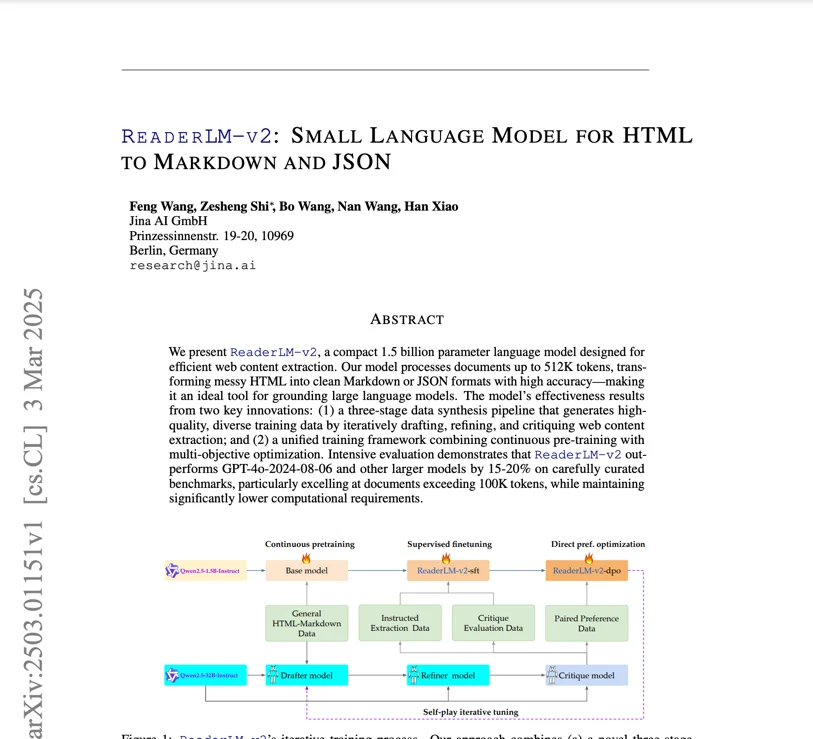
ICLR 2025
3월 04, 2025
ACL 2025
12월 17, 2024
ICLR 2025
12월 12, 2024
ECIR 2025
9월 18, 2024
SIGIR 2025
9월 07, 2024
EMNLP 2024
8월 30, 2024
WWW 2025
6월 21, 2024
ICML 2024
5월 30, 2024
 arXiv
2월 26, 2024
 arXiv
10월 30, 2023
EMNLP 2023
7월 20, 2023
총 논문 23편.
임베딩 알아보기
임베딩은 어디서부터 시작해야 할까요? 저희가 도와드립니다. 종합 가이드에서 임베딩을 처음부터 자세히 알아보세요.




리랭커, 벡터 검색, BM25 비교
아래 표는 리랭커, 벡터/임베딩 검색, BM25를 종합적으로 비교하여 여러 범주에서의 강점과 약점을 보여줍니다.
| 리랭커 | 벡터 검색 | BM25 | |
|---|---|---|---|
| 가장 적합한 용도 | 향상된 검색 정밀도 및 관련성 | 초기, 빠른 필터링 | 광범위한 쿼리에 대한 일반 텍스트 검색 |
| 세분화 수준 | 상세: 하위 문서 및 쿼리 세그먼트 | 광범위: 전체 문서 | 중간: 다양한 텍스트 조각 |
| 쿼리 시간 복잡도 | 높음 | 보통 | 낮음 |
| 인덱스 시간 복잡도 | 불필요 | 높음 | 낮음, 사전 구축된 인덱스 활용 |
| 훈련 시간 복잡도 | 높음 | 높음 | 불필요 |
| 검색 품질 | 미묘한 뉘앙스의 쿼리에 탁월함 | 효율성과 정확성 사이의 균형 | 다양한 쿼리에 대해 일관되고 안정적임 |
| 강점 | 깊은 맥락 이해로 매우 정확함 | 적당한 정확도로 빠르고 효율적 | 검증된 효과와 함께 확장성이 뛰어남 |
| Reranker API 무료로 사용해 보기 | Embedding API 무료로 사용해 보기 |
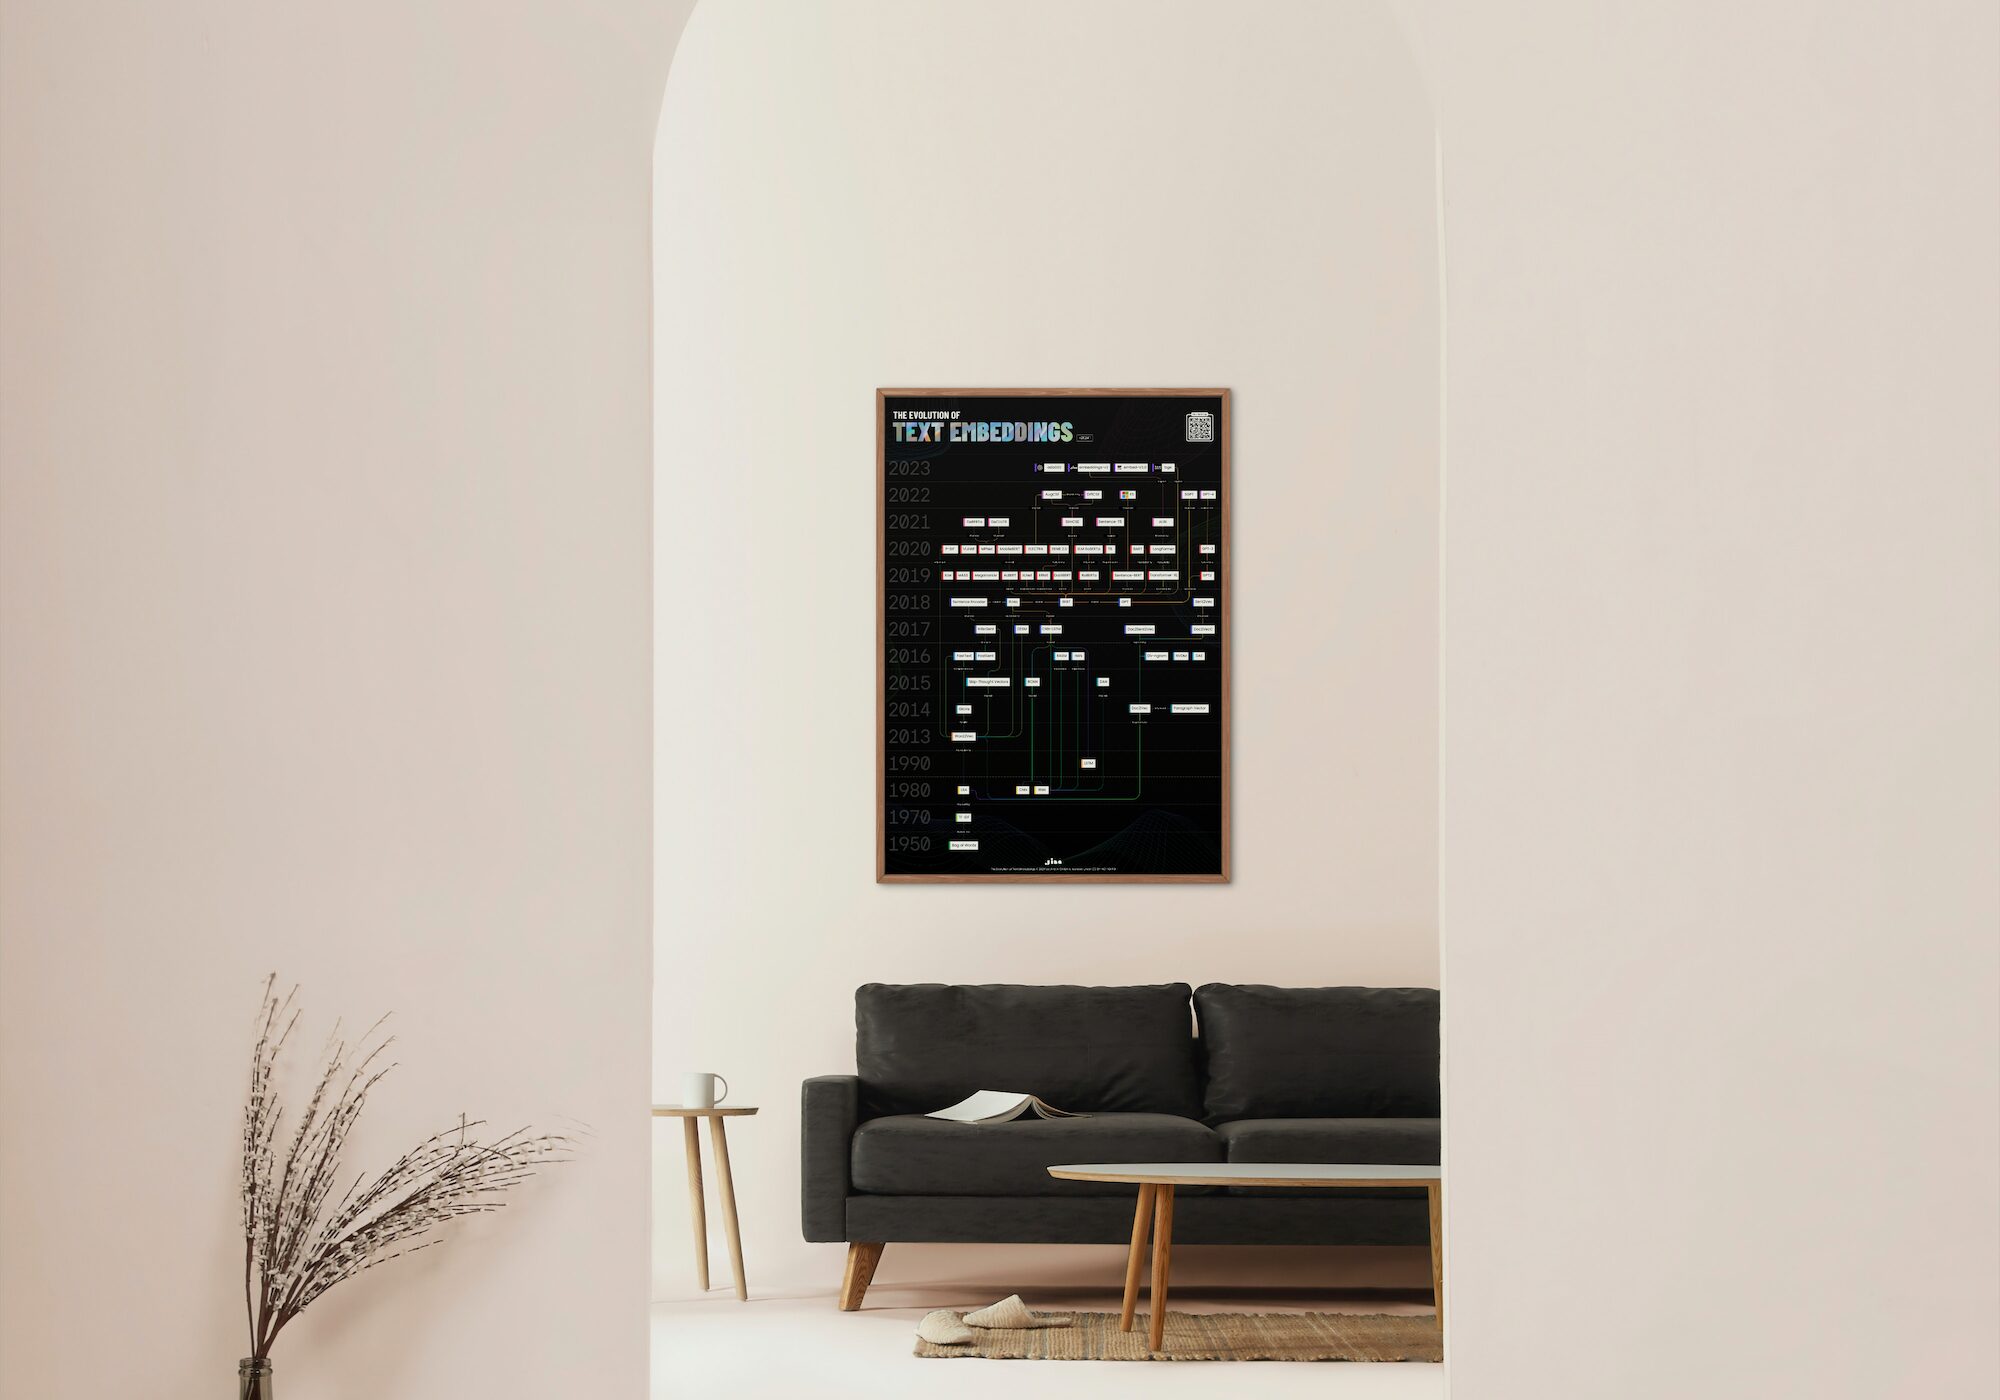
임베딩의 진화 포스터
1950년 이후 텍스트 임베딩 모델의 진화를 담은 인포그래픽과 비주얼로, 공간에 어울리는 포스터를 찾아보세요.
Jina 임베딩 모델은 어떻게 학습되었나요?
keyboard_arrow_down
멀티모달 임베딩 모델에는 어떤 것이 있나요?
keyboard_arrow_down
Jina 모델은 어떤 언어를 지원하나요?
keyboard_arrow_down
단일 입력에 대한 최대 컨텍스트 길이는 얼마입니까?
keyboard_arrow_down
하나의 요청에 포함될 수 있는 최대 입력값 개수는 몇 개입니까?
keyboard_arrow_down
이미지, 오디오, 동영상 또는 PDF 파일을 멀티모달 모델로 전송하려면 어떻게 해야 하나요?
keyboard_arrow_down
Jina 임베딩은 최신 OpenAI, Cohere 및 Voyage 모델과 비교했을 때 어떤 차이가 있습니까?
keyboard_arrow_down
OpenAI의 text-embedding-3-large에서 Jina 모델로 옮기는 것이 얼마나 매끄러운가요?
keyboard_arrow_down
이미지와 기타 텍스트가 아닌 입력의 토큰은 어떻게 계산되나요?
keyboard_arrow_down
이미지, 오디오, 동영상을 임베딩하는 모델을 제공하나요?
keyboard_arrow_down
Jina 임베딩 모델은 개인 데이터나 기업 데이터에 맞춰 미세 조정할 수 있나요?
keyboard_arrow_down
해당 모델을 비공개로 호스팅할 수 있나요? 예를 들어, 제 자체 인프라나 클라우드 계정에 호스팅할 수 있나요?
keyboard_arrow_down
‘task’ 매개변수란 무엇이며 언제 사용해야 하나요?
keyboard_arrow_down
레이트 인터랙션(Late-interaction) 검색이란 무엇이며 어떤 모델이 지원하나요?
keyboard_arrow_down
Late Chunking이란 무엇인가요? 어떤 상황에서 사용해야 하나요?
keyboard_arrow_down
API에서 강제하는 컨텍스트 길이가 모델에서 지원하는 컨텍스트 길이와 다른 이유는 무엇인가요?
keyboard_arrow_down
jina-embeddings-v4는 무료인데 왜 이렇게 느린가요?
keyboard_arrow_down
임베딩 API의 사용량 제한은 얼마인가요?
keyboard_arrow_down
어떤 임베딩 모델을 선택해야 할까요?
keyboard_arrow_down
이미지 및 PDF 파일의 크기 제한은 어떻게 되나요?
keyboard_arrow_down
속도 제한
속도 제한은 두 가지 방식으로 추적됩니다. RPM(분당 요청 수)과 TPM(분당 토큰 수)입니다. 제한은 IP 또는 API 키별로 적용되며, RPM 또는 TPM 임계값에 도달하는 즉시 적용됩니다. 요청 헤더에 API 키를 제공하면 IP 주소 대신 키별로 속도 제한을 추적합니다.
| 제품 | API 엔드포인트 | 설명arrow_upward | API 키 미사용 시key_off | 무료 API 키 사용 시key | 유료 API 키 사용 시key | 프리미엄 API 키 사용 시key | 평균 지연 | 토큰 사용량 계산 | HTTP 메서드 | |
|---|---|---|---|---|---|---|---|---|---|---|
| Reader API | https://r.jina.ai | URL을 LLM 친화적인 텍스트로 변환 | 20 RPM | 500 RPM | 500 RPM | trending_up5000 RPM | 7.9s | 출력 응답의 토큰 수를 기준으로 합니다. | GET/POST | |
| Reader API | https://s.jina.ai | 웹 검색 후 결과를 LLM 친화적인 텍스트로 변환 | block | 100 RPM | 100 RPM | trending_up1000 RPM | 2.5s | 모든 요청은 10,000개부터 시작하는 고정 토큰 수를 사용합니다. | GET/POST | |
| Reranker API | https://api.jina.ai/v1/rerank | 쿼리 기준으로 문서 순위 매기기 | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart 입력 크기에 따라 다름 help | 입력 요청의 토큰 수를 기준으로 합니다. | POST | |
| 임베딩 API | https://api.jina.ai/v1/embeddings | 텍스트/이미지를 고정 길이 벡터로 변환 | block | 100 RPM & 100,000 TPM | 500 RPM & 2,000,000 TPM | trending_up5,000 RPM & 50,000,000 TPM | ssid_chart 입력 크기에 따라 다름 help | 입력 요청의 토큰 수를 기준으로 합니다. | POST |
CC BY-NC 라이선스 자가 점검
play_arrow
저희 관리형 API를 사용하고 계신가요, 아니면 Azure, AWS 또는 GCP의 공식 이미지를 사용하고 계신가요?
play_arrow
예
play_arrow
아니오
API 관련 자주 묻는 질문
code
Jina의 모든 API에서 동일한 API 키를 사용할 수 있나요?
keyboard_arrow_down
code
API 키의 토큰 사용량을 볼 수 있나요?
keyboard_arrow_down
code
API 키를 잊어버린 경우 어떻게 해야 하나요?
keyboard_arrow_down
code
API 키가 만료되나요?
keyboard_arrow_down
code
API 키 간에 토큰 잔액을 전송할 수 있나요?
keyboard_arrow_down
code
내 API 키를 파기할 수 있나요?
keyboard_arrow_down
code
일부 모델의 첫 요청이 느린 이유는 무엇인가요?
keyboard_arrow_down
code
제 API 데이터가 모델 학습에 사용되나요?
keyboard_arrow_down
code
Jina API의 속도 제한은 어떻게 되나요?
keyboard_arrow_down
code
API에 배치 크기 제한이 있나요?
keyboard_arrow_down
code
Jina API는 Elastic 내 Jina 모델과 같은 것인가요?
keyboard_arrow_down
결제 관련 자주 묻는 질문
attach_money
API 요금은 문장 수나 요청 수에 따라 청구되나요?
keyboard_arrow_down
attach_money
신규 사용자가 무료 평가판을 받을 수 있나요?
keyboard_arrow_down
attach_money
실패한 요청에 대해 토큰이 차감되나요?
keyboard_arrow_down
attach_money
어떤 결제 방법을 지원하나요?
keyboard_arrow_down
attach_money
토큰 구매 시 송장을 발행받을 수 있나요?
keyboard_arrow_down
attach_money
API 토큰 대신 상업용 라이선스를 구매하려면 어떻게 해야 하나요?
keyboard_arrow_down
attach_money
신용카드 대신 송장이나 구매 주문서로 결제할 수 있나요?
keyboard_arrow_down
attach_money
결제는 완료했는데 잔액이나 속도 제한이 그대로입니다. 무엇을 확인해야 하나요?
keyboard_arrow_down
attach_money
해지, 자동 충전 중지, 저장된 결제 수단 삭제는 어떻게 하나요?
keyboard_arrow_down
