Reader
LM-v2
 Reader API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 망분리
개요
ReaderLM-v2는 1.54B 파라미터의 소형 언어 모델로, 지저분한 HTML을 높은 정확도로 깔끔한 Markdown 또는 JSON으로 변환하며 최대 512K 토큰의 문서를 처리합니다. 대규모 언어 모델의 그라운딩에 이상적인 도구입니다: 웹 콘텐츠를 LLM이 효율적으로 소비할 수 있는 구조화된 형식으로 변환합니다. HTML을 Markdown으로 변환하는 작업에서 Qwen2.5-32B-Instruct와 Gemini2-flash-expr를 능가하면서도 비용은 그 일부에 불과합니다.
방법
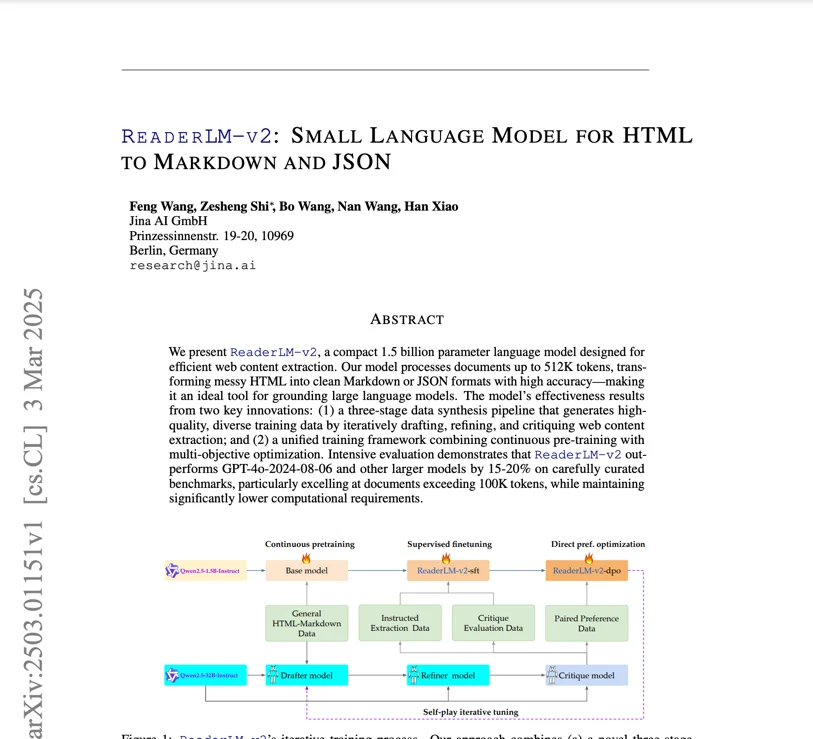
이 모델의 효과는 두 가지 핵심 혁신에서 나옵니다. 첫째, 3단계 데이터 합성 파이프라인이 웹 콘텐츠 추출을 반복적으로 작성·정제·비평해 고품질의 다양한 학습 데이터를 생성합니다 — 이 합성 데이터 방식은 수동 어노테이션 없이도 모델이 다양한 HTML 구조를 접하게 합니다. 둘째, 통합 학습 프레임워크가 지속적 사전학습과 다목적 최적화를 결합해, 모델이 HTML에서 Markdown으로의 변환과 HTML에서 JSON으로의 변환을 동시에 학습할 수 있게 합니다. ‘shallow-but-wide’(얕고 넓은) 디코더 전용 아키텍처(레이어 28개, 은닉 차원 1536개, 쿼리 헤드 12개, KV 헤드 2개)는 선택적 복사 작업에 최적화되어 있습니다. 512K 토큰 컨텍스트는 zigzag-ring-attention으로 구현됩니다. 대비 손실 학습은 퇴화 문제를 크게 줄입니다.
성능
HTML-대-Markdown 작업에서 이 모델은 ROUGE-L 0.84, Jaro-Winkler 0.82, Levenshtein 거리 0.22를 달성하며 Qwen2.5-32B-Instruct와 Gemini2-flash-expr를 능가합니다. HTML-대-JSON 작업에서는 F1 점수 0.81과 98% 통과율로 경쟁적인 성능을 유지합니다. T4 GPU에서 입력 67 tokens/s, 출력 36 tokens/s로 처리합니다. 퇴화 문제(토큰 루프, 반복 출력)는 대비 손실 훈련으로 크게 줄었습니다. 512K 토큰 컨텍스트 윈도우는 대부분의 실제 문서에서 청킹(chunking)을 불필요하게 만듭니다.
모범 사례
이 모델은 HTML에서 Markdown으로의 변환, JSON 추출, 지시 수행을 보여주는 Google Colab 노트북으로 사용할 수 있습니다. HTML을 Markdown으로 변환할 때는 접두사 지시 없이 원시 HTML을 입력하세요. JSON 추출에는 프롬프트에 대상 스키마를 지정하세요. create_prompt 헬퍼 함수가 두 작업의 프롬프트 작성을 도와줍니다. 이 모델은 Colab의 무료 T4 GPU 티어에서 동작하지만(vLLM과 Triton 필요), bfloat16이나 Flash Attention 2를 지원하지 않으면 제약이 있습니다. 프로덕션에는 RTX 3090/4090을 권장합니다. AWS SageMaker, Azure, GCP 마켓플레이스에서 사용할 수 있습니다. 비상업적 용도로 CC-BY-NC 4.0 라이선스가 적용됩니다. 이 모델을 RAG 파이프라인의 전처리 단계로 사용해, jina-embeddings-v5-text-small로 임베딩하기 전에 웹 콘텐츠를 깔끔한 Markdown으로 변환하세요.